 NexAIX-官方博客
很多人以为按量计费AI API的月度成本只要算清输入和输出 token 量就够了,但这样得出的预算往往与实际账单差出一大截。真正的按量计费AI API月度成本公式至少包含四个维度:输入缓存未命中、输入缓存命中、输出,以及调用时段——前三者决定单价基准,第四个维度则可能让同样一批请求的最终费用相差两倍。以 DeepSeek 自 2026 年 8 月 16 日 16:00 UTC 起执行的 V4 系列分时定价为参照,时段已经从纸面概念变成必须纳入核算的现实项。
按量计费AI API的单价表怎么读:四个维度如何组合
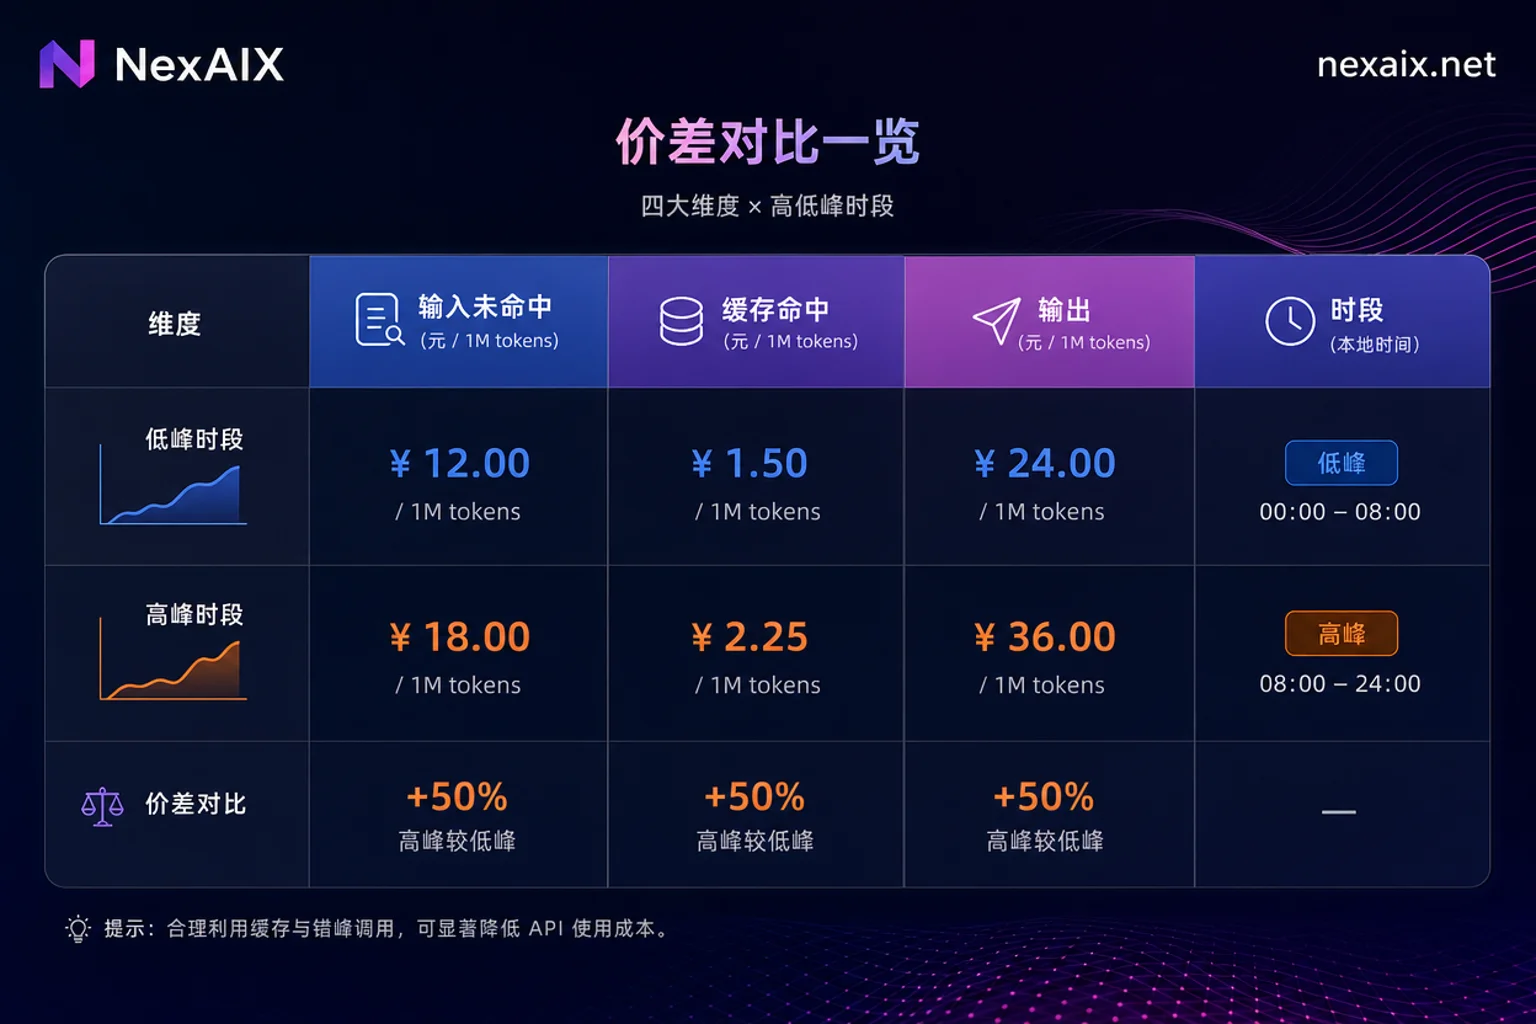
一张按量计费AI API的价格页,往往不是一个数字,而是一个四维矩阵。以 DeepSeek 官方定价为例,你需要同时看四列:缓存未命中输入、缓存命中输入、输出,以及它们各自在高峰和平峰下的取值。缓存命中与未命中的单价通常相差一个数量级,而高峰与平峰则是 2 倍量级,两者是相乘关系,不是二选一。
把任意厂商的价格页填进下面这个通用模板,就能得到单位请求成本:
单位成本 = 输入未命中token数 × 未命中单价 + 输入命中token数 × 命中单价 + 输出token数 × 输出单价,再乘以对应时段的系数。
以 DeepSeek-V4 系列分时定价做一次量级演算
2026 年 8 月 13 日,DeepSeek 官方发布 V4-Pro GA,并同步公布分时计费规则:自 2026 年 8 月 16 日 16:00 UTC 起,高峰时段为 01:00-04:00 与 06:00-10:00 UTC(共 7 小时),其余 17 小时为平峰。以上时段与单价来自 DeepSeek API 官方定价文档(2026-08-14 版)。
| 模型 | 时段 | 缓存未命中输入 ($/1M) | 输出 ($/1M) | 缓存命中输入 ($/1M) |
|---|---|---|---|---|
| deepseek-v4-pro | 高峰 | 1.32 | 3.96 | 0.044(按平峰×2 推算,官方未单列,以定价页为准) |
| deepseek-v4-pro | 平峰 | 0.66 | 1.98 | 0.022 |
| deepseek-v4-flash | 高峰 | 0.44 | 1.32 | 0.014(按平峰×2 推算,官方未单列,以定价页为准) |
| deepseek-v4-flash | 平峰 | 0.22 | 0.66 | 0.007 |
注:缓存命中单价官方定价文档仅公布平峰价(pro $0.022/1M、flash $0.007/1M);上表高峰命中价为按平峰×2 推算的示例值,实际以官方定价页为准。
假设一个团队每月产生 100M 输入(缓存命中率 50%,未命中 50%)和 50M 输出,全部使用 v4-pro,我们对比三种调度情形(以下为示例假设,非官方数据):
| 调度情形 | 输入未命中成本 | 缓存命中成本(按平峰命中价×2 推算) | 输出成本 | 月度总计 |
|---|---|---|---|---|
| 全部落在高峰 | $66 | $2.2(推算) | $198 | $266.2 |
| 全部落在平峰 | $33 | $1.1 | $99 | $133.1 |
| 混合(约 1/3 高峰) | $44 | $1.47(推算) | $132 | $177.47 |
可见,仅靠时段调度,就可能节省 30%-50% 的成本。这里要澄清一个传播偏差:部分媒体用“全天涨价 3~4 倍”概括此事,实际上涨幅只集中在上面列出的 UTC 窗口,平峰价格是高峰的 50%,且缓存命中折扣仍然保留。在这组示例假设下,把全部可调度请求从高峰移至平峰,理论节省上限为 50%;实际可节省比例取决于可延迟链路在总调用量中的占比,多数生产链路会明显低于该上限。
把请求分成三类:实时、可延迟、批处理
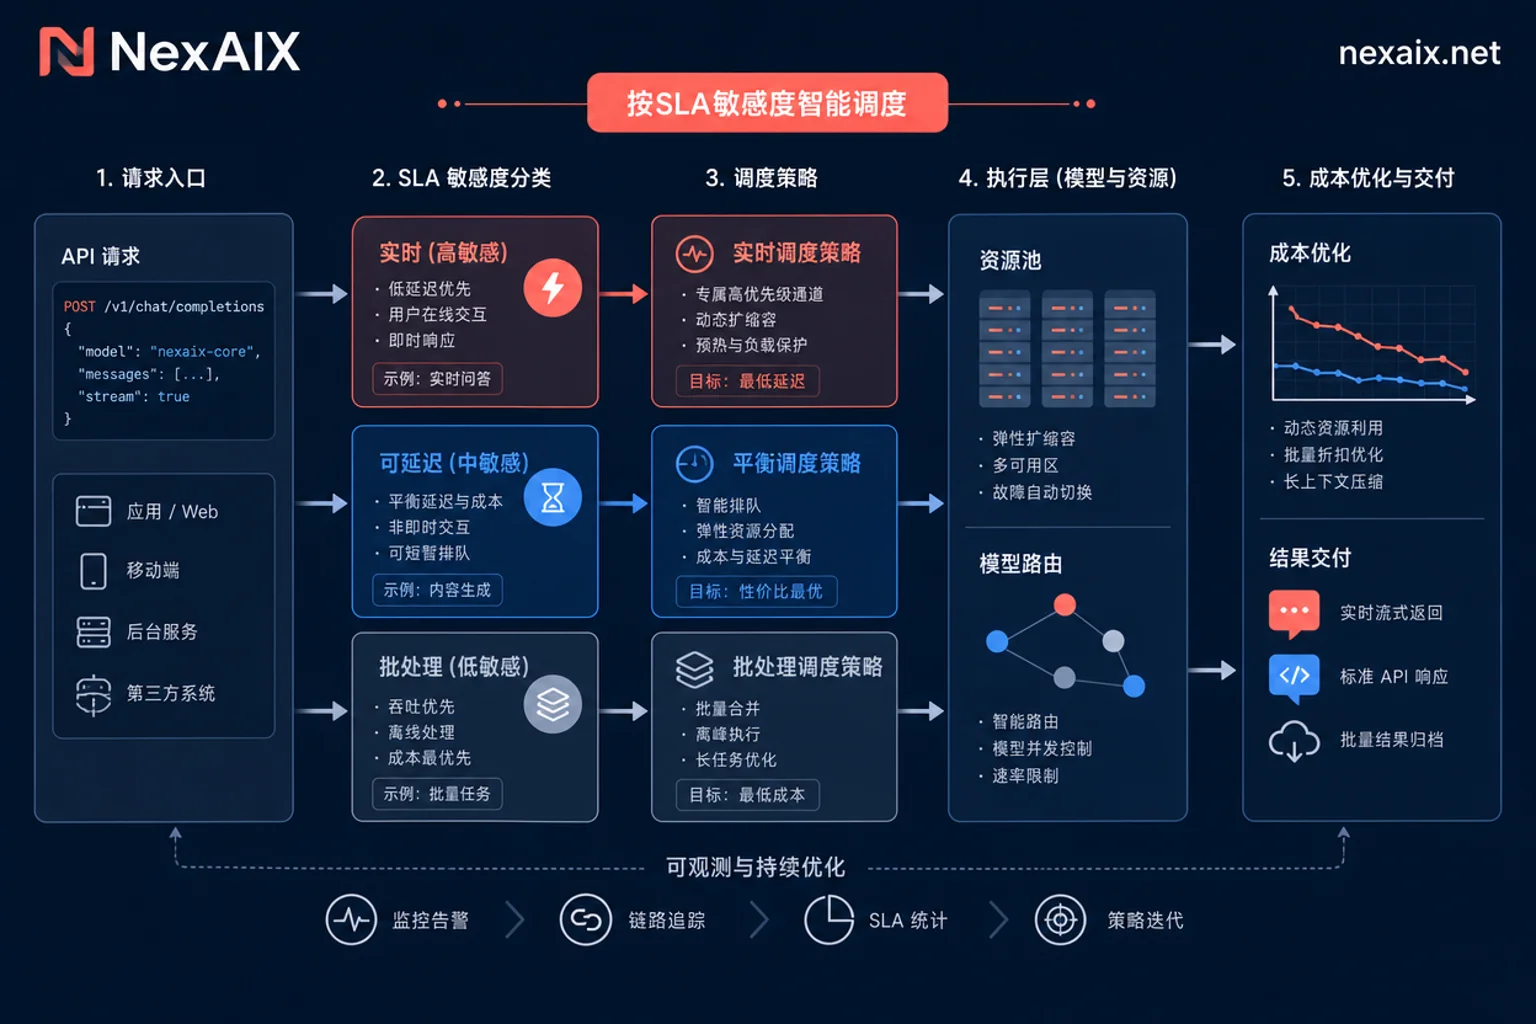
按量计费AI API的调度收益只对特定请求类型成立,先按 SLA 敏感度分层:
- 实时链路:用户在等,必须同步返回,例如聊天机器人、代码补全。判据:是否有用户在同步等待。
- 可延迟链路:分钟到小时级容忍,例如异步摘要、离线标注补跑。判据:是否存在合同 SLA?
- 批处理链路:24 小时级容忍,例如知识库向量化、评估集回归。判据:任务是否可幂等重放。
只有后两类才有资格参与时段调度。批处理链路通常还可叠加厂商的 Batch API 异步折扣(如 OpenAI 提供标准 50% 折扣,要求 24 小时窗口交付),这属于额外的降本空间。但 Batch 的 50% 折扣需 24 小时交付窗口,与平峰单价减半属于两条并行路径,不可假定二者叠加。
时区陷阱:计价窗口按 UTC,业务高峰按本地时区
最容易踩的坑是:定价窗口以 UTC 定义,而业务负载曲线按本地时区分布。DeepSeek 的高峰窗口 01:00-04:00 与 06:00-10:00 UTC,对应的北京时间是 09:00-12:00 与 14:00-18:00——恰好是国内多数企业的业务高峰。如果调度器用服务器本地时间判断档位,很容易把请求打在最贵的时间段。
实现建议:统一用 UTC 时间戳判定档位,不依赖服务器本地时区;对于跨窗口的长任务,请求发起时间与计费归属需按官方口径确认,不确定处以官方文档为准。
可延迟链路怎么落地:队列、重试预算与截止时间约束
工程实现上,任务入队时带上 deadline 与档位偏好;调度器在平峰窗口开闸消费。需要为每个任务设置重试预算,否则一次重试可能把任务推出平峰窗口,反而更贵。异步 Batch 通道有 24 小时交付约束,若队列积压过深,隐性延迟成本可能抵消节省的费用。
缓存命中折扣和时段折扣怎么叠加
结论是:两者同时生效。官方定价文档显示缓存命中计费与时段计费同时生效。平峰期缓存命中的输入单价可低至 v4-pro 的 $0.022/1M、v4-flash 的 $0.007/1M。优化优先级上,高频复用的系统提示词应优先提升缓存命中率,因为收益是数量级;时段调度是第二层收益,约 2 倍量级。两者不冲突,但先用缓存优化,再谈时段调度。
什么情况下不该为省钱挪时段
实时交互链路、Agent 多轮工具调用中的关键跳、有合同 SLA 的对外接口,都不应参与调度。集中在平峰窗口猛灌请求会推高并发,触发限速与重试放大,实际成本未必下降。还要把工程复杂度和值班成本计入折算——如果为了省 30% 的成本要投入大量开发与运维精力,可能并不划算。
换模型档位 vs 换调用时段
两条降本路径适用场景不同:换档位(如从 v4-pro 降到 v4-flash)改变输出质量上限,需要通过 eval 验证;换时段不改变质量,只改变交付时间。建议先用 eval 确认任务能否降档,不能降档再考虑挪时段。要做跨模型的时段与成本对照,前提是同一套代码能在多家供应商和多个模型间切换,例如 NexAIX 提供的 OpenAI Chat Completions 兼容接口(base_url: https://api.nexaix.net/v1),可以用同一份 eval 脚本在不同档位下测试。AI API价格 和 AI API成本优化 可作延伸阅读。
按量计费AI API月度成本重算清单:8 项当周可执行核对项
下面 8 项用于重算按量计费AI API 的月度账单。
- 导出 usage 明细,按 UTC 小时分桶。
- 核对请求 ID、模型名、token 数、时间戳与账单条目的对应关系。
- 确认返回体的 model 字段与预期模型一致,防止暗降级导致账单口径错乱。核对所需字段依赖服务商保留的计费元数据,例如 NexAIX 公开只保留请求 ID、模型名、token 数、时间戳与状态码,正好可用于把账单条目回溯到具体调用时段;满载时返回标准 429 而不静默切换模型,返回体 model 字段对应实际执行模型。
- 标记缓存命中率,评估优化空间。
- 识别可延迟链路占比,估算可调度范围。
- 为高峰窗口设置调用告警。
- 复核重试放大系数,避免重试推高成本。
- 为每条链路写明 SLA 与档位归属。
关于账单与 usage 对不上的问题,可参考 AI API 429 排查重试与限流,以及 OpenAI兼容API 理解模型字段一致性。
常见问题
DeepSeek API 高峰期和平峰期价格差多少?
高峰时段输出单价是平峰的 2 倍。例如 v4-pro 高峰输出 $3.96/1M,平峰 $1.98/1M;v4-flash 高峰 $1.32,平峰 $0.66。输入未命中单价同样是平峰减半。
分时计价的时段是按 UTC 还是本地时区?
按 UTC 定义。DeepSeek 高峰窗口为 01:00-04:00 和 06:00-10:00 UTC,对应北京时间 09:00-12:00 和 14:00-18:00。调度器需使用 UTC 时间戳判定档位,避免本地时区导致误判。
AI API 调用能不能挪到夜里跑省钱?
可以,但仅对非实时链路有效。将可延迟任务调度到平峰窗口(如北京时间凌晨),对应时段单价最多可降至一半,实际节省比例受可调度请求占比限制。
批处理任务用哪个模型档位更划算?
若对质量不敏感,优先选 flash 档位,平峰时输入 $0.22/1M、输出 $0.66/1M,成本约为 pro 的三分之一。但需用 eval 验证输出质量是否满足需求。
API 账单和 usage 对不上怎么核?
逐项核对请求 ID、模型名、token 数和时间戳。注意确认返回体 model 字段是否与预期一致,防止暗降级导致的账单差异;同时排查重试放大造成的额外消耗。
prompt cache 折扣和时段折扣能叠加吗?
能。两者独立生效,平峰期缓存命中输入单价可低至 $0.022/1M(pro)和 $0.007/1M(flash)。优化时应先最大化缓存命中,再考虑时段调度。



评论(0)