 NexAIX-官方博客
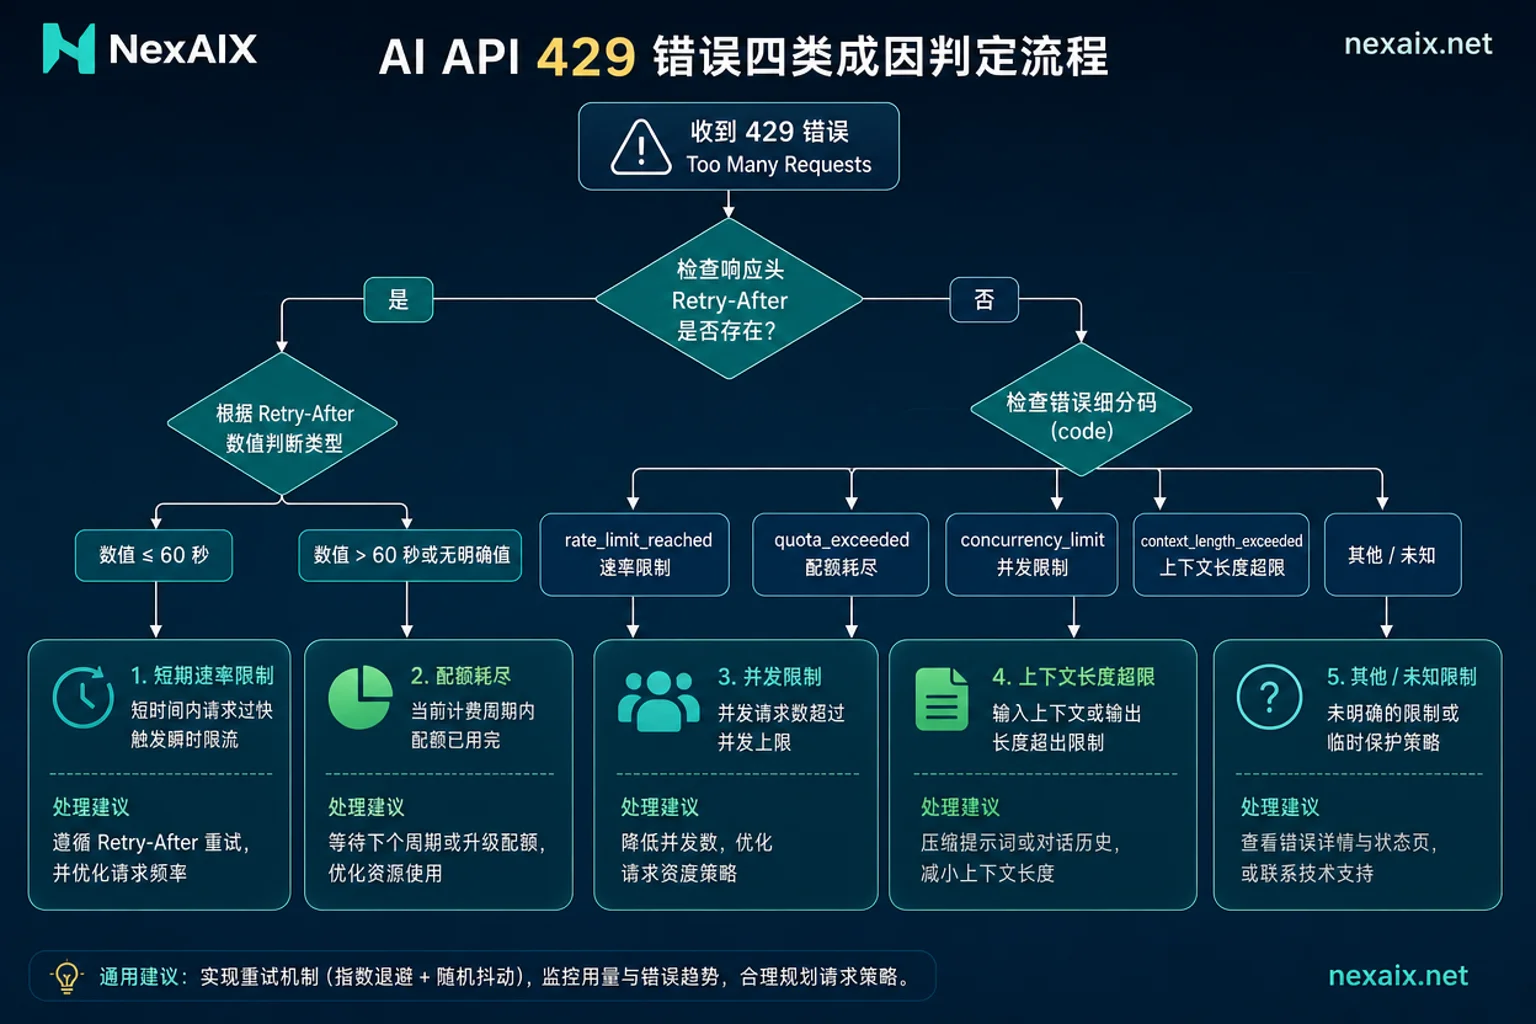
处理 AI API 429 报错,先记住一条原则:不要一律加重试,而是先按三个字段把这 429 分到四类成因里,再决定是改代码、加档位还是充值。OpenAI 官方在 2026 年文档中把 429 拆成了限流、项目消费上限、预付费余额耗尽三种错误体,DeepInfra 则在 2026 年 6 月上线了 service_tier: 'priority' 优先档来缓解高峰期拥堵——这两件事合起来,正好构成完整的 429 处置链路。
先读响应体和响应头:AI API 429 的四类成因怎么当场分开
拿到 429,先看两样东西:响应体里的错误细分码,以及响应头里的 Retry-After 字段。错误细分码能直接告诉你这是速率超限、项目消费上限还是余额耗尽;Retry-After 则给出服务端要求你等待的最短秒数。再拿并发梯度和跨时段采样做第二层对照,就能把临时限流和持久性瓶颈分开。
| 症状 | 判定信号 | 处置方向 |
|---|---|---|
| 短时间请求量高后立刻 429 | 错误体 rate_limit_reached,Retry-After 值较短 | 按退避重试,必要时降 QPS |
| 持续 429,错误体 project_spend_limit_exceeded | 项目消费已达上限 | 调整项目额度或预算,重试无效 |
| 错误体 credit_balance_exhausted | 预付费余额耗尽 | 充值,重试无效 |
| 并发一调高就 429 | 并发梯度压测出现拐点 | 设为安全并发档位,或买优先档 |
| 固定时段 429,其他时段正常 | 服务商高峰期拥堵 | 考虑优先级档位或换供应商 |
| 同一幂等键短时间反复失败 | 重试风暴特征 | 加抖动,限制最大重试次数 |
本文错误码分类与 Retry-After 规范以截至 2026 年 7 月的 OpenAI 官方文档口径为准;具体 RPM/TPM 阈值随账户等级与厂商而变,请以各自服务商文档为准。
成因一:账户级速率限制(RPM/TPM)打满,用请求日志怎么确认
官方把账户级限流分成两条独立轴:每分钟请求数(RPM)和每分钟 Token 数(TPM)。不少团队只看 QPS,结果发现“QPS 不高也被限”,往往是长上下文把 TPM 轴打满了。确认方法很简单:把请求日志按分钟聚合,字段取请求 ID、模型名、请求与响应中的 token 数、时间戳和状态码,看 429 是不是集中在长上下文的请求上。如果确实如此,问题不在并发,而在 Token 消耗节奏,需要从缓存、摘要或模型选择侧降低单请求 token 量。
成因二:并发上限触发,并发梯度压测怎么找塌陷点
并发调高就报 429 是什么原因?多数情况不是服务商故障,而是你越过了自己的并发塌陷点。自测方法:从当前并发数开始,按固定梯度(比如 20、40、80、160)阶梯式提升,每个梯度跑 3-5 分钟,记录 429 占比和首字延迟。当 429 占比从接近 0 突然跳到 10% 以上、或首字延迟出现明显拐点,那个点就是你的塌陷并发。把它乘 0.7 作为生产安全档,并把队列深度控制在能吸收抖动的范围。10% 与 0.7 是常见的工程经验起点,具体阈值应以你自己压测出的拐点为准,不同厂商与账户等级差异很大。这一步能避免你盲目买更高档位,也能避免把并发限流误判成服务商故障。
成因三:AI API 429 是限流还是余额不足,账单侧上限怎么判
很多团队误以为 AI API 429 都是限流——其实按 OpenAI 的错误体分类,项目消费上限(project_spend_limit_exceeded)和预付费余额耗尽(credit_balance_exhausted)同样以 429 返回。这类 429 重试再多也不会成功,因为它不是临时状态。监控上要把这两类 429 和临时限流分开告警:前者走充值或调整项目额度流程,后者走退避重试。误判的代价是重试风暴把本来可用的请求也拖垮,同时账单侧问题迟迟不被发现。
成因四:服务商侧高峰拥堵与客户端重试风暴,跨时段采样怎么做
调用大模型 API 高峰期一直 429,通常只有两种可能:服务商侧拥堵,或你自己的重试风暴。做法:固定用一个探针请求同一模型、同一输入,在早、中、晚和周末分别采样,看 429 是否呈现时段规律。若固定时段规律明显,说明是服务商侧拥堵;若全天随机出现且伴有同一请求快速重复失败,则是客户端重试风暴——最常见的诱因是无抖动的定间隔重试,一次限流被放大成持续 429。识别特征:同一幂等键在 10 秒内多次收到 429。
重试该怎么写:Retry-After 优先、指数退避加抖动、超时预算与幂等键
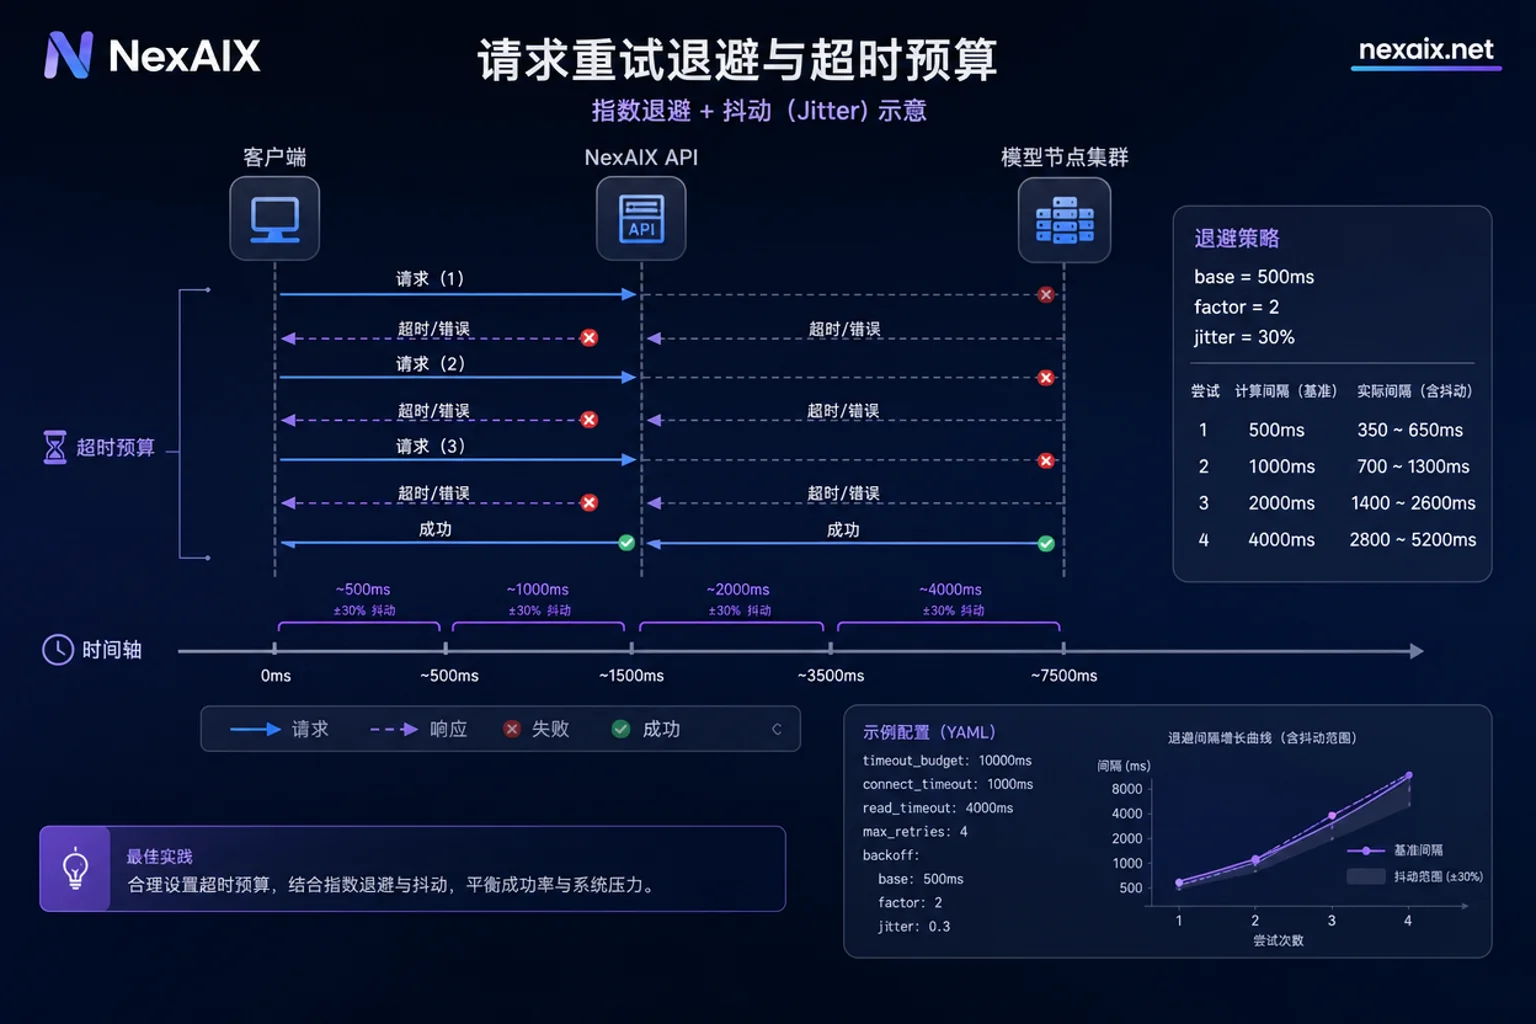
AI API 429 的重试间隔没有万能值,但优先级是确定的:有 Retry-After 响应头就遵守其秒数,没有就用带抖动的指数退避。伪代码结构如下:
retry_count = 0
max_retries = 3
base_delay = 1s
max_delay = 60s
timeout_budget = 30s
do {
  response = call()
  if response.status == 429:
    delay = parse_retry_after(response.headers) ?? (base_delay * (2^retry_count) + random(0, 0.25 * base_delay * (2^retry_count)))
    if retry_count < max_retries and elapsed_time < timeout_budget: sleep(delay)
    else: break
    retry_count++
  else: break
}
关键变量就四个:遵守 Retry-After、带抖动的指数退避、最大重试次数、整体超时预算。请求必须带幂等键,避免重试产生重复副作用。队列里也建议加背压,当 429 比例上升时主动降低生产速率,而不是靠重试硬扛。
协议层新解法:service_tier 优先档解决什么、不解决什么
DeepInfra 2026 年 6 月上线的 service_tier: 'priority' 是行业新动向:在 OpenAI 兼容接口 chat/completions 中传这个参数,按标准实时单价 1.5 倍收费,请求可跳过排队并获得保护性准入。它主要缓解的是“服务商高峰期拥堵型 429”,适合延迟敏感的生产请求。但它解决不了你的账户配额打满、余额耗尽和客户端重试风暴——这三类还得按前面几节处理。分界线如下:
| 场景 | 改代码 | 买优先档 | 换供应商 |
|---|---|---|---|
| 速率限流超限 | ✅ 退避+降 QPS | 一般不必 | 可对比 |
| 余额耗尽/配额超限 | ❌ 无效 | ❌ 无效 | 不解决根本 |
| 并发触顶 | ✅ 设安全并发 | 可暂缓 | 可对比 |
| 高峰期拥堵 | ⚠️ 只能缓解 | ✅ 见效 | 可对比 |
429 如实返回 vs 静默降级:可靠性口径该怎么定
高峰期是把 429 如实返回给调用方,还是静默切到更便宜模型?从可靠性角度,前者更可控:标准 429 能被退避策略平滑处理,且日志可对账;后者会让模型质量和成本核算同时失真。NexAIX 官网公开说明:模型满载时返回标准 429 与重试建议,不静默切换模型,返回体 model 字段对应实际执行模型,且保留请求 ID、模型名、token 数、时间戳、状态码等排障元数据——这些正好是上文做 429 分类聚合和重试放大系数核算的数据基础。生产环境建议以这类可核对口径为准,也可对照站内OpenAI兼容API一文的迁移要点,并以 NexAIX 限速与配额、错误码文档和状态页核对当前口径。
生产落地清单:本周可执行的检查项与监控指标
下面这份清单可以直接拿去核对你服务的 AI API 429 治理现状。
- [ ] 按错误码细分 429 分类计数(至少区分 rate_limit / spend_limit / balance_exhausted)
- [ ] 统计 Retry-After 遵守率:实际等待秒数 vs 响应头要求秒数
- [ ] 计算重试放大系数:某时间窗内实际发出的请求总数 / 业务侧发起的原始请求数(大于 2 说明重试过猛)
- [ ] 用并发梯度压测定位塌陷点,设定生产安全并发档与队列深度
- [ ] 按模型统计 429 占比,盯住长上下文模型有无异常
- [ ] 建立跨时段基线,区分服务商拥堵与自身问题
- [ ] 把账单侧 429 与临时限流分开告警
- [ ] 变更后回归验证:重试参数、并发档、优先档开关均回归测试
迁移或对比测试时,可用 NexAIX 的测试额度和 base_url https://api.nexaix.net/v1 在同一套代码里验证,具体规格以自有算力AI API页面说明为准;成本核算可参考AI API成本优化的指标口径。
常见问题
429 要不要立刻切供应商?
不建议。先完成四类成因判定:若是余额或配额问题,换供应商不解决;若是高峰期拥堵,可先对比试购优先档或临时换备用通道。只有经跨时段采样确认该服务商持续不达标,再考虑切换,且迁移前要压测同形态请求。
加钱买优先队列值得吗?
值得的前提是:你的 429 属于高峰期拥堵型,且应用对延迟敏感、付费意愿能覆盖 1.5 倍单价成本。若属于配额问题或自身重试风暴,买了也没用。建议先跑一周指标再决定。
429 和 503、超时怎么区分?
429 是限流/配额,响应头有 Retry-After;503 是服务不可用,通常没有 Retry-After,且多因服务端过载或维护;超时则是请求未在时限内返回,可能是网络或服务端慢。监控上应分三类告警,否则会掩盖真正的容量问题。
流式请求中途 429 怎么处理?
流式中途 429 较难优雅恢复。最佳做法是请求前先做配额预检,并设置短超时;若中途收到 429,立即停止当前流,按退避重试整个请求(需幂等键),而不是继续解析残片。日志要记录已接收的 token 数,便于对账。
多租户下如何分配配额?
可设租户级令牌桶,每个租户独立速率限制,避免单租户打满全局配额。429 要记录租户 ID,按租户维度统计失败率,便于对用户透明。若共享账户,需与供应商确认是否支持子配额。



评论(0)