 NexAIX-官方博客
AI中转站怎么选?别急着比模型数量和单价,先看 5 项可当场发请求验证的透传判据:档位参数、缓存控制、模型规格、满载行为、计费口径。这五项决定了你上线后新特性能不能用、成本能不能算清、出问题时能不能追责,比价格更早决定成败。
以 2026 年 8 月 5 日 OpenAI 为 GPT-5.6 系列 Fast mode 解除长上下文限制为例,超过 272K token 的提示词现在也能跑在 Fast mode,提速最高达 Standard 模式的 2.5 倍。上游参数迭代速度已经很快,但许多中转层的封装更新却跟不上。今天能调通的基础接口,不代表下个月的新参数还能原样透传。
本文的 5 项判据,每项都附最小请求和判定阈值,你可以在试用额度内直接验证。
先划清边界:中转站解决什么,不解决什么
回答 AI中转站怎么选之前,先划清中转站解决什么、不解决什么。中转站的合理价值在于:统一 OpenAI 兼容端点、统一计费、多模型切换、免去多套密钥管理。它让团队用一个 base_url 就能调用多个模型,并在一处查看账单和用量。
但中转站不会让模型本身更快更强,也不改变上游限速的本质,更不能承担上游能力缺失。如果上游本身没有某个功能,中转站再优化也变不出来。所以后文的判据只考核“透传与如实”,不考核“比官方更强”——用错误标准打分,容易误判供应商。
判据一:服务档位参数能不能原样透传
为什么重要:档位参数被过滤会让长文档任务失去 TTFT(首 Token 延迟)收益。OpenAI 在 2026-08-05 为 GPT-5.6 Sol、Terra、Luna 的 Fast mode 增加 272K token 以上的长上下文支持,相对 Standard 模式最高提速 2.5 倍。
最小验证请求:用同一段超长 Prompt(比如 300K token),分别带与不带档位参数各发若干次,对比 TTFT 与总耗时分布,并检查返回体是否回显该参数。
看哪个指标:TTFT 和总耗时的中位数、P90,以及返回体中的服务档位字段。
通过/不通过判定:带参数时 TTFT 明显下降且回显档位信息,则透传正常;若结果完全相同且无报错,说明参数被静默忽略;若直接报错“未知参数”,反而说明有明确处理,不算严重问题。注意:该特性属于 OpenAI 该批次模型,不代表所有厂商都支持。
判据二:缓存控制参数与命中率
为什么重要:KV 缓存(键值缓存)能跳过 Prefill 阶段(预填充阶段,即处理输入 token 的过程),降低首 Token 延迟和成本。中转站若轮询节点或改动消息顺序,会导致缓存不命中。DeepInfra 于 2026-08-05 上线 Prompt Cache Retention 功能,允许按请求设置 KV 缓存保留 5 分钟或 1 小时,并给予缓存折扣费率。但这是 DeepInfra 的具体实现,不能当作行业通用标准。
最小验证请求:固定一个长前缀(比如 2K token),连续发送多轮请求,观察每轮 TTFT 是否下降。
看哪个指标:TTFT 曲线、usage 中与缓存相关的统计字段(各家命名不同,需查供应商 API 文档)。
通过/不通过判定:连续请求后 TTFT 显著下降且缓存字段有值,说明缓存生效;若 TTFT 始终高企且缓存字段为零,可能轮询节点或改写请求。追问是否支持缓存保留参数、是否暴露缓存命中统计。缓存命中率与成本核算的完整算法见《AI API成本优化与缓存命中》。
判据三:新模型首发速度与规格一致性
为什么重要:上游新模型推出后,中转站多快接上、规格是否一致,决定你是否能尽早用上新能力。SiliconFlow 于 2026-07-21 首发上线 Kimi K3(2.8 万亿参数、1M 上下文、原生多模态),输入价格 $3.0/M token 起,提供 OpenAI 和 Anthropic 双兼容接口。但“上线了同名模型”不等于“规格一致”。
最小验证请求:逐步加长 Prompt 找出真实上下文上限;发一张小图测试多模态是否可用;分别打 Chat Completions 与 Anthropic 兼容路径。
看哪个指标:实际上下文窗口长度、是否支持图像输入、两种协议端点的响应是否正常。
通过/不通过判定:实际上下文窗口远小于声明(比如声明 1M,实测只能 128K)或图像输入报错,则规格缩水。双协议差异属于协议本身差异,不是中转站缺陷。要求供应商在更新日志中标注上线时间。
判据四:满载与异常时的行为
为什么重要:最危险的不是限速,而是限速时被静默降级到更便宜的模型,导致用户感知不到但输出质量下降。
最小验证请求:并发压到限速阈值,检查是否返回标准 429 状态码及重试提示,同时观察 model 字段是否始终一致;用固定 seed 或固定问题集做回归比对输出风格。
看哪个指标:429 响应是否正确、model 字段一致性、输出风格稳定性。
通过/不通过判定:满载时返回标准 429 和重试提示且 model 一致,属正常;若返回 200 但 model 字段变化或输出风格突变,存在静默降级,立即终止测试并追问。详细排查见《AI API 429 报错排查》和《多模型API网关静默降级检测》。
判据五:计费与日志口径,账单能不能和 usage 对上
为什么重要:中转站统一计费,若 usage 字段缺失或账目不透明,无法验证成本,尤其当缓存命中涉及折扣费率时。
最小验证请求:跑一组已知 token 量的固定请求,用本地统计与账单对账。
看哪个指标:usage 字段是否随响应返回、缓存命中部分是否单独计价、账单明细能否按请求 ID 追溯、日志保留范围是否书面写明。
通过/不通过判定:本地统计与账单误差在合理区间(如 5% 以内)且缓存命中有单独计费项,则基本合格;若 usage 缺失或账目混乱,要求供应商解释,否则后续成本无法控制。
5 项判据的最小复现脚本与判定阈值
把 AI中转站怎么选落成一张可执行核对表。下面是可直接复用的 OpenAI SDK 示例骨架,替换 base_url 和 model 即可测试(所有测试应在同一套代码下换 base_url 和 model 跑,保证横向可比):
import openai

client = openai.OpenAI(
    base_url="你的中转站base_url",  # 如 https://api.example.com/v1
    api_key="你的key"
)

# 测试1:服务档位参数透传
resp = client.chat.completions.create(
    model="gpt-5.6-sol",
    messages=[{"role": "user", "content": "长文本..."}],
    extra_body={"service_tier": "fast"}  # 若支持
)
print(resp.usage, resp.model)
service_tier 的具体取值以你所调用上游厂商的当前 API 文档为准,此处仅演示参数如何随请求透传。
判定阈值核对表:
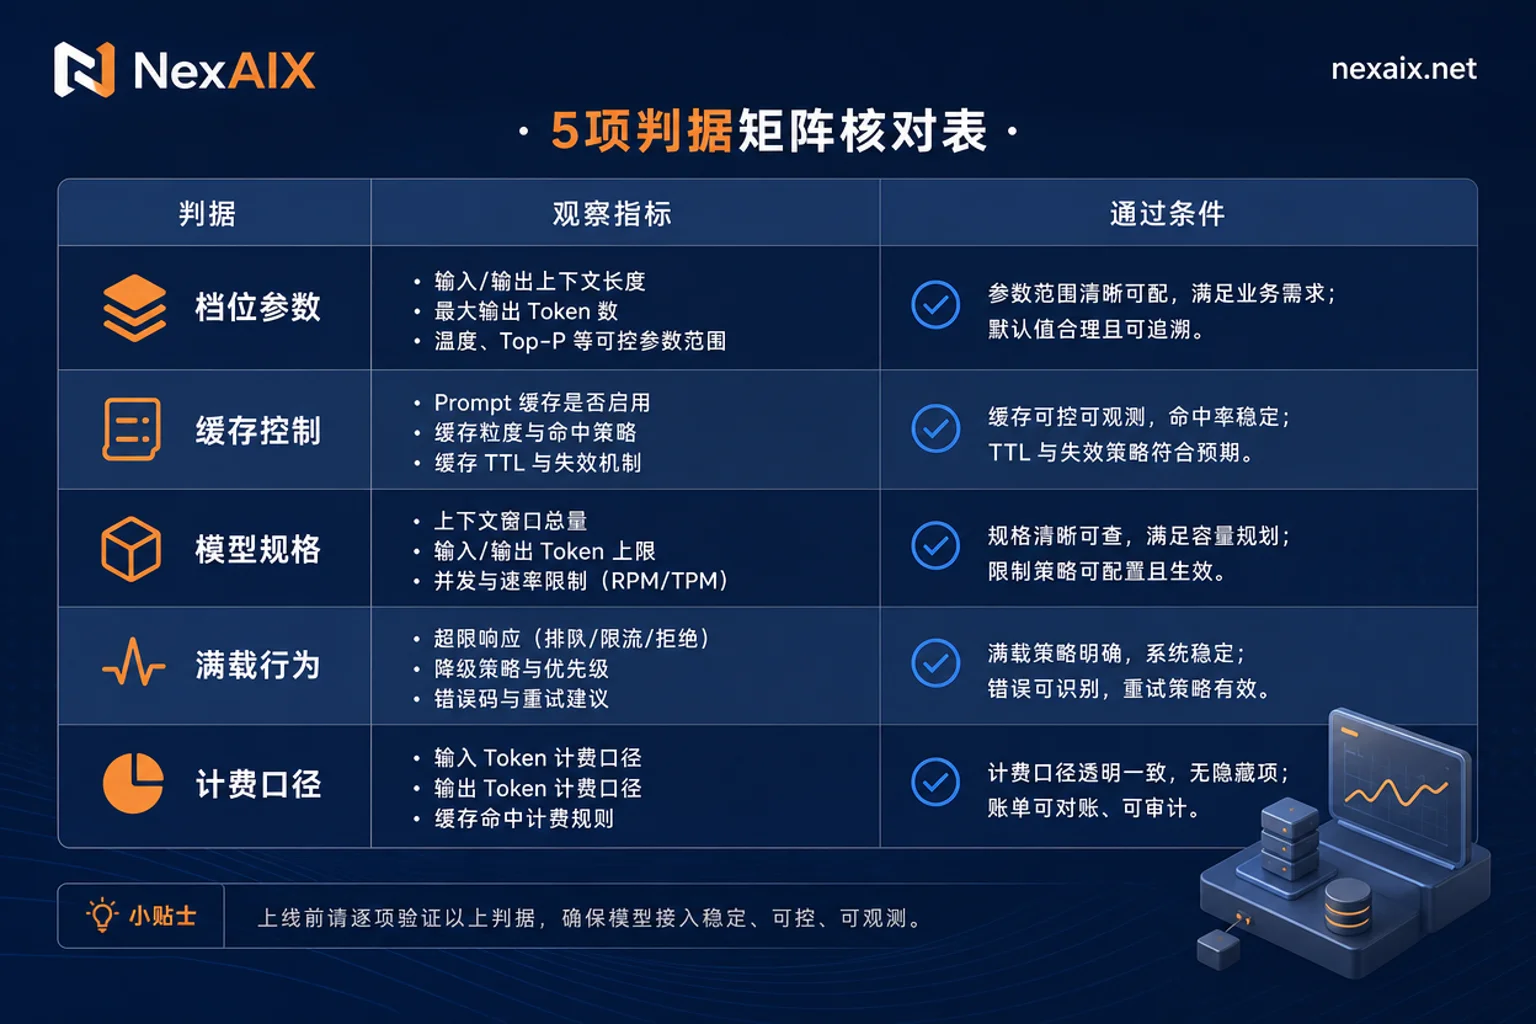
| 判据 | 最小请求形态 | 观察指标 | 通过条件 | 不通过时的追问 |
|---|---|---|---|---|
| 档位参数透传 | 超长 Prompt,带/不带档位参数各发数次 | TTFT、总耗时、返回体档位字段 | 带参数时 TTFT 明显下降且回显档位 | “是否过滤 service_tier 类参数?不支持时是否报错?” |
| 缓存控制 | 固定长前缀连续多轮请求 | TTFT 曲线、usage 缓存统计字段(以供应商文档为准) | TTFT 下降且缓存字段有值 | “支持缓存保留参数吗?为何缓存命中低?” |
| 新模型规格 | 加长 Prompt、图片请求、双协议调用 | 上下文上限、多模态、协议响应 | 与声明一致且两协议均正常 | “为何上下文只有 X?多模态为何报错?” |
| 满载行为 | 并发压测到限速阈值 | 429 响应、model 字段、输出稳定性 | 标准 429、model 一致、风格稳定 | “满载时是否切换模型?model 字段为何变化?” |
| 计费口径 | 已知 token 量固定请求 | usage、账单明细、缓存计费 | 误差<5%,缓存单独计费 | “usage 为何缺失?缓存折扣如何体现在账单?” |
哪些差异属于正常实现差异,不该当成扣分项
- 未知参数被明确报错而非静默吞掉:不算缺陷,说明有显式校验。
- 不同协议端点的字段命名差异:属协议本身差异。
- 上游本身未开放的特性:中转层不支持属正常。
- 区域网络导致的固定延迟基线:不代表中转层慢。
- 不同模型缓存粒度不同:属上游特性。
签约前索取的承诺清单与试用期验收顺序
AI中转站怎么选,最后一步是把口头能力变成书面承诺。向供应商索取:模型来源与部署方式、日志保留范围、满载行为(是否 429)、model 字段口径、新模型上线节奏与更新日志、状态页与错误码文档。
试用期执行顺序:先跑判据四与三(满载与模型规格),再跑一与二(透传与缓存),最后对账(判据五),在最短时间内排除最严重的问题。
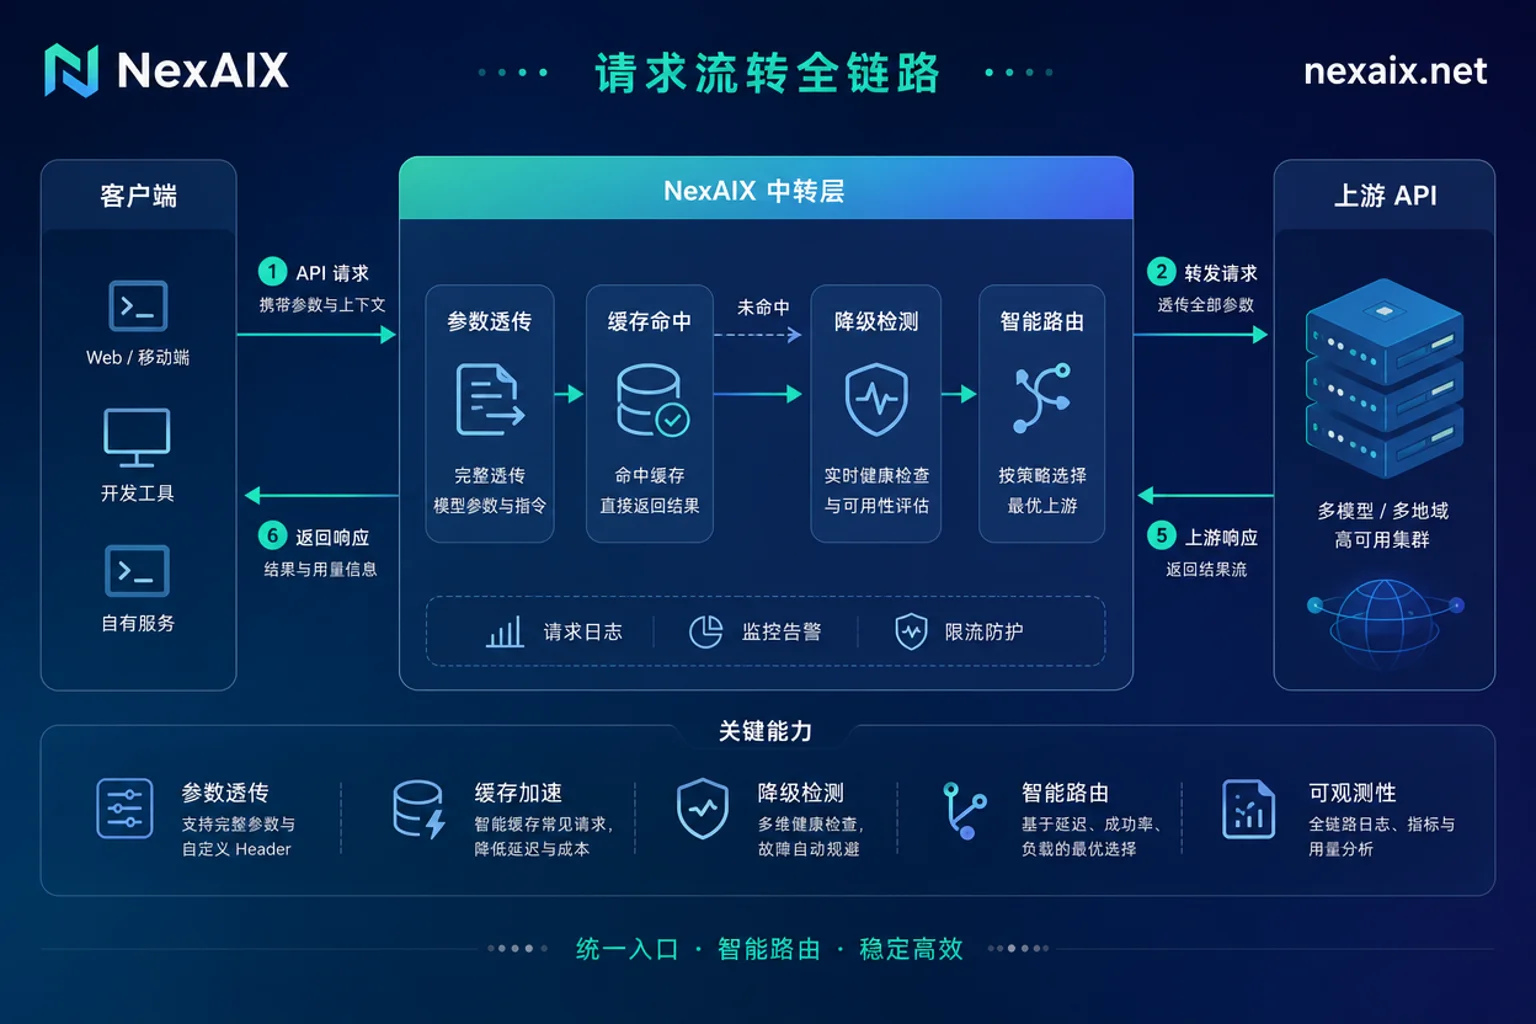
以 NexAIX 为例,其公开 base_url 为 https://api.nexaix.net/v1 的 OpenAI 兼容接口,满载时返回标准 429 与重试建议而不静默切换到更便宜模型,返回体 model 字段对应实际执行模型,且零日志仅保留请求 ID、模型名、token 数、时间戳、状态码等计费与排障元数据。你可以用测试额度按本文 5 项判据自跑一遍,再对照 NexAIX 模型页与更新日志核对当前可用模型与规格。
常见问题
中转站会不会把 fast mode 参数吞掉?
有可能。如果不带参数与带参数请求的耗时完全一致,且无报错,大概率是参数被过滤。验证方法:同一超长 Prompt 分别带与不带档位参数各发数次,对比 TTFT 和返回体是否回显参数。若被吞,追问供应商是否支持 service_tier 类参数。
中转站调用 prompt cache 能不能命中?
看节点轮询与请求一致性。若中转层轮询多个节点或改动消息顺序,前缀不一致就会导致缓存不命中。验证方法:固定长前缀连续请求,观察 TTFT 是否下降,以及 usage 中缓存统计字段是否有值。
AI中转站返回的 model 字段和实际模型一致吗?
多数正规中转站会保持一致,但静默降级时可能不一致。验证方法:并发压测到限速阈值,检查返回体 model 字段是否始终与请求一致,并对比输出质量。若发现不一致,立即终止使用。
中转站一般多久上线新模型?
没有固定标准,快的模型发布几天内上线,慢的可能数周。建议关注供应商的更新日志,并询问其承诺的上线时效。以 Kimi K3 为例,SiliconFlow 在 2026-07-21 首发上线,这属于较快的案例。
怎么快速测出中转站有没有降级?
直接用固定 seed 和固定问题集,分别直连官方 API 与中转站,对比输出 JSON 结构和内容质量。如果输出有明显差异,或满载时 model 字段变化,很可能存在降级。更系统的做法是参考《AI中转站掺水怎么查》。



评论(0)