 NexAIX-官方博客
AI API成本优化的核心不是换更便宜的模型,而是先把账单拆开:单次请求价格 = Cache Miss 输入 token 数 × 单价 + Cache Hit 输入 token 数 × 单价 + 输出 token 数 × 单价。从 2026 年 7 月 31 日 DeepSeek-V4-Flash-0731 公测公布的三档单价看,Cache Hit 与 Miss 的输入价格相差约 50 倍,这意味着一份 prompt 是命中缓存还是全部重算,对月账单的影响远大于模型档位差异。因此,AI API成本优化的正确顺序是先提高缓存命中率并控制输出长度,再考虑是否换模型。
先把账单拆开:一次请求到底在为哪三段 token 付费
大多数账单误区是把总 token 数乘一个均价来估算费用,但实际计费是三段分别计价。以 DeepSeek-V4-Flash-0731 官方定价为例(2026-07-31 观测,实际以官方定价页为准):
| 计费段 | 单价(美元/百万 tokens) | 说明 |
|---|---|---|
| Cache Miss 输入 | $0.14 | 未命中缓存的输入 token |
| Cache Hit 输入 | $0.0028 | 命中缓存的输入 token,约为 Miss 价格的 2% |
| 输出 token | $0.28 | 模型生成的 token,单价远高于命中输入 |
单价来源:DeepSeek API Docs — Change Log 与 Models & Pricing(官方文档),观测时间 2026-07-31;第三方汇总口径可另行核对,官方定价页为最终依据。
当一次请求返回时,SDK 会在 usage 字段给出 prompt_tokens、prompt_tokens_details(含 cached_tokens)和 completion_tokens。正确的成本公式是:费用 = (prompt_tokens - cached_tokens) × Miss 单价 + cached_tokens × Hit 单价 + completion_tokens × 输出单价。
这里容易算错的地方是忽略 cached_tokens 的存在,把全部输入按 Miss 计价;或是把输出与输入混在一起按均价估算。先把这三个数字从日志里拉出来,才知道钱花在哪一段。
Cache Hit 与 Cache Miss 的价差有多夸张:用公开单价做一次量级演算
同样 100 万输入 token,按 $0.14 与 $0.0028 计算,在不同命中率下输入侧费用完全不同(示例演算,非实测承诺):
| 缓存命中率 | 输入费用(美元) | 相对 0% 命中的节约 |
|---|---|---|
| 0% | $140 | 基线 |
| 50% | $70 + $1.4 = $71.4 | 约 49% |
| 90% | $14 + $2.52 = $16.52 | 约 88% |
命中率从 0% 提到 90%,输入侧费用下降近九成。这就是为什么 AI API成本优化里,prompt 结构设计比换模型更关键:同样一个模型,通过提高命中率就能把输入成本降一个量级。
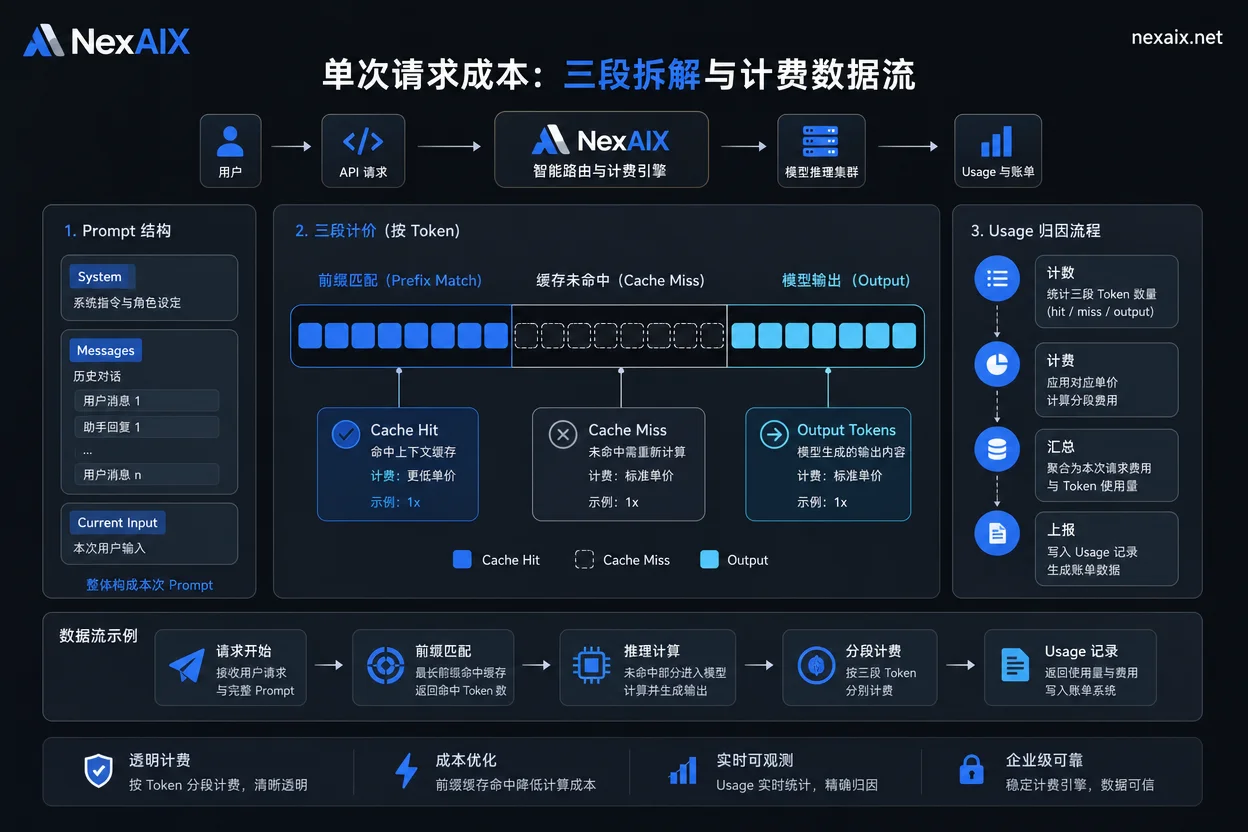
图1:单次请求成本三段拆解与计费数据流。计价字段口径为 usage 中 prompt_tokens、cached_tokens、completion_tokens;单价口径为 2026-07-31 公开价格。
为什么 prompt 结构决定命中率:固定前缀、变量后置与多轮拼接三条规则
Prompt Cache 基于严格前缀匹配:只有 prompt 开头的内容和之前请求完全一致,才能命中缓存。动态数据放在开头会导致整段失配。
| 破坏命中的行为 | 后果 | 改法 |
|---|---|---|
| 在 prompt 开头注入时间戳、随机 ID、User ID | 前缀不匹配,整段 Cache Miss | 把固定 system prompt、工具 Schema 放在前面,动态值放到最后 |
| 多轮对话把历史消息直接拼在开头 | 每轮前缀都变,命中率极低 | 固定最近 N 轮顺序,历史使用摘要或额外缓存块 |
| 频繁修改工具 Schema | 前缀变化导致缓存失效 | 尽量冻结 Schema 版本,变更时评估成本影响 |
这三条里,最容易被忽视的是变量位置。比如在 RAG 场景里,把检索片段插到 system prompt 之前,每次检索结果不同,前缀就被污染,缓存永远打不中。正确做法是固定 system prompt 在前,检索内容后置。
输出 token 才是隐形大头:max_tokens、停止条件与流式截断的成本控制
输出单价 $0.28/M 是命中输入 $0.0028/M 的 100 倍。所以 AI API成本优化不能只盯着输入,更要控制输出长度。
| 控制手段 | 作用 | 适用场景 |
|---|---|---|
| 设置 max_tokens 上限 | 防止无限生成 | 所有调用 |
| 明确 stop 条件 | 提前终止 | 生成长文本、代码补全 |
| 要求结构化输出 | 减少多余解释 | 数据提取、分类 |
| 流式场景早停 | 达到预期即截断 | 实时对话 |
实现上,可以先从日志统计平均输出 token 数,找到那些回答冗长且无实际价值的调用,再用 prompt 约束或 max_tokens 压下来。输出侧控制往往比压缩输入更快见效。
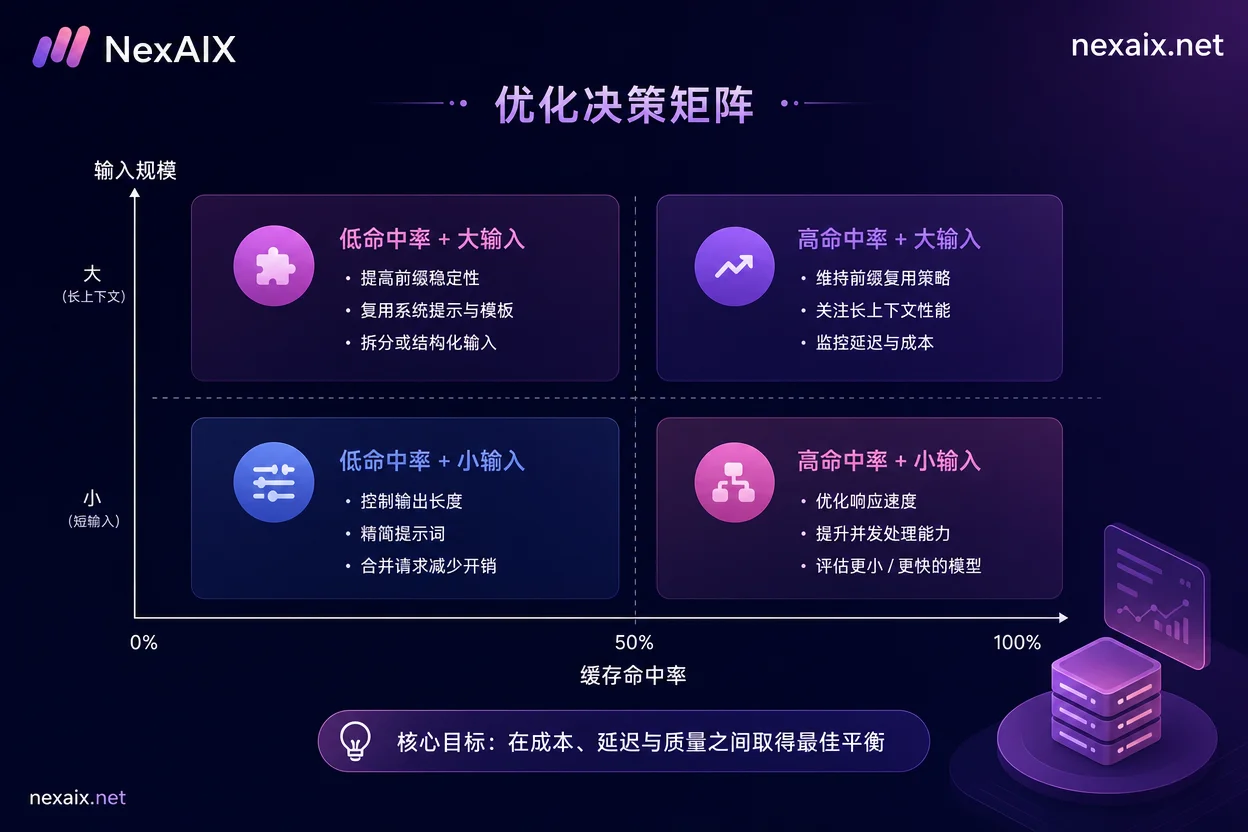
图2:命中率与输入规模决策矩阵,象限动作为方法建议,非实测降本结论。
长上下文不等于要塞满:1M 窗口下的上下文预算封顶策略
1M 上下文窗口能塞下的内容远超预算允许的量——长上下文调用成本高,通常不是窗口不够,而是每次调用没有输入上限。关键是不把窗口容量当作默认填充目标,而是给每次调用设输入硬上限。
| 策略 | 做法 |
|---|---|
| 设定输入 token 硬上限 | 如 max_input_tokens=200K,超限则截断或分块 |
| 按检索得分截断 | 用重排序只取前 K 个片段,不全部塞入 |
| 区分固定知识与动态检索 | 固定知识放缓存区,动态内容后置 |
| 对超长会话做摘要压缩 | 定期把历史对话压缩成摘要再继续 |
判断方法很简单:如果某个 prompt 的输入 token 超过预期,先看是否真的需要全部信息。用上下文预算表记录每次调用的输入预算、实际用量和命中率,就能发现哪些调用在浪费钱。
批处理与实时链路要分开算:不同 SLA 对应不同的成本容忍度
实时对话链路对延迟敏感,为了保体验可能需要牺牲部分命中率;离线批处理则可以等更久,用更激进的压缩和小模型。
实时链路优先保证固定前缀以吃缓存,并对输出长度设硬上限,可接受延迟通常在秒级;批处理链路允许排队等待,可以激进压缩上下文,甚至降档使用更便宜的模型,可接受延迟可以到分钟级甚至更高。
实现时给每个请求打 tag(如 link=realtime 或 link=batch),在账单侧按 tag 归因,才能看清哪条链路在烧钱。
迁移前必做的成本 delta 测算:用同一份 eval 集跑对照而不是看标价
标价不等于账单。不同模型的 tokenizer 分词方式不同,同样的文本可能产生不同 token 数,缓存机制也不同,直接套用标价测算会偏差很大。
正确做法是用同一份 eval 集、同一套 prompt,在两个模型上分别跑,采集三段 token 数和请求数,再按各自单价折算。注意模型标识:2026 年 7 月 24 日,deepseek-chat 和 deepseek-reasoner 旧别名已彻底停用,必须显式声明 deepseek-v4-flash 或 deepseek-v4-pro,且返回体 model 字段要核对实际执行模型,防止成本口径失真。切换模型时如何核对 model 字段,可参考OpenAI兼容API 的 model 迁移路径。此外,还要警惕网关静默降级导致成本失真,可参考多模型API网关的静默降级检测排查。
NexAIX 提供 OpenAI Chat Completions 兼容接口(base_url https://api.nexaix.net/v1),可以用同一份 prompt 在多个模型间切换,只保留计费与排障元数据(请求 ID、模型名、token 数等,不记录 prompt 内容),且满载时返回标准 429 不静默降级,便于用同一套脚本跑成本对照。用同一份 eval 集跑对照时,可参考自有算力AI API 的性能压测框架设计测试方法。具体价格与缓存计费以 NexAIX 当前定价页为准。
成本优化落地清单:8 项可当周执行的检查项
| 序号 | 检查项 | 验证方式 |
|---|---|---|
| 1 | 核对三段单价来源 | 对照官方定价页,记录观测时间 |
| 2 | 上线 usage 埋点与命中率看板 | 确认能统计 cached_tokens 与命中率 |
| 3 | 把动态变量后置 | 检查 prompt 开头是否有时间戳、随机 ID |
| 4 | 冻结工具 Schema | 定版本,变更走评估 |
| 5 | 设置 max_tokens 与 stop 条件 | 检查调用参数,统计平均输出 token |
| 6 | 上下文输入硬上限 | 为每类调用设 max_input_tokens |
| 7 | 按链路打 tag 归因 | 检查日志是否有 link 字段 |
| 8 | 迁移前跑 eval 成本对照 | 用同一份 eval 集对比两模型三段 token |
这 8 项里,前三项当天就能做,后面几项需要一点工程改造。做完第一轮,再决定是否换模型——很多时候换模型省的钱,不如提高命中率省得多。
常见问题
大模型API费用怎么算?
费用 = Cache Miss 输入 token 数 × Miss 单价 + Cache Hit 输入 token 数 × Hit 单价 + 输出 token 数 × 输出单价。先看 usage 里的 cached_tokens,再套公式。
prompt cache命中率怎么提高?
把固定 system prompt 和工具 Schema 放在最前面,动态数据(时间戳、用户 ID)后置,保持前缀不变。多轮对话避免改变历史顺序,工具 Schema 尽量冻结。
AI API输入输出token价格差多少?
以 DeepSeek-V4-Flash-0731 为例,输出单价 $0.28/M 是 Cache Miss 输入 $0.14/M 的 2 倍,是 Cache Hit 输入 $0.0028/M 的 100 倍。控制输出和命中输入是省钱关键。
长上下文调用成本太高怎么办?
设输入 token 硬上限,用检索截断和摘要压缩减少输入量。区分固定知识和动态检索,动态部分后置。
AI API账单突然暴涨是什么原因?
最常见是缓存命中率下降(prompt 前缀变了)、输出变长或调用量上升。用 usage 日志对比前后三段 token 数,定位是哪一段增长。
怎么估算换模型后的API成本?
用同一份 eval 集、同一套 prompt 在两个模型上跑一遍,采集三段 token 数与请求数,再按各自单价折算。不要只看标价,要实测 tokenizer 差异。



评论(0)