 NexAIX-官方博客
先给结论:AI API价格不能拿标价直接横向比,必须把输入档(缓存命中/未命中)、输出档、服务档位、能力档位四层口径统一后,再按自己实际请求分布折算成加权单价才有意义。2026年7月30日OpenAI对GPT-5.6阶梯调价、7月31日DeepSeek-V4-Flash-0731上线,两件事同时改写了当前比价基准,正好拿来做量级参照。
口径一:输入 token 要拆成缓存命中与未命中两档
同一个模型的输入价往往有“缓存命中”和“未命中”两个价位,如果只盯着标称输入价,你可能高估了成本。以DeepSeek-V4-Flash-0731为例,官方2026年7月31日公布的单价是:输入 $0.14/1M tokens,缓存命中则低至 $0.0028/1M,两者相差50倍。如果你系统提示词或few-shot样本复用率高,实际输入成本会被大幅摊薄。
怎么估算命中比例?最直接的办法是统计一周内请求的prompt重复度:把相同前缀的请求数量除以总请求数,就能得到近似命中率。前缀稳定的多轮对话通常命中率较高,每次拼接新检索片段的RAG场景则明显偏低——具体比例请以自己日志统计为准,不要套用经验值,可按自身日志算出的重复前缀占比代入公式。
口径二:输出 token 价格是输入的数倍,AI API价格里最容易被低估的一项
输出单价通常是输入的几倍乃至几十倍,对账单的放大作用远大于输入。以GPT-5.6 Luna为例,2026年7月30日调价后输入$0.20/1M、输出$1.20/1M,输出是输入的6倍;DeepSeek-V4-Flash-0731输出$0.28/1M,恰好是输入$0.14的2倍。若你的应用是长回答、代码生成或推理型,输出长度会直接决定总成本。
所以比价前,务必先统计日志中输出token的P50和P90值。若P90远超P50,说明存在长尾输出,这类请求会拉高账单,选型时要把输出权重放大。合理做法是分别估算不同业务线的输出分布,而不是用全站平均值掩盖差异。
口径三:服务档位算不算在基础单价里(Fast mode / service_tier 该怎么核)
比 AI API价格 时最容易被漏掉的一层,是服务档位。2026年7月30日OpenAI将原Priority processing统一更名为Fast mode,并支持通过service_tier: 'fast'字段调用。这意味着服务档位是独立于模型档位的第三层变量,比价时必须确认实际请求走的哪一档。核对时可采取三步:①先看自己的请求体里是否显式传了 service_tier 字段,传了哪个值;②再去账单或用量导出里看是否存在区分不同档位的用量行,如 fast 与 standard 分别列示;③切换档位后重点观察 P95 延迟与单请求成本的变化,确认提升是否符合业务需要。但要注意,Fast mode并非所有供应商通用的标准字段,具体是否加价、如何计费,需在对应供应商定价页核对。忽略这一层,很可能拿基础价对比了别人的优先处理价,结论自然失真。
口径四:同家族能力阶梯能拉开多大价差(用 2026-07 现价做量级说明)
同一家族内的能力档位价差可能非常悬殊。以2026年7月30日OpenAI官方标价(每百万token)为例:
| 模型档位 | 输入价($) | 输出价($) | 与最低档倍数 |
|---|---|---|---|
| GPT-5.6 Luna | 0.20 | 1.20 | 1x |
| GPT-5.6 Terra | 2.00 | 12.00 | 10x |
| GPT-5.6 Sol | 5.00 | 30.00 | 25x |
Luna降价80%后,最低与旗舰档的价差被拉大到25倍左右。这意味着能力阶梯的选择直接决定成本量级,降档省下的钱可能非常可观。但注意,这是特定时点的公开标价,具体以官方定价页当前数据为准。
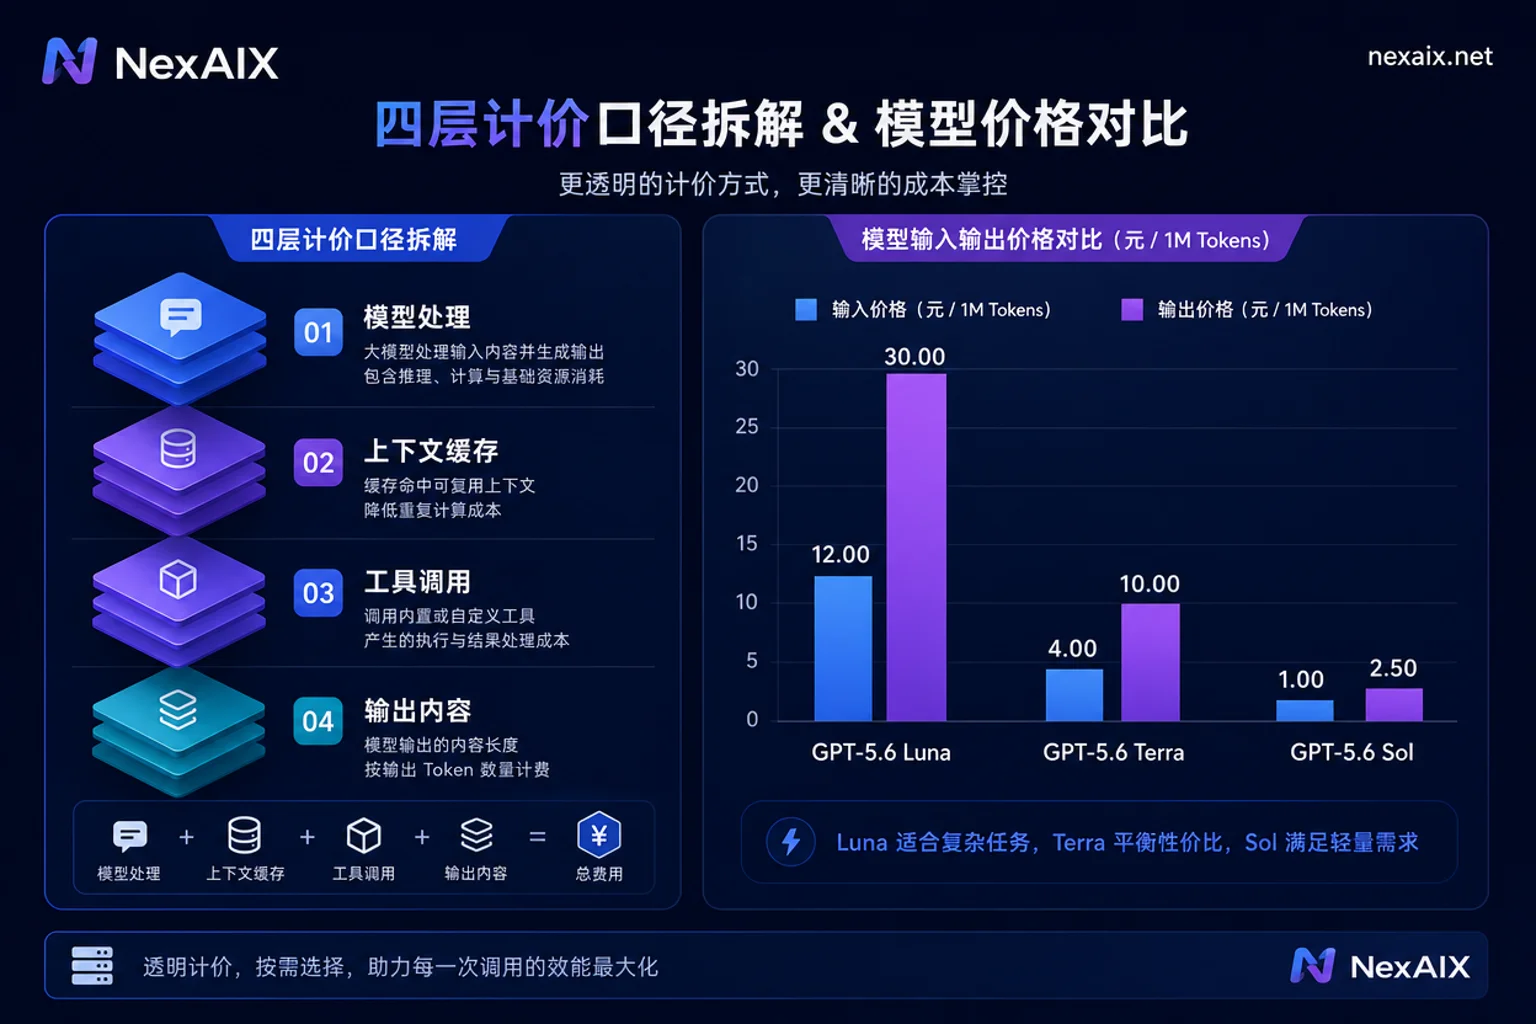
把四层口径折算成一条加权单价公式
把四层口径统一后,AI API价格 才能折算成一条可比的加权单价公式:
加权单价 =
 (命中率 × 缓存命中输入价 + 未命中率 × 标准输入价) × 输入token占比
 + 输出价 × 输出token占比
 + 服务档位加价(如有)
举一个算例:假设某业务输入占60%,输出占40%,命中率70%。若用DeepSeek-V4-Flash-0731,输入价按$0.14、命中价$0.0028、输出$0.28代入,加权单价≈(0.7×0.0028+0.3×0.14)×0.6+0.28×0.4≈0.026+0.112=0.138美元/百万token。而若输出占80%,加权单价会升至约0.23美元,差距明显。
注意:不同业务线应分别计算,而不是全站取一个平均值。例如客服机器人输出短,而代码生成输出长,两者最优选择可能完全不同。按业务线拆分后再做 AI API成本优化 才有抓手,全站平均值会掩盖长输出业务的真实开销。
降档决策:哪些任务可以下沉,哪些必须留在旗舰档
降档前先判断任务性质:分类、抽取、改写、路由等轻任务,往往低档模型已够用,可以放心下沉;而复杂Agent编排、长链推理、代码修改等任务,能力不足会导致重试和错误,隐性成本反而更高,需谨慎。
不过,低价档不等于必然弱。DeepSeek-V4-Flash-0731通过重新Post-training,在Terminal Bench 2.1等Coding Agent基准上超越V4-Pro预览版,而单价仍保持输入$0.14/输出$0.28。这提示我们,能力档位与价格并非严格正相关,必须按任务实测。
降档前必跑的对照 eval:同一套代码换 model 跑同一份评测集
判定能否降档,最可靠的办法是跑对照实验:固定评测集、固定采样参数,只改model字段,记录准确率、重试率和输出长度三项指标,然后把重试与超长输出带来的额外成本计回单价里。如果重试率升高导致最终成本反超旗舰档,降档就得不偿失。
横向比价的前提是同一套代码能无缝切换模型。NexAIX提供OpenAI Chat Completions兼容接口,base_url为https://api.nexaix.net/v1,返回体的model字段对应实际执行模型,且满载时按标准429处理而非静默降级,这让成本核算更可信。你可以用它在GPT-5.6 Terra/Sol和DeepSeek V4 Flash/Pro之间跑同一评测集,对比加权单价与效果。具体价格、规格与可用性,以NexAIX当前模型页与定价页为准。
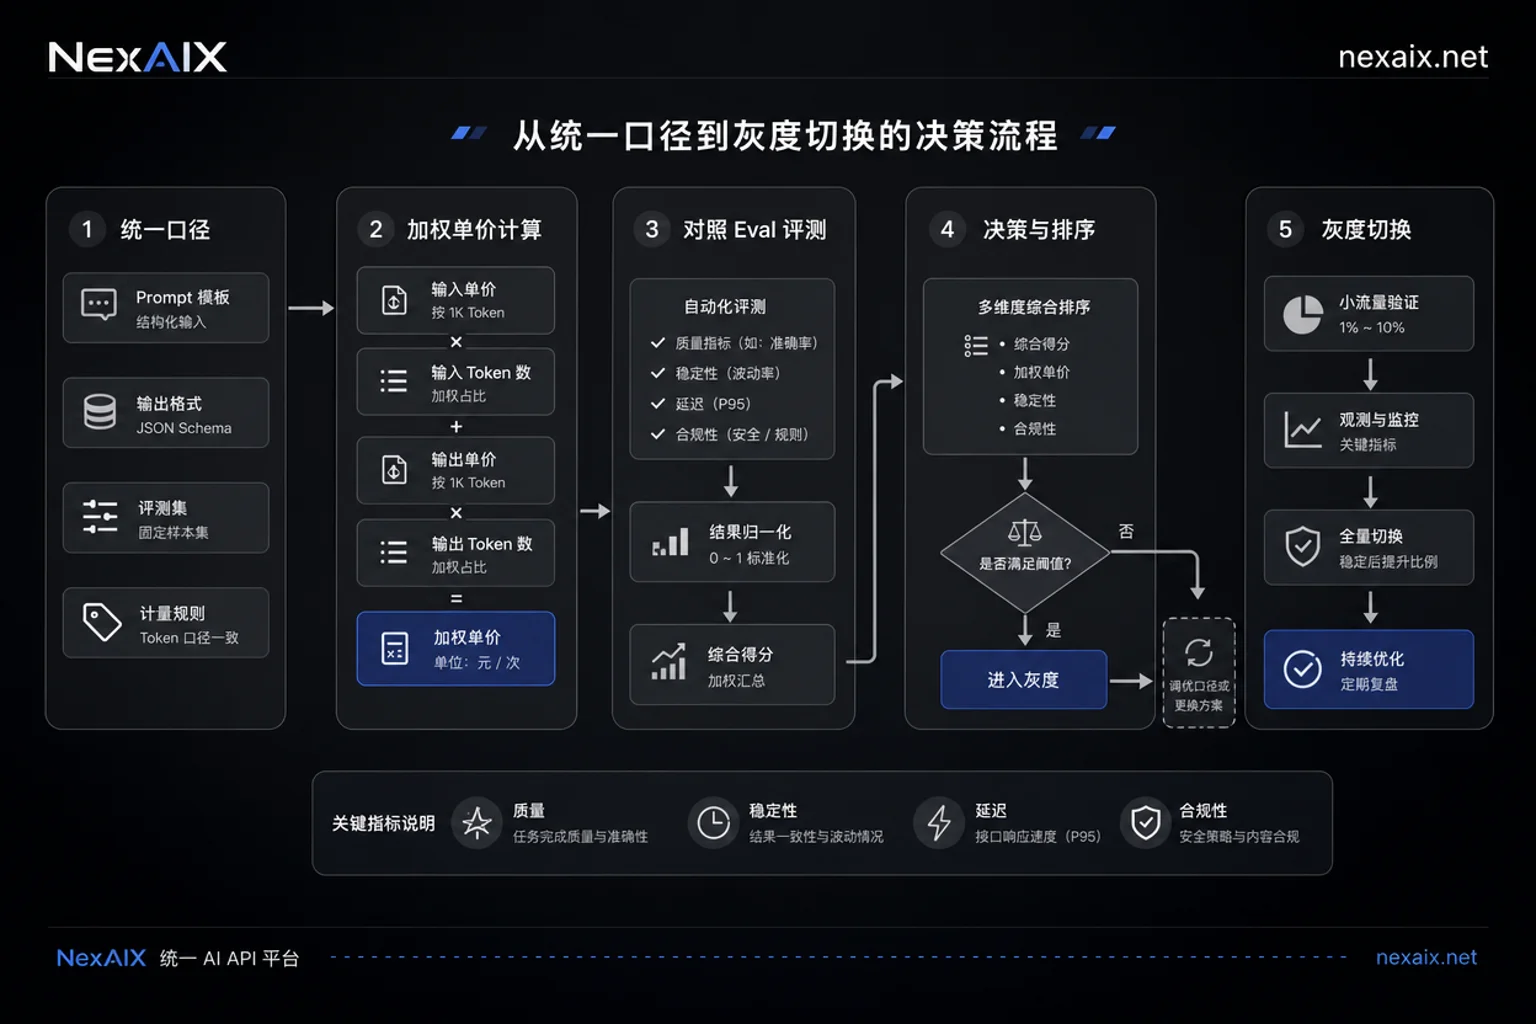
AI API价格采购核对清单:8 项必须问清的计价细节
- 计价单位是否统一为每百万token,tokenize算法是否一致
- 缓存命中价的定义与保留时长(超时是否过期)
- 输出价是否包含推理token(如思维链)
- 服务档位(如fast)是否额外加价
- 请求的model字段是否对应实际执行模型
- 限速与429重试是否影响有效成本(可参考AI API 429的处理策略)
- 账单粒度与用量导出是否支持按业务线拆分
- 价格变更是否有通知机制,避免账单突变
此外,关注AI中转站掺水现象,确保供应商返回的model字段真实可靠。
常见问题
AI API价格怎么算?
先把输入缓存命中/未命中、输出、服务档位、能力档位四层口径统一,再按实际请求分布折算成加权单价,公式见上文。只有统一口径后,AI API价格才有可比性。
大模型API多少钱一百万token?
2026年7月,DeepSeek-V4-Flash-0731官方输入$0.14、输出$0.28;GPT-5.6 Luna输入$0.20、输出$1.20(均每百万token)。不同模型价差很大,且与缓存、服务档位相关,建议按实际用量折算。以上为2026-07-30/07-31公开标价,以官方定价页当前数据为准。
输入token和输出token价格差多少?
输出通常是输入的2-6倍。如DeepSeek输出为输入的2倍,GPT-5.6 Luna为6倍,旗舰Sol为6倍。长输出场景应重点核算输出成本。
GPT-5.6 Luna 和 Terra 价格差多少?
Luna输入$0.20/输出$1.20,Terra输入$2.00/输出$12.00,后者是前者的10倍。价差拉大到10倍,分类、抽取等轻任务下沉的经济性明显提高,但需按任务实测。以上为2026-07-30/07-31公开标价,以官方定价页当前数据为准。
AI API降档会不会影响效果?
可能影响,但取决于任务。分类、抽取等简单任务影响小;复杂推理或代码生成可能显著下降。必须用对照eval验证,不能只看价格。
service_tier fast 模式要额外付费吗?
OpenAI将Priority processing更名为Fast mode,是否加价未在本次公告中明确,需查看OpenAI兼容API供应商的定价细节。不同服务商政策不一,接入OpenAI兼容API的中转或聚合平台是否透传该字段也不一致,比价时需逐家确认。



评论(0)