 NexAIX-官方博客
大模型API的prompt缓存通常提供5分钟与1小时两档保留时长,选哪档取决于同一会话相邻请求的间隔中位数,而不是上下文长度。2026年8月起有服务商上线显式Prompt Cache Retention,可指定5分钟或1小时;Anthropic默认5分钟并可扩展至1小时;Google Gemini显式缓存默认1小时。但TTL是最大保留上限而非保证,实际受节点调度影响。
先分清:命中率和保留时长解决的不是同一个问题
很多人混淆两个概念:缓存命中率由prompt前缀的稳定性决定,而保留时长由你的请求节奏决定。前缀结构不变,但两次请求隔了10分钟,5分钟档就过期了;反之,请求间隔3秒,但每次前缀都变,再长的TTL也救不了。所以选档前先测:同一session相邻请求的间隔分布。
大模型API缓存的四个时点:写入、命中、刷新与过期
以Anthropic为例,缓存生命周期有四个关键时点:首次请求写入缓存(按约1.25倍基础输入价计费);后续请求前缀匹配命中(cache-read约10%价格);命中时刷新滑动窗口(自动延长5分钟);超过TTL未命中即过期。注意刷新语义各家不同:Anthropic命中自动重置滑动窗口,而Google Gemini显式缓存按固定TTL淘汰,需显式调用更新接口。迁移时务必逐个核对。
按请求间隔选档:三类节奏的实测方法
从网关日志导出同一session相邻请求时间差,统计P50、P75、P90。具体做法:按session_id分组,取相邻请求timestamp差值,剔除超过30分钟的跨会话噪声,分别对对话、Agent、批处理三类流量单独统计分位数。判定线:P90 < 短档时长即无需显式延长。人机对话受用户思考影响,间隔离散,建议用P90判断;Agent循环秒级到十几秒,通常5分钟足够;批处理任务间隔跨小时,可能两档都不合适。参考下表:
| 请求节奏 | 建议档位 | 判定依据 |
|---|---|---|
| 人机对话(用户思考) | 5分钟或1小时 | P90间隔若大于5分钟选1小时 |
| Agent循环(秒级) | 5分钟 | 间隔几乎总在5分钟内 |
| 批处理/定时任务 | 需评估 | 间隔跨小时,两档都易过期 |
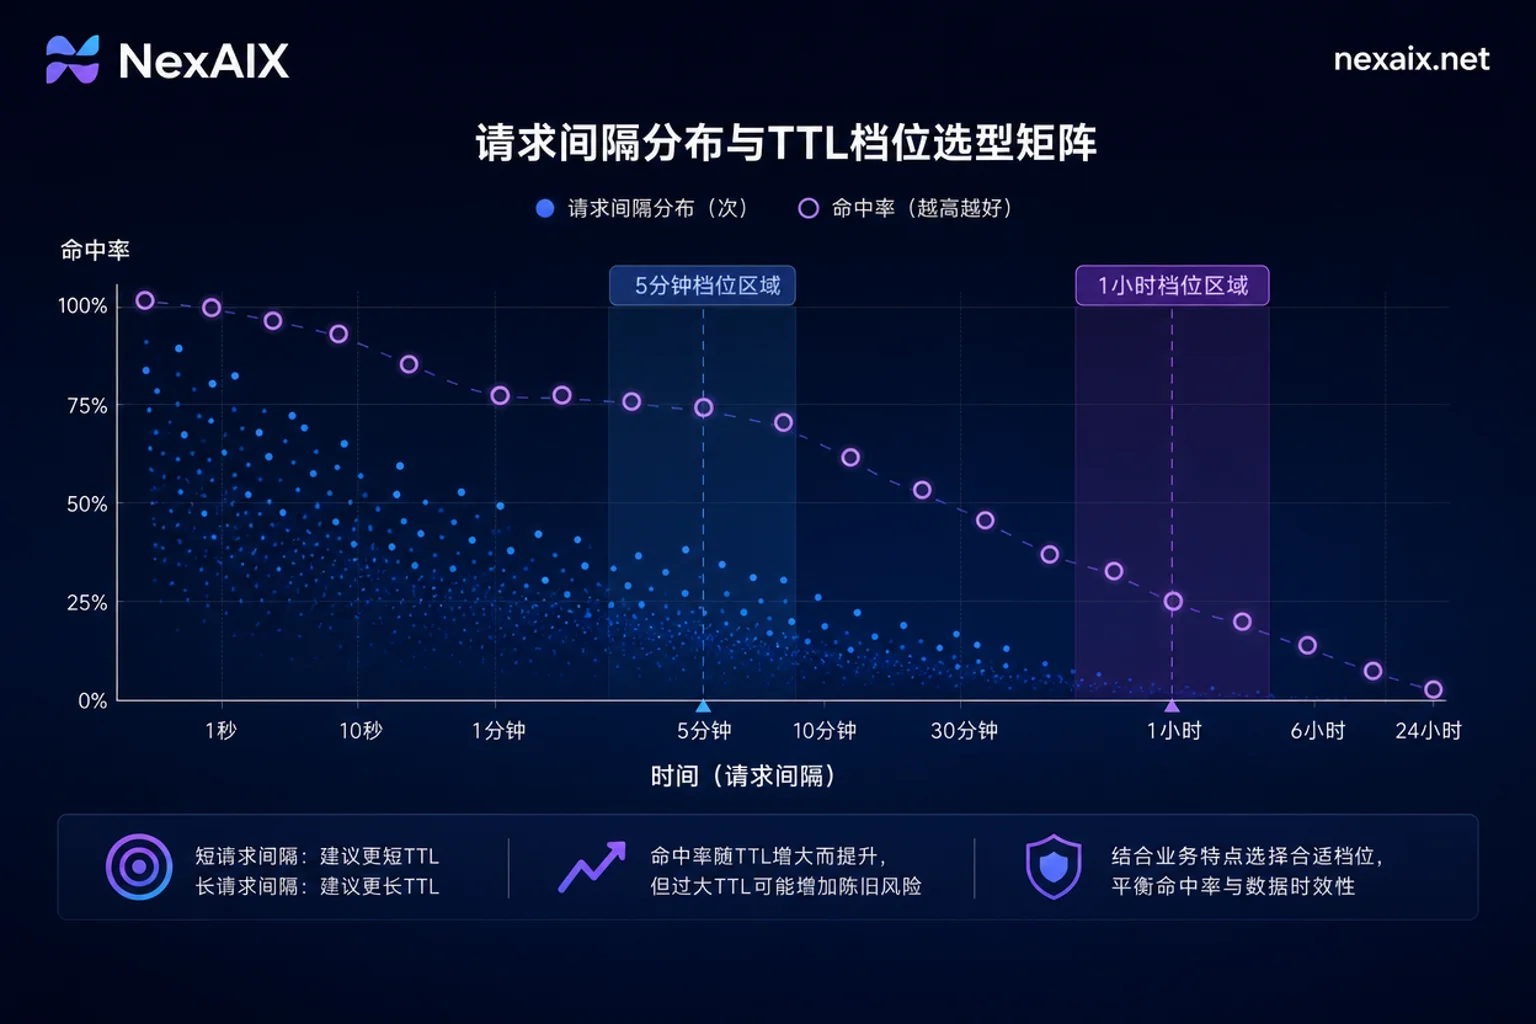
5分钟还是1小时:命中概率、折扣与写入溢价的权衡
估算净收益用这个式子:净收益≈命中概率×缓存token数×(基础输入价−cache-read价)−写入溢价。写入溢价=缓存token数×(1.25−1)×基础输入价。以下数字仅为示例,请替换为你所用模型定价页的实际单价。示例:假设基础输入价$5/M,缓存命中10万token,命中率70%,节省约$0.315,写入溢价约$0.125,净省约$0.19。具体以各家定价页为准。也可参考 AI API价格。
prompt结构决定能不能续命:固定前缀在前、变量在后
prompt编排时,系统提示与工具定义置顶且保持字节级稳定,检索片段与用户输入后置,时间戳、随机ID、会话摘要不要塞进前缀。工具定义顺序变动会击穿整个前缀,让TTL设置失去意义。多轮对话缓存命中率低,多半是前缀不稳定,而非保留时长不够。
长上下文Agent模型怎么配合缓存策略
近年出现了小激活参数的MoE模型,如NVIDIA Nemotron 3.5 Lightning(30B混合MoE,激活3B,支持1M上下文,2026年8月上线DeepInfra),专为多轮高吞吐Agent设计。这类模型在高频循环中prefill占比高,跳过prefill能显著降低TTFT,更适合短档高频刷新而非长档囤积。具体模型是否支持缓存,以各厂商文档为准。相关实践可参考 AI API成本优化。
哪些场景延长保留是纯浪费
低频单轮调用、前缀token数低于最小可缓存长度、每次请求改系统提示、A/B实验频繁切换prompt版本、跨session无共享前缀——这些情况延长保留只会增加写入与存储开销。别把长TTL当万灵丹。相关实践可参考 AI API延迟。
别把TTL当成常驻保证:大模型API缓存多久失效由什么决定
设了1小时不代表一定命中。分布式调度、节点内存压力下的LRU逐出、跨节点路由都可能导致冷启动。TTL是最大保留上限,不是保证。目前跨节点命中率官方benchmark未公开,建议用自己流量做灰度对照。若需稳定环境,可考虑 自有算力AI API。
换模型或换供应商时的缓存回归清单
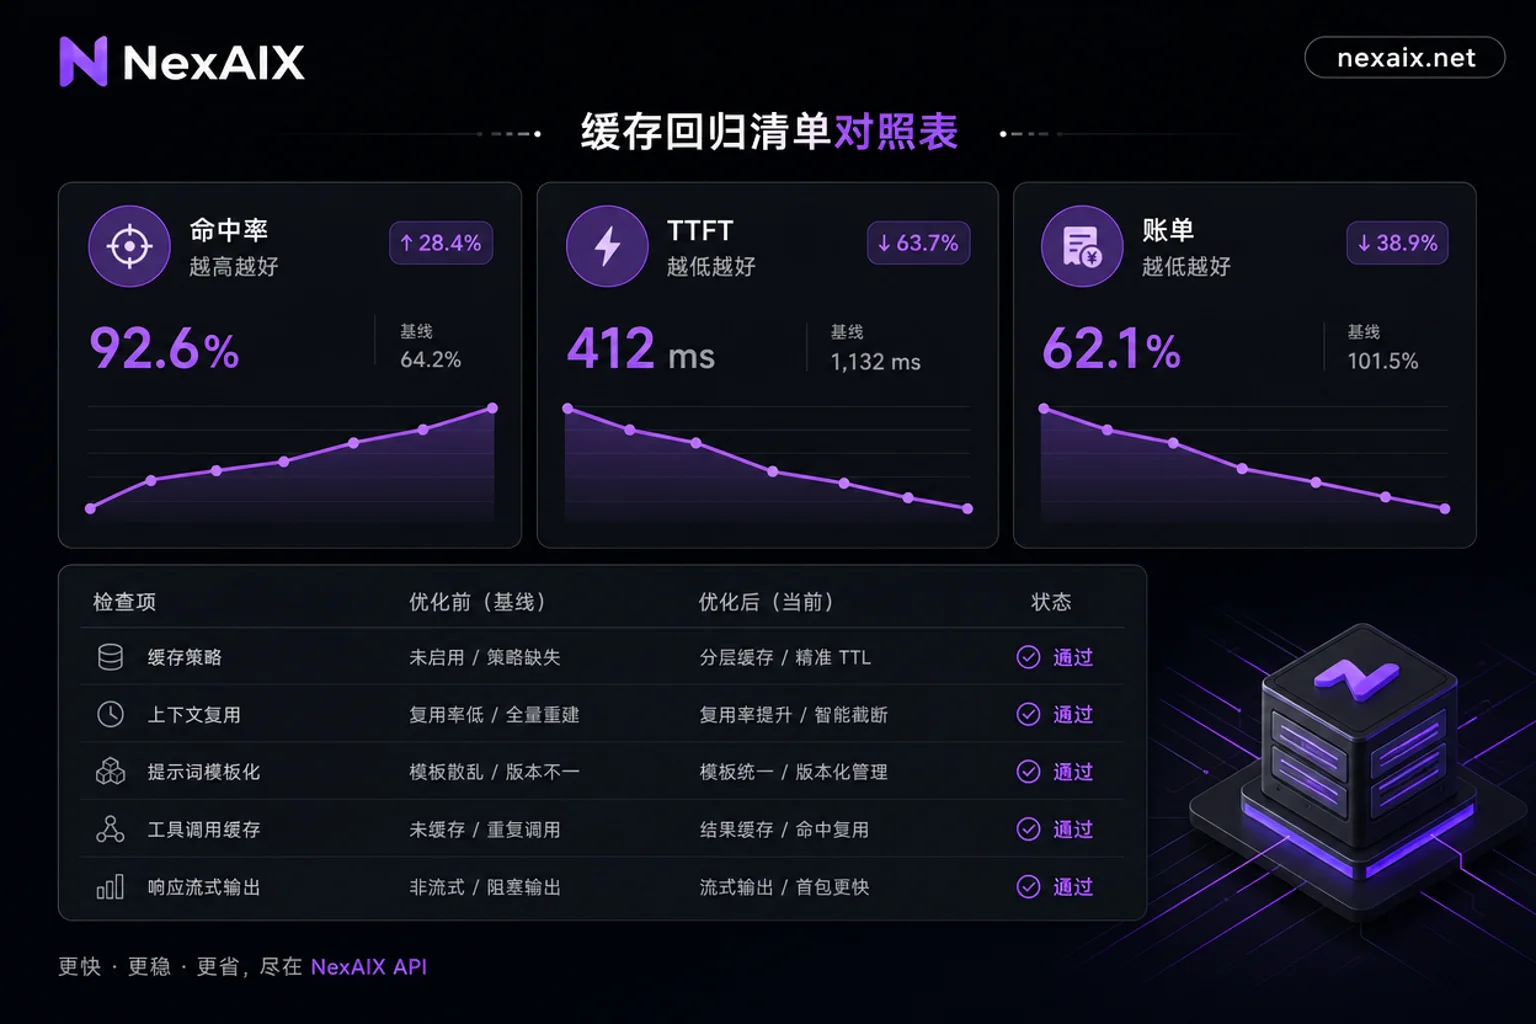
换供应商后缓存行为会变,务必用同口径对照。可以用NexAIX的OpenAI兼容base_url(https://api.nexaix.net/v1)跑同一套压测脚本,在不同模型上对比三项指标。具体各模型是否支持缓存及计费口径,以NexAIX模型页、定价页与文档为准。回归清单:
| 指标 | 对照项 | 判定阈值 |
|---|---|---|
| 命中率 | 缓存token/输入token | 缓存token占输入token比例较迁移前下降超过一定幅度即视为前缀被击穿,需回查工具定义与系统提示是否逐字节一致 |
| TTFT | P50/P95 | 延迟收益是否达标(以你的SLA为准) |
| 账单 | cache-write / cache-read / 普通输入 | 分摊比例是否合理(以你基线为准) |
常见问题
prompt cache能保留多久?
主流大模型API提供两档:5分钟和1小时。Anthropic默认5分钟可扩展至1小时,Google Gemini显式缓存默认1小时,部分推理服务商支持在请求参数中显式指定5分钟或1小时。TTL是最大保留上限,实际受节点调度影响。
大模型API缓存多久失效?
超过TTL未命中即失效。Anthropic命中自动刷新滑动窗口,Google Gemini显式缓存按固定TTL淘汰,需要显式更新接口延长。具体以各厂商文档为准。
KV cache保留时长怎么设置?
在请求体中通过服务商提供的缓存控制字段显式指定保留档位(Anthropic 侧为 cache_control 断点标记,其他服务商字段名以各自 API 文档为准)。先测同一 session 相邻请求间隔 P90,小于5分钟选短档,否则评估长档。
多轮对话缓存命中率低是什么原因?
多半是前缀不稳定,比如把时间戳、随机ID放在前缀,或系统提示频繁变动。优先优化prompt结构,让固定前缀在前,变量在后。
agent循环调用缓存会命中吗?
会,但前提是两次调用间隔小于TTL且前缀一致。Agent循环通常秒级间隔,5分钟档足够。若间隔常超5分钟,可考虑1小时档。
cache read和cache write价格差多少?
以Anthropic为例,首次写入约1.25倍基础输入价,命中读取约10%(90%折扣),价格差约9倍。但实际收益取决于命中概率和缓存token量。
长上下文首token慢怎么用缓存优化?
确保前缀稳定并选用合适的TTL档位,让高频复用的长前缀命中缓存,跳过prefill,可大幅降低首token延迟。若间隔太长,可考虑缩短上下文或分段缓存。



评论(0)