 NexAIX-官方博客
AI API并发上限不是常数,而是四个约束里最先撞墙的那个
决定 AI API并发上限的,不是你想开多大,而是四个相互制约的判据:账户侧 RPM/TPM 配额、服务商推理侧的吞吐塌陷点、单请求输出长度占用的槽位时长、以及业务能接受的 p95 尾延迟。你的并发池只能取这四个约束的交集,而且这个交集会随模型架构、上下文长度和账户档位变化。2026-08-11,NVIDIA 开源发布 Nemotron-3.5-Lightning-30B-A3B(Hugging Face 官方模型卡),总参数30B、单 token 仅激活3B、原生支持最高1M上下文,专为低延迟高吞吐的 Agent 循环设计;DeepInfra 同日发布博客宣布上线其 OpenAI 兼容 Serverless API,规格以官方页面为准。这类低激活参数 MoE 改变了单请求的计算与显存开销,但客户端到底能开多大并发,仍需按本文的四个判据逐个实测,不能沿用旧模型写死的常量。
先把三个量分开:并发数、RPM/TPM 配额与实际吞吐
很多人把并发数、RPM/TPM 配额和吞吐混为一谈。并发数是在途请求数;RPM/TPM 是账户侧计费窗口的配额;吞吐是单位时间完成的 token 数。三者的关系直觉上接近 Little's Law:在途请求数 ≈ 到达速率 × 平均请求耗时。也就是说,如果平均请求耗时变长,同样的到达速率就需要更大的并发数来维持吞吐;而配额限制了到达速率的上限。
判据一:账户侧配额能撑住多少并发,先用 RPM/TPM 反推
先用平均单请求耗时和 RPM 算出理论在途上限:并发 ≈ RPM × 平均请求耗时 / 60。再用平均单请求 token 量和 TPM 算 token 维度上限:并发 ≈ TPM / (平均单请求 token × 平均请求耗时)。取两者较小值作为第一层天花板。注意 TPM 通常包含输入和输出 token,长上下文场景下 TPM 往往比 RPM 先耗尽。具体档位请到所用平台的限速与配额文档核对。
判据二:服务商推理侧的吞吐塌陷点,只能用并发梯度测出来
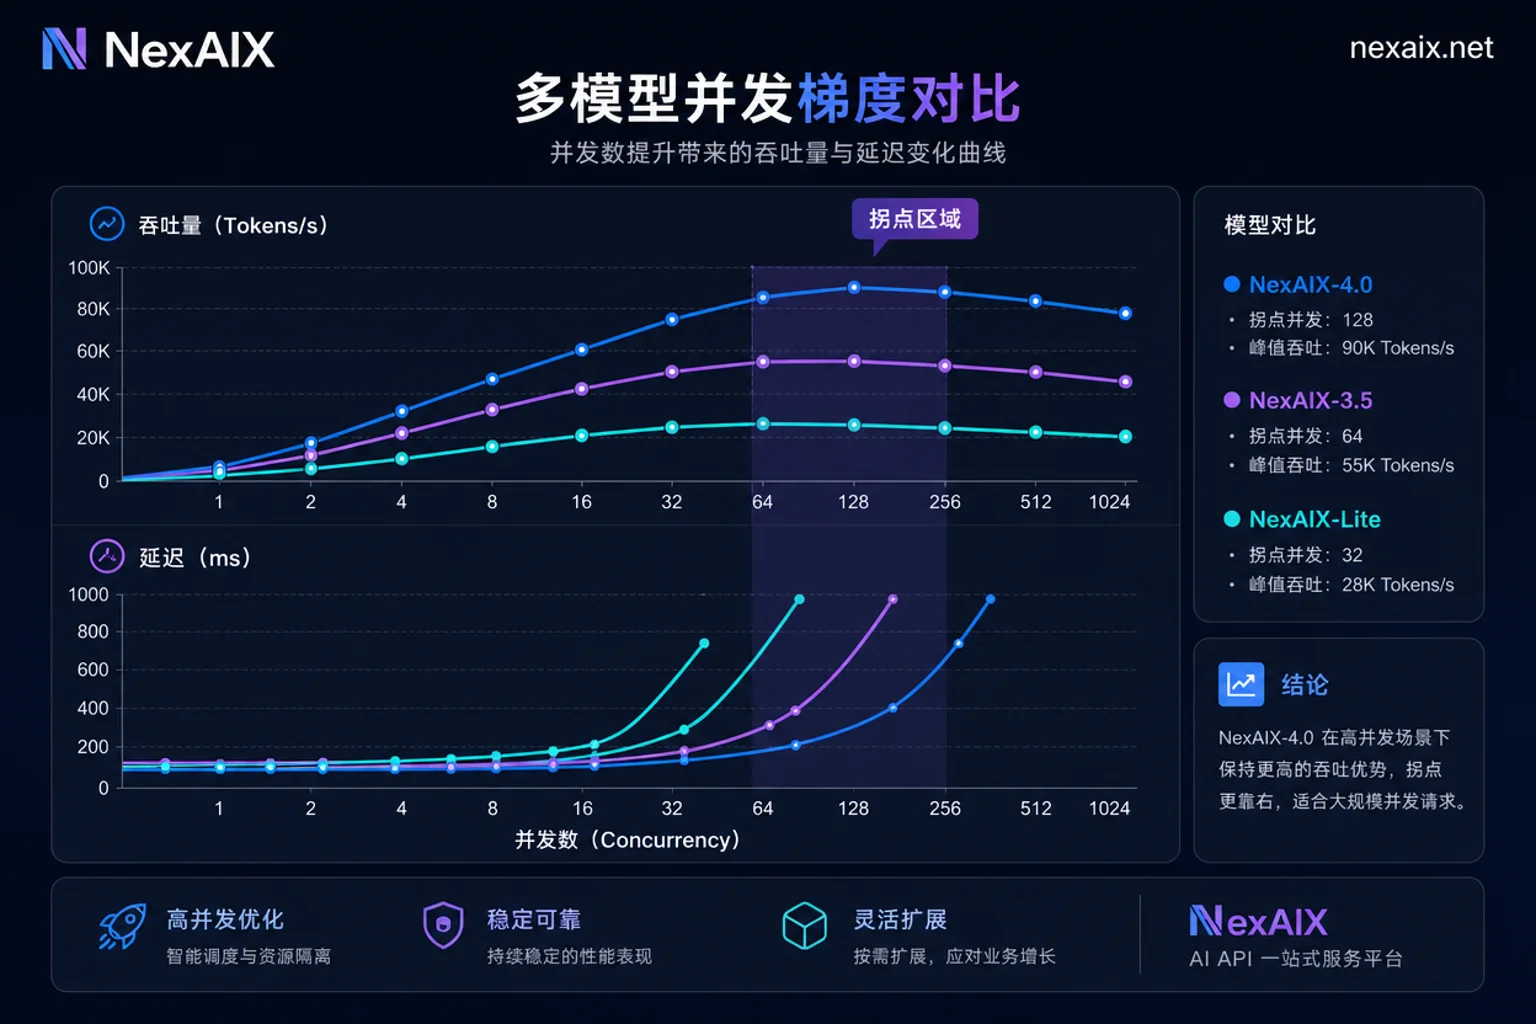
AI API并发过了某个点后,总吞吐不再上升,TTFT 和 p95 先拉长,随后出现排队与 429——请求在服务端排队而非并行执行。这个塌陷点只能用并发梯度实验读出来:横轴并发数,纵轴总 token/s 与 p95,拐点即塌陷点。取拐点的 70%–80% 作为生产并发池的保守起点,这是工程惯例而非行业标准值。例如拐点并发数为 N,则生产池取 0.7N–0.8N 向下取整。具体执行步骤见下文压测章节。
判据三:单请求输出长度决定一个并发槽被占用多久
解码阶段耗时随输出 token 数几乎线性增长。输出越长,在途请求驻留越久,实际 RPM 越低、TPM 越高。因此应区分任务类型设置不同并发池:
| 任务类型 | 典型输出长度 | 并发池建议 |
|---|---|---|
| 短分类抽取 | <200 tokens | 可开较高并发,受 RPM 限制为主 |
| 中等问答 | 200-1000 tokens | 适中并发,需同时观察 TPM |
| 长文生成/深度推理 | >1000 tokens | 并发宜低,重点监控 p95 |
同时,max_tokens 和停止条件也是并发治理的一部分,限制输出长度能提高并发效率。
判据四:用业务能接受的 p95 尾延迟反推并发上限
前三个判据给出的是 AI API并发的可行区间,最终取值由业务 SLO 决定。交互式场景优先锁 p95/p99 目标再倒推并发;离线批处理可牺牲尾延迟换总吞吐。
| 场景 | 目标指标 | 并发取法 | 超时与重试 |
|---|---|---|---|
| 交互式(聊天、实时响应) | p95 目标由前端可接受等待时间反推(通常按秒级设定) | 取 p95 达标时的最大并发 | 短超时,快速失败 |
| 半交互(异步任务) | 以吞吐为主,p95 放宽到业务可容忍的批次完成窗口 | 取拐点的 80% | 中等超时,有限重试 |
| 离线批处理 | 只约束总吞吐与失败率 | 取拐点的 100% 或略过 | 长超时,允许多次重试 |
具体阈值需按自身 SLO 与所用平台限速文档设定。
模型架构会改写并发经济性:低激活 MoE 与百万上下文
以 Nemotron-3.5-Lightning-30B-A3B 为例(NVIDIA 于 2026-08-11 发布,Hugging Face 模型卡),其 Mamba-2 与 MoE 混合架构使得单 token 仅激活 3B 参数,理论上降低了单请求的计算与显存开销,同一批算力可容纳更多在途请求。但服务商的批处理策略、KV cache 预算和账户配额仍是实际约束,尤其长上下文下 KV cache 会重新成为瓶颈。因此“激活参数少所以并发能开更大”只是假设,必须实测验证,不能直接沿用旧模型的并发常量。
大模型 API 并发压测怎么做:固定 prompt、固定输出长度与并发梯度
要测出自己服务的拐点,可按以下步骤:
- 固定 prompt 集合与输入长度分布。
- 用 max_tokens 和忽略 EOS 锁定输出长度。
- 并发从 1 按倍数递增(1,2,4,8...)。
- 每档跑够能算出稳定 p95 的样本量(样本量以分位数不再随新增样本明显漂移为准)。
- 记录 TTFT、端到端延迟、总 token 吞吐、429 与超时比例。
- 在不同时段各采样一次,避开共享容量波动(共享容量在不同时段波动)。
- 保留逐请求日志,便于计算分位数。
并发池怎么落地:信号量、连接复用、退避与超时预算
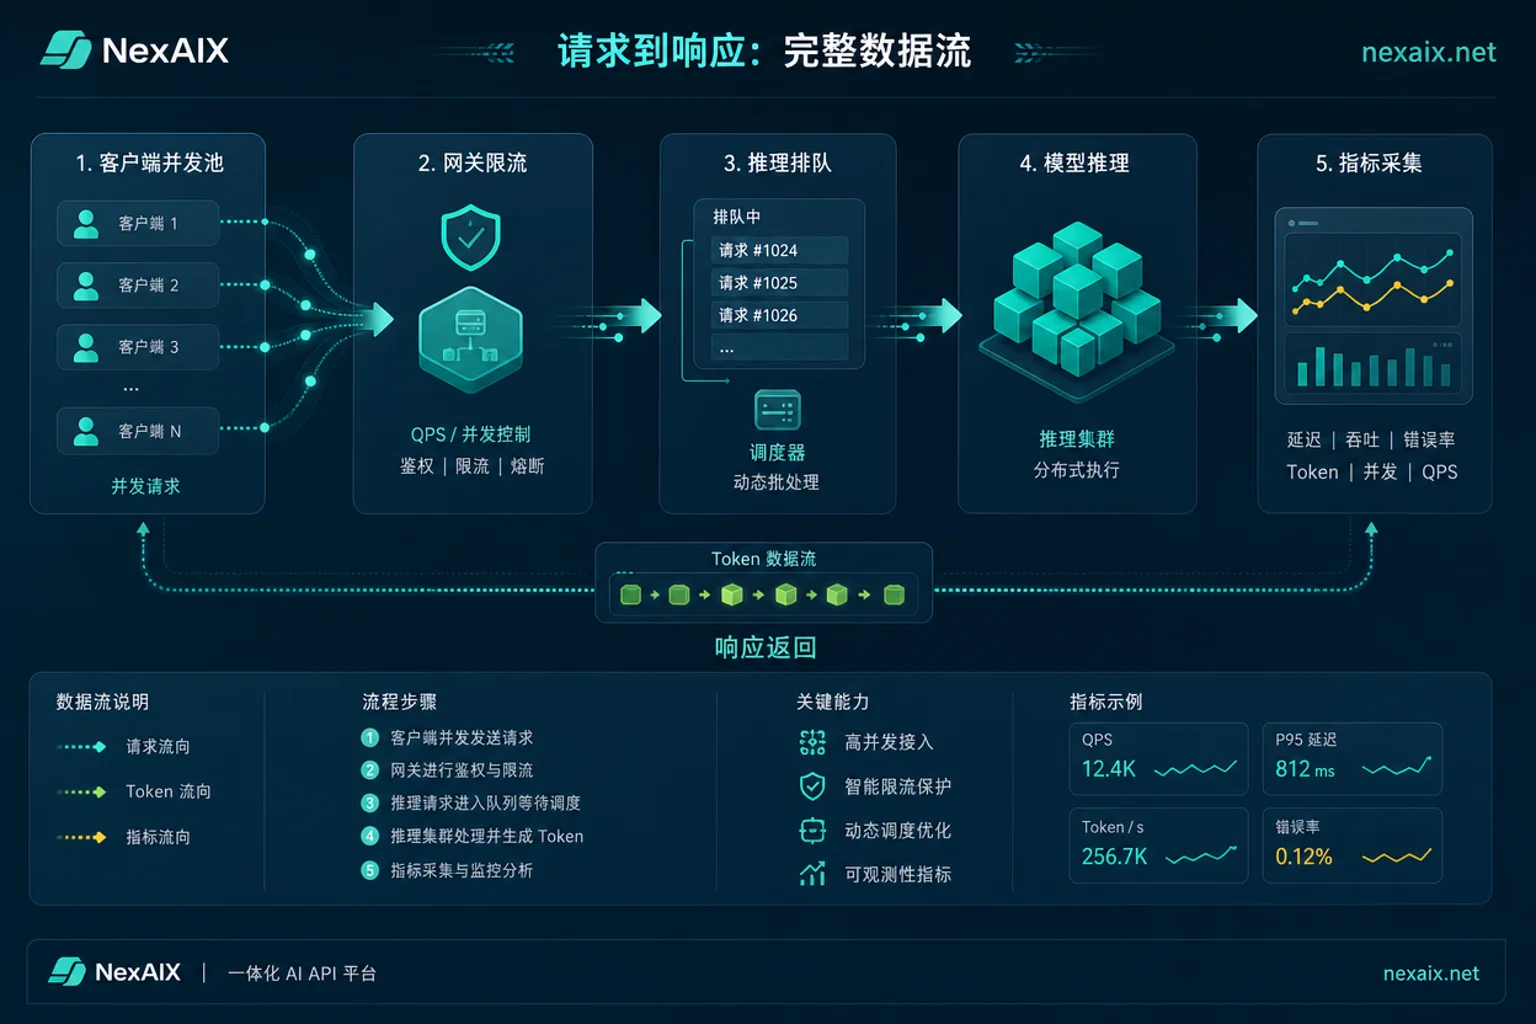
从测出的数字走到实现:用信号量或队列限制在途请求,而不是无界起协程;复用 HTTP 连接和客户端实例;按 429 响应做指数退避加抖动;区分可重试与不可重试错误;把重试次数纳入超时预算,避免尾延迟被重试放大。进阶方案是 AIMD 式自适应并发:遇 429 乘性下降,稳定后加性上升。相关细节可参考 AI API 429 报错排查 与 AI API延迟优化。
为什么并发上限必须按模型重测:一套脚本跑多模型
换模型、换版本、换供应商后,并发拐点会整体平移,必须重跑回归。使用 OpenAI 兼容接口可以让同一套压测脚本只改 model 字段,例如 NexAIX 提供 OpenAI Chat Completions 兼容接口,base_url 为 https://api.nexaix.net/v1,支持流式输出与工具调用;满载时返回标准 429 与重试建议,不静默切换到更便宜模型,返回体 model 字段对应实际执行模型,因此压测读到的拐点可复现、可归因。更多方法可参考 自有算力AI API 的 TTFT/吞吐压测方法 与 OpenAI兼容API 的 model 迁移与回归验证。
换模型或换供应商后的并发回归清单
换模型后,按下面这份清单重新确认 AI API并发的取值。
- 重跑并发梯度,确认新拐点。
- 核对新档位的 RPM/TPM 配额。
- 复核平均输出长度是否变化。
- 重算超时与退避参数。
- 确认 429 与错误码语义是否一致。
- 验证返回 model 字段是否对应实际执行模型。
- 上线后监控 p95 与 429 率,设置告警阈值。
定并发池前先在自己要用的模型上跑一轮梯度,把拐点、p95 与 429 率记成基线。若要用同一套脚本横向对比多个模型,可先在 NexAIX 的限速与配额文档核对接口说明,再用测试额度跑一轮梯度。
常见问题
并发数设多少合适?
没有通用最优值。先测拐点,取拐点的 70%–80% 作为生产池起点,再根据账户配额和业务 SLO 调整。
并发上去以后吞吐反而下降是什么原因?
服务端排队而非并行执行,超过了推理侧吞吐塌陷点,请求排队导致总吞吐下降、延迟上升。需要压测找到拐点。
RPM TPM 和并发数是什么关系?
RPM 是每分钟请求数配额,TPM 是每分钟 token 数配额。并发数受两者约束,可通过公式反推理论上限,取较小值。
Agent 循环调用怎么控制并发?
区分外层任务并发与单任务内串行步数。外层用信号量限制同时执行的任务数,内层单任务内的多步调用保持串行,避免单个任务自己就把并发池占满。
批量调用一直 429 怎么调并发?
先降并发到拐点以下,同时实现指数退避和抖动,避免重试雪崩;若仍 429,检查配额是否耗尽。
MoE 激活参数少是不是并发能开更大?
理论上单请求开销更低,但实际取决于服务商批处理、KV cache 和配额,必须实测验证,不能假设。



评论(0)