 NexAIX-官方博客
必须原样回传 assistant 消息的 content、reasoning_content、tool_calls,并让 tool 消息的 tool_call_id 与上一轮 tool_calls[].id 严格配对——这四类信息缺一不可。缺了任何一类,第二轮都可能报错或行为异常。本文以 Kimi K3 的 preserved thinking history 为典型例证,讲清楚消息历史怎么拼、字段为什么丢、以及怎么兜底。
先给结论:多轮回传必须带齐的四类字段
多轮回传时,messages 数组里需要保留四类信息:assistant 消息的 content、reasoning_content、tool_calls,以及随后的 tool 消息中的 tool_call_id。四类字段各有职责,缺失时的症状也各不相同:
| 字段 | 职责 | 缺失时的典型症状 |
|---|---|---|
| content | 模型的最终回复文本 | 对话逻辑断裂,模型似乎“失忆” |
| reasoning_content | 模型的思考过程(模型专有) | 模型可能重复推理或跳过关键步骤 |
| tool_calls | 请求调用哪个工具、参数是什么 | 模型重复发起同一次工具调用 |
| tool_call_id | 标识本次工具结果对应哪次调用 | 请求被判为历史不完整,报错或返回空结果 |
其中 tool_call_id 配对与 assistant 消息完整回传属于协议层要求(依据 Kimi K3 官方文档 2026-08 口径);症状列为多轮链路排查中的常见表现,属工程经验,具体行为随模型实现不同。
OpenAI SDK 兼容模式下 assistant 消息的结构:哪些是标准字段,哪些是模型专有字段
在 OpenAI 官方 SDK 中,assistant 消息的标准字段通常包括 role 和 content,tool_calls 也是标准字段。但 reasoning_content 这类思考链字段属于模型专有扩展,OpenAI 自身的协议并不包含,因此强类型 SDK 对象在解析响应时常常忽略或“吞掉”这个字段。这就导致一个非常常见的误判:模型返回时能看到 reasoning_content,但你把响应对象直接塞回 messages 再发出去时,它已经没了。
要避免这个坑,最稳妥的做法是:不要依赖 SDK 的消息对象回灌历史,而是保留一份原始响应 JSON(或 model_dump 后的 dict),以 dict 形式追加进 messages。这样 reasoning_content 这类非标字段就不会被 SDK 的类型转换丢掉。
为什么保留思考历史会改变多轮行为:Kimi K3 的 preserved thinking history 说明了什么
据 Moonshot AI 官方 Kimi API 文档(platform.moonshot.cn,2026-08 公开口径),2026 年 8 月发布的 Kimi K3 是一个 2.8T 总参数、激活 104B 参数的 MoE 多模态推理模型,支持 100 万 Token 上下文。官方文档明确要求保留思考历史模式(preserved thinking history):在多轮对话与工具调用时,必须完整回传包含 reasoning_content 与 tool_calls 的 assistant 消息。是否保留思考历史,直接改变多轮行为。 以下结论以该时点公开文档为准,接入前请复核最新文档。这意味着思考历史不再只是日志,而是对话状态的一部分。如果开发者沿用旧习惯,把 reasoning_content 剥离后再回传,模型可能无法理解上下文,导致重复推理或工具调用异常。
工具调用链路最容易断的两处:tool_calls 未原样回传与 tool_call_id 未配对
工具调用是多轮对话中最容易出错的环节。故障通常集中在两处:
- tool_calls 未原样回传:第二轮把 assistant 的 tool_calls 简化成纯文本,或者丢弃 arguments,模型就不知道之前请求了什么,于是重复发起同一次调用。
- tool_call_id 未配对:tool 消息的 tool_call_id 必须与上一轮 tool_calls[].id 完全一致。如果并行调用了多个工具,却只回了一条结果,请求就会被判为历史不完整。
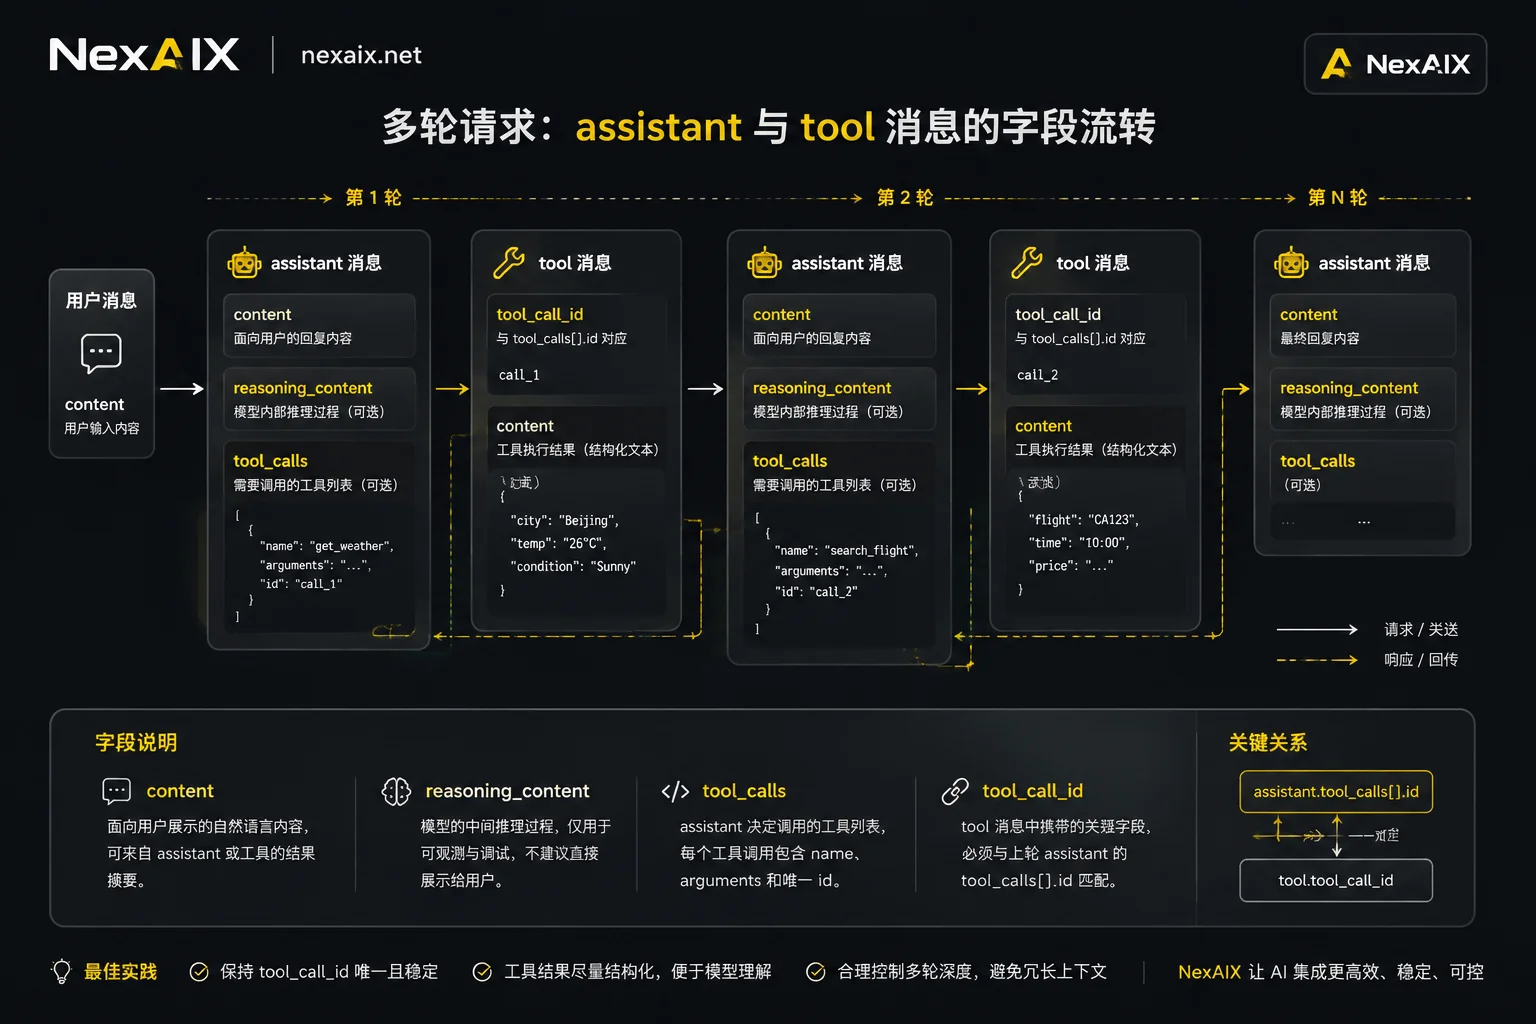
定位顺序建议:先 dump 出站请求体,确认字段是否真的发出去了;再逐条比对 tool_calls 里的 id 与 tool 消息里的 tool_call_id 是否一一对应。
SDK 强类型对象丢字段时的兜底写法:dict 消息、extra_body 与原始响应留档
工程上,建议采用以下做法来兜底:
- 保留原始响应 JSON:每次收到响应,都把完整 JSON 存一份,回传时直接以 dict 形式追加,避免 SDK 对象转换丢字段。
- 消息体内的非标字段(含 reasoning_content)靠 dict 形式的 messages 直传解决,不经 extra_body;extra_body 只用于顶层非标准请求参数的透传。
- 网关层做请求快照:在 API 网关记录出站请求体,方便出问题时复现。也可参考 多模型API网关 的做法。
下面是一个简化示例(Python 伪代码):
# 假设 resp 是 SDK 返回的响应对象
assistant_msg = resp.choices[0].message.model_dump(exclude_none=True)
messages.append(assistant_msg)  # 该 dict 自带 role='assistant'
# 并行调用时,每个 tool_calls[].id 都要 append 一条对应的 tool 消息
for tc in assistant_msg.get("tool_calls", []):
    messages.append({"role": "tool", "tool_call_id": tc["id"], "content": result})
最小复现脚本:普通问答、工具调用、追问三步对照
建议准备一份可跨模型复用的三步脚本,用于接入任何新推理模型前的自检:
- 第一轮普通提问:记录响应中出现的所有字段,特别是 reasoning_content。
- 第二轮触发工具调用:原样回传 assistant 消息和 tool 消息,观察是否正常发起调用。
- 第三轮基于工具结果追问:确认模型是否基于结果继续回答,还是重复调用工具。
下面给出一个最小可跑骨架(Python):
import json

def echo_tool_schema():
    # 任意 echo 工具即可
    return {"type": "function", "function": {"name": "echo", "description": "Returns the input", "parameters": {"type": "object", "properties": {"text": {"type": "string"}}, "required": ["text"]}}}

def run_chain(strip):
    messages = [{"role": "user", "content": "你好,请说一句话"}]
    fields_sets = []
    for turn in range(3):
        resp = client.chat.completions.create(model="...", messages=messages, tools=[echo_tool_schema()])
        msg = resp.choices[0].message
        msg_dict = msg.model_dump(exclude_none=True)
        fields_sets.append(set(msg_dict.keys()))
        if strip and "reasoning_content" in msg_dict:
            del msg_dict["reasoning_content"]
        messages.append(msg_dict)
        if msg_dict.get("tool_calls"):
            for tc in msg_dict["tool_calls"]:
                messages.append({"role": "tool", "tool_call_id": tc["id"], "content": "echo"})
        else:
            messages.append({"role": "user", "content": "请继续"})
    return fields_sets

fields_a = run_chain(strip=False)
fields_b = run_chain(strip=True)
print("字段差异:", set.union(*fields_a) - set.union(*fields_b))
同时跑两条链路做对照:一条带 reasoning_content 回传,一条剥离后再回传,记录差异。
怎么判断字段是被 SDK 丢了还是被中间层吞了
OpenAI SDK 兼容端点之间做二分定位时,可用 SDK 支持的自定义 HTTP client / 事件钩子或本地反向代理抓取出站请求体。判定分支:出站请求体里就没有 reasoning_content → 本地 SDK 序列化丢的;请求体里有、返回体里没有 → 服务端或中间层的透传问题。
具体操作:用同一套 OpenAI 兼容代码,把 base_url 切到 NexAIX 的 OpenAI base_url(https://api.nexaix.net/v1),用同一份多轮脚本核对 reasoning_content 与 tool_calls 是否原样返回,返回体的 model 字段是否对应实际执行模型,满载时是否返回标准 429 而非静默换模型。把这当作可复测的验收项,而不只是看功能是否“能用”。核对 Kimi K3 等模型的当前规格与可用性时,以 NexAIX 模型页与更新日志为准。另外,切换供应商前,参考 AI中转站怎么选 里的评估方法,能少踩一些坑。
接入新推理模型前的多轮回归核对清单
OpenAI SDK 兼容接入新模型前,先跑完下面这份清单:
- [ ] 响应字段清单留档:记录首次响应的所有字段,作为基准。
- [ ] assistant 消息原样回传:content、reasoning_content、tool_calls 一个不少。
- [ ] tool_call_id 全量配对:每个工具调用都有对应的 tool 消息。
- [ ] 并行调用结果齐全:并行发起多个工具时,结果全部回传。
- [ ] 历史裁剪策略:思考历史会占上下文,裁剪时需考虑是否丢弃以及如何丢弃。
- [ ] 上下文预算监控:思考历史会让 token 消耗变快,设置监控点。
- [ ] 切换供应商后复跑同一份脚本,比对字段差异,可参考 AI中转站掺水 的风险提示。
常见问题
reasoning_content 要不要回传?
要。对于要求保留思考历史的模型(如 Kimi K3),reasoning_content 属于协议要求,必须原样回传。否则多轮行为可能异常。
推理模型思考历史不回传会怎样?
可能不会立刻报错,但模型会丢失上下文,导致重复推理、重复工具调用或结果异常。建议保留。
openai python sdk 不识别 reasoning_content 怎么办?
SDK 强类型对象可能忽略该字段。解决办法是留存原始响应 JSON(或 message.model_dump()),以 dict 形式追加进 messages;extra_body 只管顶层非标请求参数,解决不了消息字段丢失。
tool_calls 和 tool_call_id 对不上怎么办?
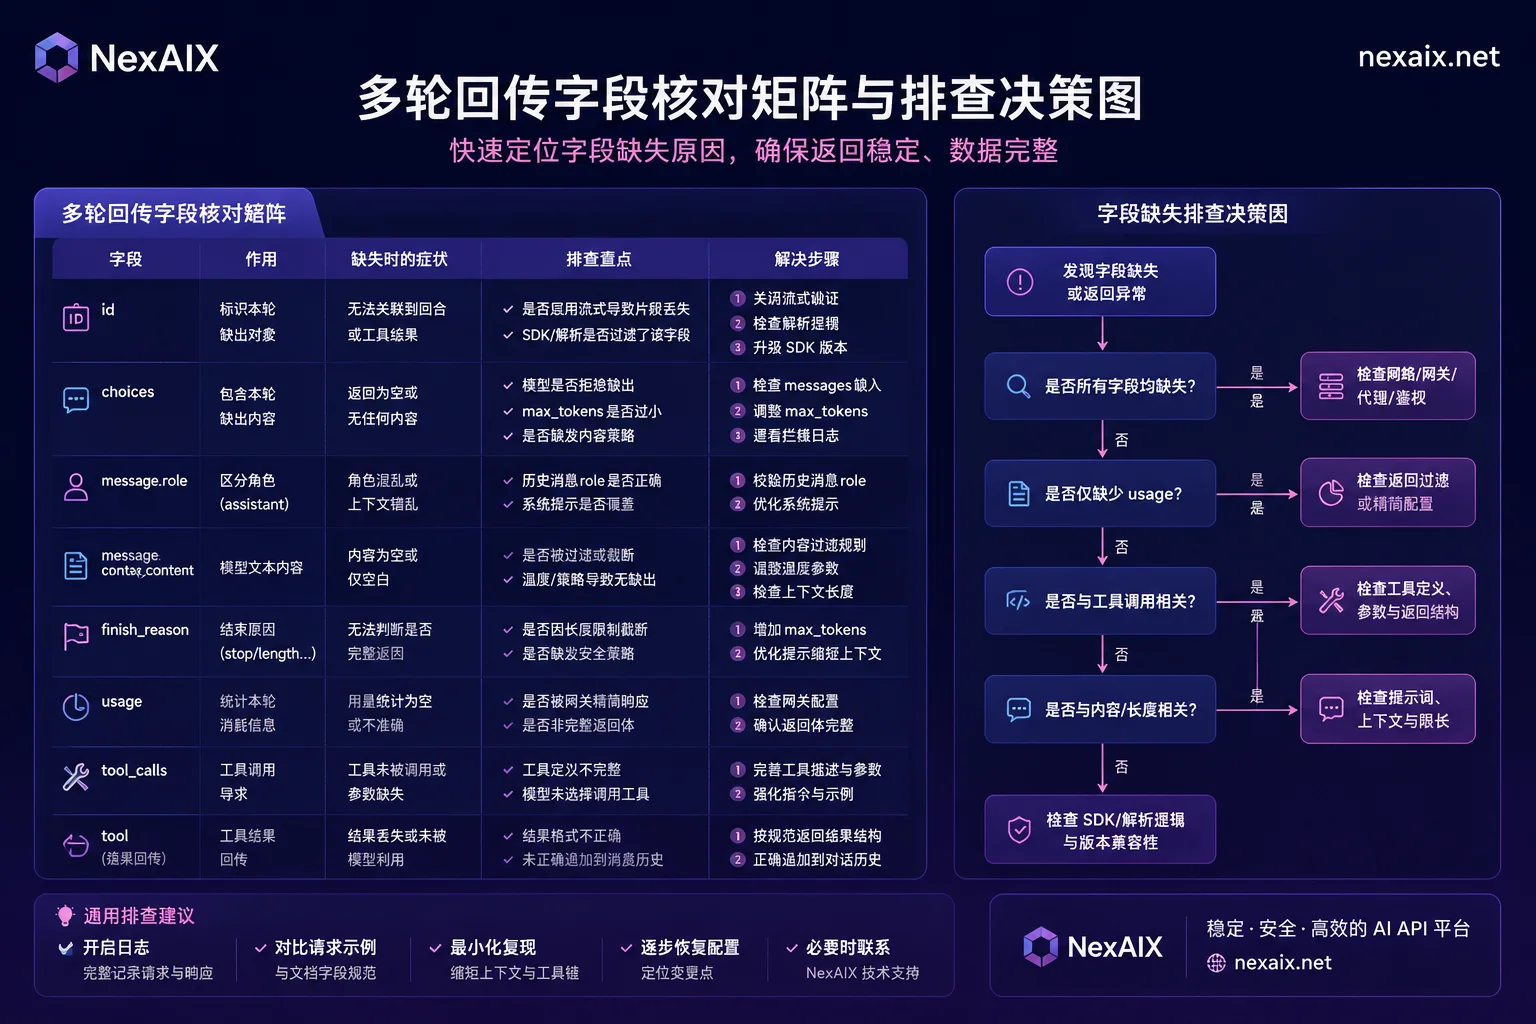
先 dump 请求体,检查 tool_call_id 是否与上一轮 tool_calls.id 完全一致。并行调用时,确保每个工具都有对应结果。
思考历史会把上下文撑爆吗?
会占用 token,Kimi K3 有 100 万上下文,但长对话仍需注意预算。可考虑裁剪旧思考历史,但需确认模型是否允许。



评论(0)