 NexAIX-官方博客
选择长上下文API只看5个判据:有效可用长度、单次调用成本、前缀缓存命中率、TTFT劣化曲线、多模态折算口径。你不需要被“1M窗口”的宣传冲昏头脑,也不需要盲目退回RAG。先把这5个数字算清楚,再决定扩窗口还是做检索。
最近,Kimi K3(2.8T总参/104B激活的MoE模型)已在多家第三方推理平台上线,原生支持1,048,576 token的多模态上下文,让百万级窗口第一次成为API可选项。但这不意味着你可以无脑塞满——以下的判据会告诉你为什么。
先给结论:什么场景该扩窗口,什么场景仍然要做检索切分
如果你的业务文档经常被重复提问,且前缀(系统提示词+固定文档)能长期不变,那么直接扩窗口通常更划算;如果文档只用一次、语料库远超窗口,或需要精确溯源,那么RAG检索切分仍然是更好的选择;如果两者混合——先检索粗筛、再用长窗口精读,是多数生产系统的实际形态。
判据一:声明上下文长度不等于有效可用长度,怎么自己测出拐点
厂商宣传的最大可输入sequence长度,跟业务里的有效可用长度之间存在落差。字面“大海捞针”式检索容易全绿,但跨段综合和隐式关联往往在32K~64K就开始衰减。
自测方法:用你自己的业务问答集做长度梯度,把答案锚点分别放在文档的头、中、尾,观察正确率随长度变化的拐点。这个拐点必须自己测,不要照搬别人的数字。把长度梯度做成可重复的回归任务,写法可参考AI模型评测。
判据二:每次调用的输入成本 = 实际填充 token × 单价,先算再选
单次调用输入成本 = 实际填充token数 × 单价;日调用量乘以频次就是月度总额。大多数场景根本填不满窗口,真正决定账单的是平均填充量与调用频次。
| 平均填充量 | 日调用量 | 月成本倍数 | 说明 |
|---|---|---|---|
| 8K | 1万 | 1× | 多数RAG查询的实际长度 |
| 32K | 1万 | 4× | 中等文档摘要 |
| 128K | 1万 | 16× | 长文档直接处理 |
| 512K | 1万 | 64× | 接近全量填充 |
所以,把窗口上限和实际填充量分开算,你会发现自己根本不需要1M。把平均填充量、缓存命中率和调用频次一起纳入核算,可参考AI API成本优化的拆项方法。
判据三:固定前缀能不能被缓存覆盖,决定长上下文API的边际成本
高频多轮与Agent场景下,长上下文API的边际成本高度依赖前缀提示词缓存。前缀命中时输入计费通常可获得大幅折扣,业内常见区间在 80%~90% 一档,但各平台的折扣比例、最小可缓存长度与缓存留存时长各不相同,必须以你所用平台的当前文档为准。
工程建议:把系统提示词和长文档放在前缀不变段,把变动内容后置,并持续监控缓存命中率。关于缓存保留策略,可以参考大模型API缓存能保留多久。
判据四:TTFT 随填充长度怎么劣化,用长度梯度和并发梯度分别测
Prefill算力和通信开销随上下文长度增长是物理规律。未命中缓存时,接近百万级填充会把首token延迟从秒级推到数十秒级别,这是架构决定的。
测法:固定并发跑长度梯度,固定长度跑并发梯度,分别记录TTFT与整体完成时间。流式输出下,用户感知的是TTFT而非总耗时。要更深入理解延迟组成,可以阅读AI API延迟一文。
判据五:多模态输入的 token 折算口径,图像与视频怎么并入预算
1M原生多模态窗口意味着图像和视频帧也要折算成token占用同一预算,不同平台折算口径可能不同。做法:用一份固定素材实测usage返回的token数,反推折算比例,再写进你的上下文预算表。具体系数以各平台文档为准。
1M 档位现在长什么样:以 Kimi K3 的 MoE 架构与原生多模态窗口做参照
Kimi K3是Moonshot AI发布的2.8T总参数、104B激活的开源MoE模型,采用896专家中激活16专家的Stable LatentMoE架构与Kimi Delta Attention机制,原生支持1,048,576 token的文本、图像与视频多模态长上下文。截至2026年8月,它已被DeepInfra、OpenRouter等多家平台上线提供API服务。以上规格与上线状态为 2026 年 8 月的公开信息,来自第三方推理平台的模型页与开发者指南,并非厂商官方口径的完整参数表;具体上下文上限、多模态支持范围与可用性以官方文档和各平台模型页当前信息为准。
注意:MoE稀疏激活降低的是单token计算量,不改变长上下文Prefill与KV缓存随长度增长的开销,所以“参数稀疏”不等于“长窗口便宜”。
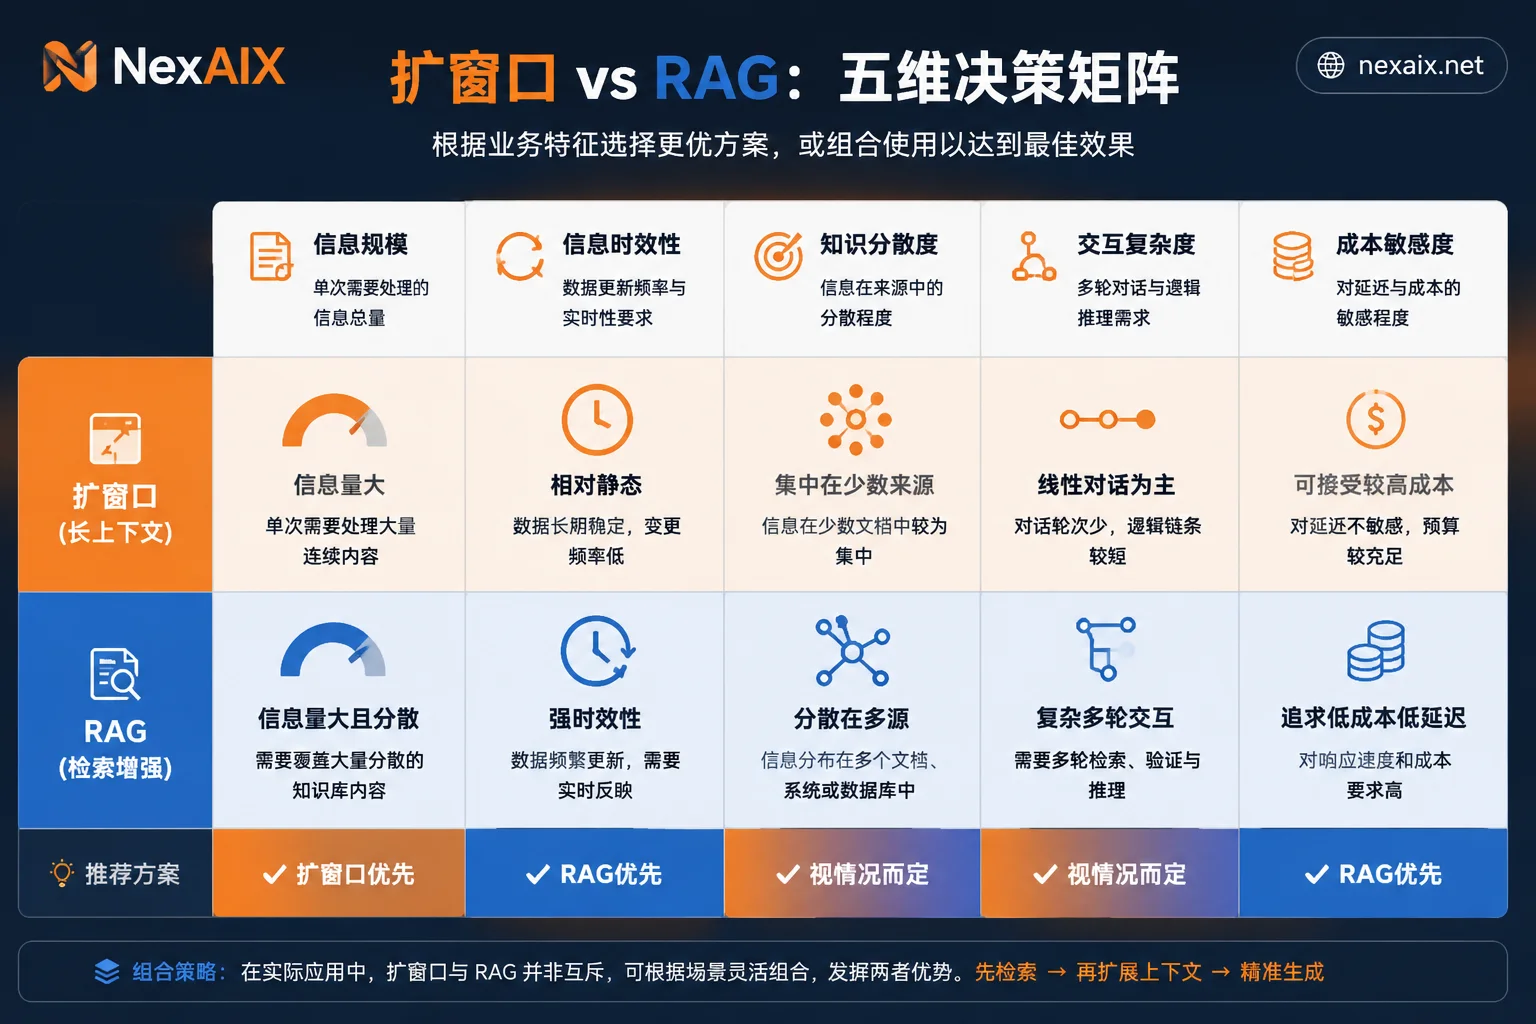
扩窗口 vs 检索切分的分流规则:按文档复用率与问答轮次决定
| 场景特征 | 倾向方案 | 理由 |
|---|---|---|
| 同一文档多轮问答、前缀可缓存 | 扩窗口 | 缓存命中后边际成本极低 |
| 文档一次性使用、语料库超大 | 检索切分 | 避免无效填充 |
| 需要精确溯源与引用 | 检索切分 | 长窗口注意力分散 |
| 多跳综合推理、隐式关联 | 先测拐点再定,默认混合 | 长窗口提供全局信息,但该类任务的有效长度衰减最早,超过实测拐点后应改为检索粗筛 + 长窗口精读 |
混合方案(先检索粗筛,再用长上下文API精读)在多数生产系统中最实用。
最小可复现脚本:同一份长文档跑多模型的长度梯度对照
下面脚本用OpenAI兼容接口,把base_url指向https://api.nexaix.net/v1后,只改model参数就能在同一套代码上跑完全部长度梯度,避免SDK差异污染对照。流式输出用于测TTFT,返回体的model字段可核对实际执行模型,遇到429需按重试建议退避。
import openai, csv, time

client = openai.OpenAI(base_url="https://api.nexaix.net/v1", api_key="YOUR_KEY")

original_doc = open("your_doc.txt", encoding="utf-8").read()
# 按字符近似截断,真实 token 数以 usage 为准
char_lengths = [8192, 32768, 131072, 524288]
questions = ["文档的核心结论是什么?", "第二处的论据是什么?"]

with open("results.csv", "w", newline="") as f:
    writer = csv.writer(f)
    writer.writerow(["len", "question", "input_tokens", "ttft", "total_time", "answer"])
    for L in char_lengths:
        doc = original_doc[:L]
        for q in questions:
            messages = [{"role":"system","content":"你是一个严谨的分析师。"}, {"role":"user","content": doc + "\n\n" + q}]
            t0 = time.time()
            stream = client.chat.completions.create(model="kimi-k3", messages=messages, stream=True, stream_options={"include_usage": True})
            chunks = []
            ttft = None
            usage = None
            for chunk in stream:
                if ttft is None and chunk.choices[0].delta.content:
                    ttft = time.time() - t0
                if chunk.choices[0].delta.content:
                    chunks.append(chunk.choices[0].delta.content)
                if chunk.usage:
                    usage = chunk.usage
            total = time.time() - t0
            prompt_tokens = usage.prompt_tokens if usage else L
            writer.writerow([L, q, prompt_tokens, ttft, total, "".join(chunks)])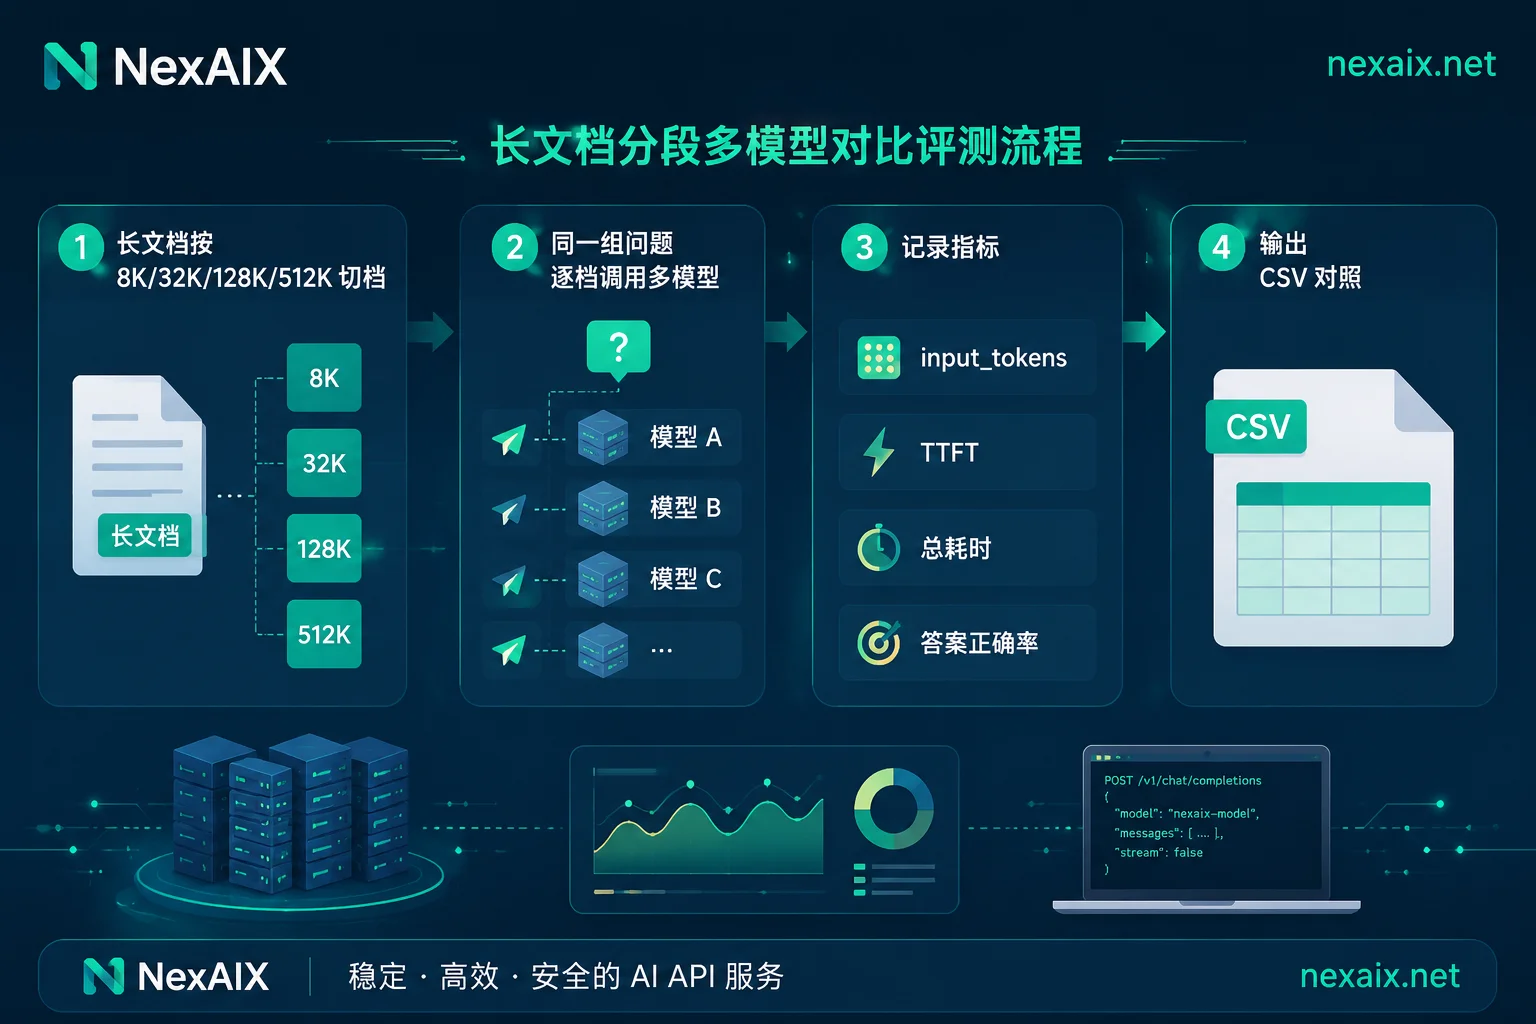
具体模型的上下文上限、多模态支持与单价,请到NexAIX模型页与定价页核对当前信息。
换模型前必跑的长上下文API回归清单
更换长上下文API供应商前,以下六项必须逐条重测。
- [ ] 有效长度拐点是否重测(用业务问答集)
- [ ] 前缀缓存是否仍然命中(监控命中率)
- [ ] TTFT在目标并发下是否达标(长度与并发梯度)
- [ ] 多模态折算比例是否变化(用固定素材实测)
- [ ] context length exceeded的降级路径是否就绪(自动截断/分段摘要/回退检索)
- [ ] 返回体model字段与预期一致
这份清单可以直接复制进内部文档,上线前逐项勾选。
常见问题
百万上下文实际能塞多少字?
不同分词器对中文的切分粒度差异很大,不要用固定比值估算。做法:取一段 1 万字的真实业务文本调用一次接口,读取返回体 usage.prompt_tokens,用「字数 ÷ token 数」得到你这条链路上的实际换算系数,再乘 1,048,576 反推可容纳字数;同一份文本在不同模型上系数可能相差三成以上。有效长度远低于窗口上限,仍以判据一的实测拐点为准。
长上下文首token为什么这么慢?
未命中缓存时,Prefill需要处理全部输入token,计算量随长度线性增长,1M级别会导致数十秒的TTFT。这是架构物理限制,不是某家平台的缺陷。
MoE模型长上下文吞吐会掉吗?
MoE 的稀疏激活降低的是单 token 的激活计算量,与稠密模型相比在同等总参规模下推理更省算力;但长上下文的 KV 缓存占用与 Prefill 通信开销不因稀疏化而减少,吞吐仍随填充长度上升而下降。具体幅度与部署方案(并行策略、量化精度)强相关,需在目标平台按判据四的并发梯度自测。
context length exceeded 报错怎么解决?
首先将请求拆分成多个短片段,或使用摘要。其次开启自动截断或回退检索。长期方案是评估是否需要扩窗口,或改用层级摘要。
1M上下文模型和RAG哪个更划算?
取决于文档复用率:高频多轮且前缀可缓存时,扩窗口更划算;一次性或超大语料库时,RAG更省。建议用本文的长度梯度脚本测出成本与延迟后再决定。



评论(0)