 NexAIX-官方博客
接入 DeepSeek API 并不需要推翻现有代码——沿用 OpenAI 兼容接口,只需核对 model 标识、上下文与输出预算、思考模式与工具调用回传、调用形态、计费口径、错误码定位这六项。2026年8月13日 DeepSeek-V4-Pro GA 正式上线(deepseek-v4-pro-0813),原生支持 Responses API,8月16日起平峰期价格降低 50%,这些变化让重新核对一遍配置变得必要。
以下是六项核对表的速览,每一项在正文都有展开:
| 核对项 | 关键动作 | 注意事项 |
|---|---|---|
| model 标识 | 写具体版本号 deepseek-v4-pro-0813 | 别名可能变动 |
| 上下文与输出预算 | 预留输出上限,再倒推输入 | 1M 是共享窗口 |
| 思考模式与工具调用 | 回传 tool_call_id 与配对消息 | 多轮拼接易错 |
| 调用形态 | 按需选 Chat Completions 或 Responses | 已有系统不必强切 |
| 计费口径 | 缓存命中/未命中 + 分时系数 | 平峰 5 折,具体时段看官方 |
| 错误码定位 | 400/404/429 分类排查 | 先最小复现 |
先给结论:接入 DeepSeek API 只需核对这 6 项
1.6T 总参数、49B 激活参数、1M 上下文、思考模式与工具调用、原生 Responses 支持——这些是本次 GA 后配置层面真正受影响的点;无论从零接入还是从旧预览端点迁移,下面六项都要逐条过一遍。
核对一:model 参数填什么,别名还是具体版本号
model 参数应写在配置层,而不是散落在代码各处。数据包/官方公告中已确认的标识是 deepseek-v4-pro-0813;若官方文档的模型列表中同时提供版本别名,则两种写法的取舍如下表。
| 写法 | 适用场景 | 风险 |
|---|---|---|
| 具体版本号(如 deepseek-v4-pro-0813) | 生产链路,要求行为稳定可复现 | 升级需手动改 |
| 版本别名 | 实验链路,希望自动跟进最新能力 | 行为可能变化;是否提供别名及其指向以官方文档当前模型列表为准 |
切换后务必校验返回体中的 model 字段与请求一致,确保实际执行的是目标模型。多端点接入时这条尤其要验——例如 NexAIX 公开承诺返回体 model 字段对应实际执行模型,验收脚本可直接断言这一点。关于旧别名的弃用时间表,官方未公布,请以官方文档当前列出的模型列表为准。
核对二:1M 上下文怎么分预算,输入塞多少才不挤掉输出
1M 上下文窗口是输入与输出共享的预算,并非可以无脑塞满。建议按以下方法分配:
- 先按最坏情况预留输出上限(具体数值请以官方模型页为准);
- 用总窗口减去输出预留,得到输入可用额度;
- 再留出 5%~10% 余量给模板与工具描述,防止超出。
长文档场景下,可选用截断、分段或检索三种方式取舍。截断会丢失尾部信息,分段可配合多次调用,检索则引入额外组件。实际能塞多少内容,取决于你的输出预留和工具描述长度,因此需要结合业务自测。三种方案的选型对照可参考长上下文API怎么选。
核对三:思考模式与工具调用的多轮回传,哪些字段必须原样带回
多轮对话中,助手消息里的工具调用结构与 tool_call_id 必须与工具返回消息配对。下一轮请求是否要带回思考内容,判断依据是官方文档对该字段的回传要求;工具调用结构与参数则必须原样保留,否则模型无法接着执行。各字段的精确名称与结构以官方 API 文档当前定义为准,多轮拼接的通用写法可参考工具调用API。
最小多轮循环骨架如下(消息数组增长方式):
- 用户消息
- 助手消息(含 tool_calls,每个有 id 和参数)
- 工具消息(role=tool,带 tool_call_id 和结果)
- 再跟用户消息或助手消息继续
并行多工具调用时,工具返回消息的顺序需与工具调用顺序一致。
核对四:Chat Completions 还是 Responses,怎么选与保守迁移路径
V4 Pro 原生支持 Responses API,但已有系统不必立刻切换。选择判据如下:
| 场景 | 推荐形态 | 理由 |
|---|---|---|
| 需要服务端会话状态 | Responses | 简化状态管理 |
| 已有成熟 Chat Completions 中间层 | 暂不切换 | 改动风险大 |
| 多端点对照,要求同一套请求体 | Chat Completions | 兼容性更好 |
保守迁移路径:先在新链路试点 Responses,旧链路保持 Chat Completions,用同一组用例双跑比对输出结构差异。相关迁移可参考 OpenAI API迁移到Responses。
核对五:计费口径怎么核,缓存命中与分时窗口怎么并进单价
DeepSeek API 的成本核算,口径比具体数字更重要。加权单价 = 输入单价(区分缓存命中/未命中)乘以输入量 + 输出单价乘以输出量,再乘以分时系数。
2026年8月16日起施行的平峰期 5 折,意味着批处理、离线评测、日志摘要这类可调度任务值得排到平峰窗口;但在线交互不应为此牺牲体验。平峰时段的具体起止与时区、各档单价,请以官方定价页当前值为准,本文不给出数字。
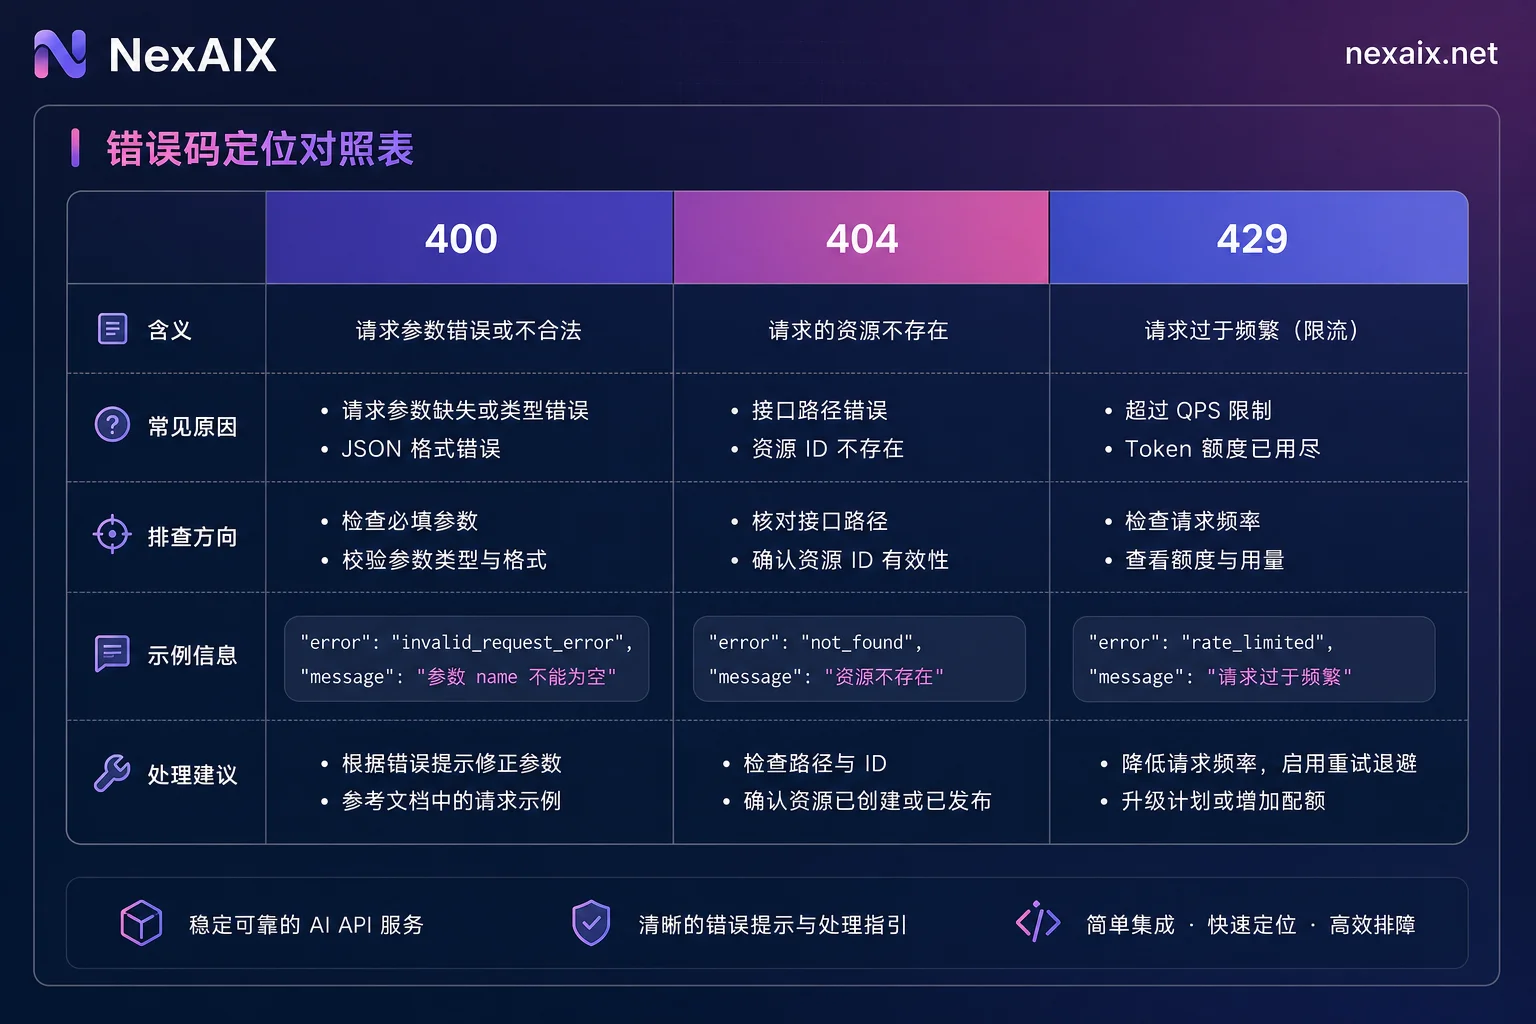
核对六:错误码定位——400 改请求体、404 查 model、429 走退避
| 现象 | 最可能原因 | 第一步动作 |
|---|---|---|
| 400 Bad Request | 参数或消息结构问题(工具消息缺配对、字段类型错误) | 用最小请求体复现,逐字段加回 |
| 404 / model not found | 版本别名拼写错误、端点与模型不匹配 | 核对 model 标识,确认端点支持该模型 |
| 429 Too Many Requests | 并发超限 | 指数退避加抖动,检查并发上限 |
排查时先用最小请求体复现,再逐步加字段,能快速定位问题。选型时也应确认服务方满载时返回标准 429 与重试建议,而不是静默换成更便宜的模型。
官方已确认 vs 必须自测:三类指标只能自己压
DeepSeek API 官方已确认的规格包括:1.6T 总参数、49B 激活参数、1M 上下文、思考模式与工具调用、原生支持 Responses API、分时定价机制。SiliconFlow、Fireworks AI 已跟进上线同名端点,其中 Fireworks 公布其在 SWE-bench 与 CyberGym 上展现低成本与零拒绝率特性,但不同平台的部署与调度不同,跨平台不能互相引用性能结论。
必须自测的部分:首 token 延迟、长上下文下的并发吞吐、长链工具调用的稳定性,这些只能在你自己的业务数据上压测得出。
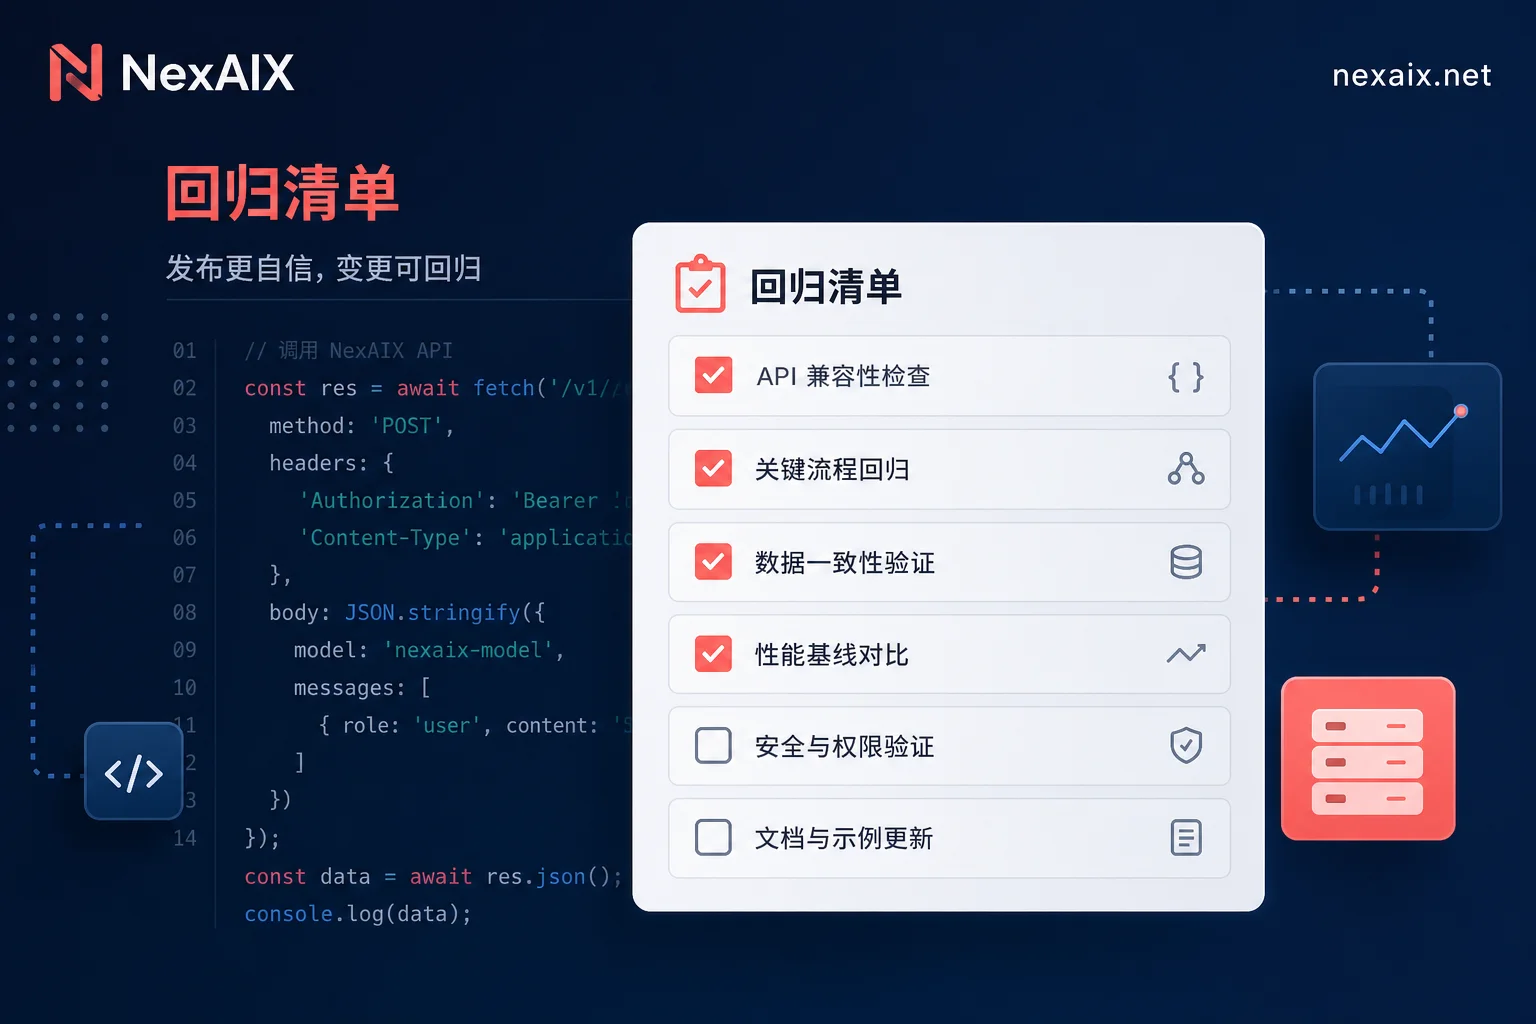
接入后必跑的回归清单与最小复现脚本思路
切换 DeepSeek API 端点后建议跑以下回归项,每项用固定输入固定参数,结果落盘做版本间 diff:
- [ ] 单轮非流式请求
- [ ] 流式分片与中断恢复
- [ ] 单工具调用
- [ ] 并行多工具调用
- [ ] 超长输入截断
- [ ] 429 退避逻辑
- [ ] 超时重试幂等
- [ ] 返回体 model 字段校验
同一套 OpenAI 兼容代码只改 base_url 与 model 即可做多端点对照。例如在 NexAIX 的 https://api.nexaix.net/v1 使用测试额度分别跑一遍,具体规格与价格以官方模型页与定价页为准。
常见问题
model 参数到底要填什么?
生产环境建议填具体版本号 deepseek-v4-pro-0813,实验环境可用版本别名。务必在返回体中校验 model 字段与请求一致,避免实际执行了非目标模型。具体列表以官方文档为准。
deepseek-v4-pro-0813 怎么调用?
调用方式与 OpenAI 兼容:设置 base_url 和 api_key,model 填 deepseek-v4-pro-0813,即可发起请求。可参考 OpenAI base_url 怎么改 一文。
DeepSeek API 报 model not found 是什么原因?
通常是 model 标识拼写错误、端点与模型不匹配,或该端点未开通该模型。先检查拼写,再用最小请求体测试,确认端点支持。
DeepSeek API 支持 Responses API 吗?
支持,V4 Pro 原生支持 Responses API。已有系统可先试点,不必强制切换,用同一组用例双跑比对输出差异。
工具调用怎么传参?
通过 messages 数组,助手消息带 tool_calls,工具返回消息带 tool_call_id 配对。并行调用时顺序需一致,字段细节以官方文档为准。
1M 上下文实际能塞多少内容?
取决于输出预留与工具描述长度。建议先预留输出上限,再计算输入额度,并留 5%~10% 余量,实际可用量需自测。具体输出上限数值以官方模型页为准。



评论(0)