 NexAIX-官方博客
GPT-5.6 Sol API 当前输入 $4.00/1M tokens、输出 $20.00/1M tokens、缓存读取 $0.40/1M、缓存写入 $5.00/1M。该价格自 2026 年 8 月 21 日生效,OpenAI 官方承诺至少持续至 2026 年 11 月 21 日。真正要重算的是你的加权单价,而不是标价。
GPT-5.6 Sol API 单价怎么读:四档计费口径与促销窗口边界
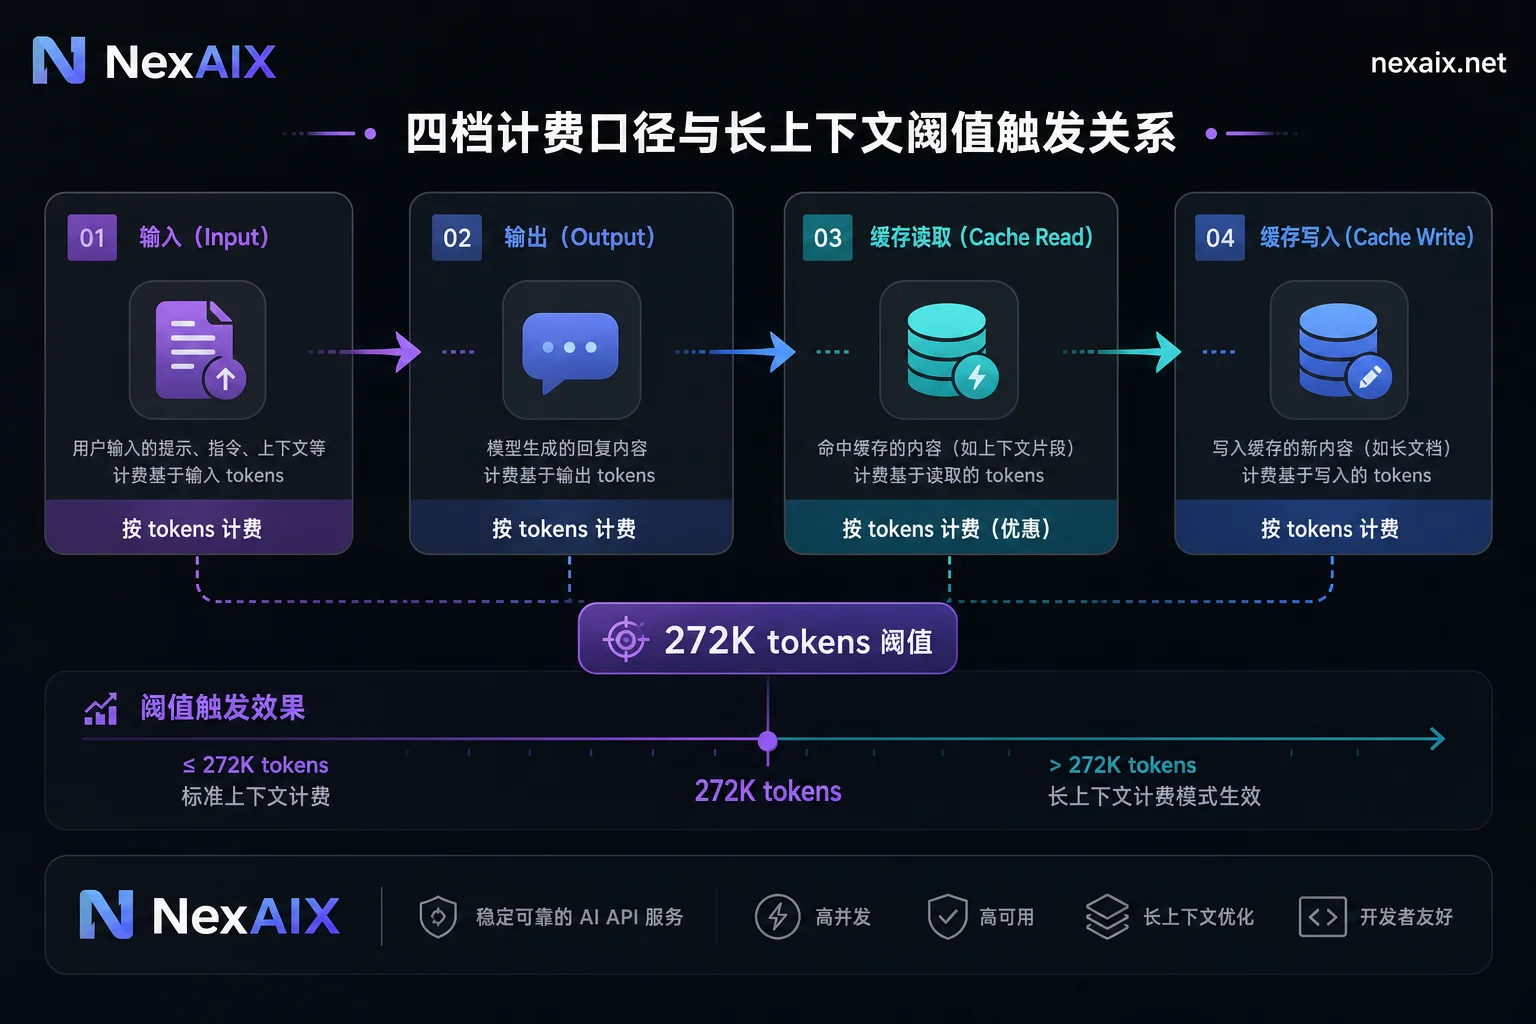
本次调价涉及四档计费,其中输出降幅最大,达到 33.3%。同时要注意,单次请求输入超过 272K tokens 时,会触发长上下文计费,输入按 2 倍、输出按 1.5 倍计算,这一条很容易被漏算。
| 计费项 | 促销价(/1M tokens) | 原价(/1M tokens) | 降幅/说明 |
|---|---|---|---|
| 基础输入 | $4.00 | $5.00 | 降 20% |
| 输出 | $20.00 | $30.00 | 降 33.3% |
| Cached Input(缓存读取) | $0.40 | — | 相当于基础输入 90% 折扣 |
| Cache Write(缓存写入) | $5.00 | — | 为基础输入价的 1.25 倍 |
值得注意的是,OpenAI 与 AWS Bedrock 的公告均使用“至少持续至 2026年11月21日”的措辞,意味着到期后可能延续,也可能调整或恢复原价。所以,在做预算时不能把 $4.00/$20.00 当成永久牌价。本文单价与促销期限均以 OpenAI 官方定价与模型文档(developers.openai.com)为准,为目前可核对的唯一公开来源;第三方聚合平台的费率可能不同,落地前请以你实际调用渠道的定价页为准。
用自己的请求分布折算:输入输出比决定这次降价到底让利多少
下表为按假设请求分布做的演算示例,占比数字需替换为你自己近 30 天日志中的真实分布,单位为每百万 token 的加权美元单价。不同链路的输入输出比例差异巨大,加权单价 = 输入占比 × 输入价 + 输出占比 × 输出价。由于输出降幅大于输入,输出占比越高的链路,本次让利越明显。
| 链路类型 | 输入占比 | 输出占比 | 加权单价(促销价)(示例) | 加权单价(原价) | 降幅 |
|---|---|---|---|---|---|
| 长文档摘要 | 80% | 20% | $7.20 | $10.00 | 28% |
| Agent 多轮调用 | 70% | 30% | $8.80 | $12.50 | 29.6% |
| 推理链路 | 40% | 60% | $13.60 | $20.00 | 32% |
以每千次请求为例,假设平均每次输入输出各 1000 tokens,长文档摘要类每千次成本约为 $7.2,而推理链路为 $13.6。这直接说明,推理模型换回旗舰档是否划算,必须按链路分别测算,而不是一个结论套全站。
Prompt Caching 命中率在哪里查看:把估算换成可核对的数字
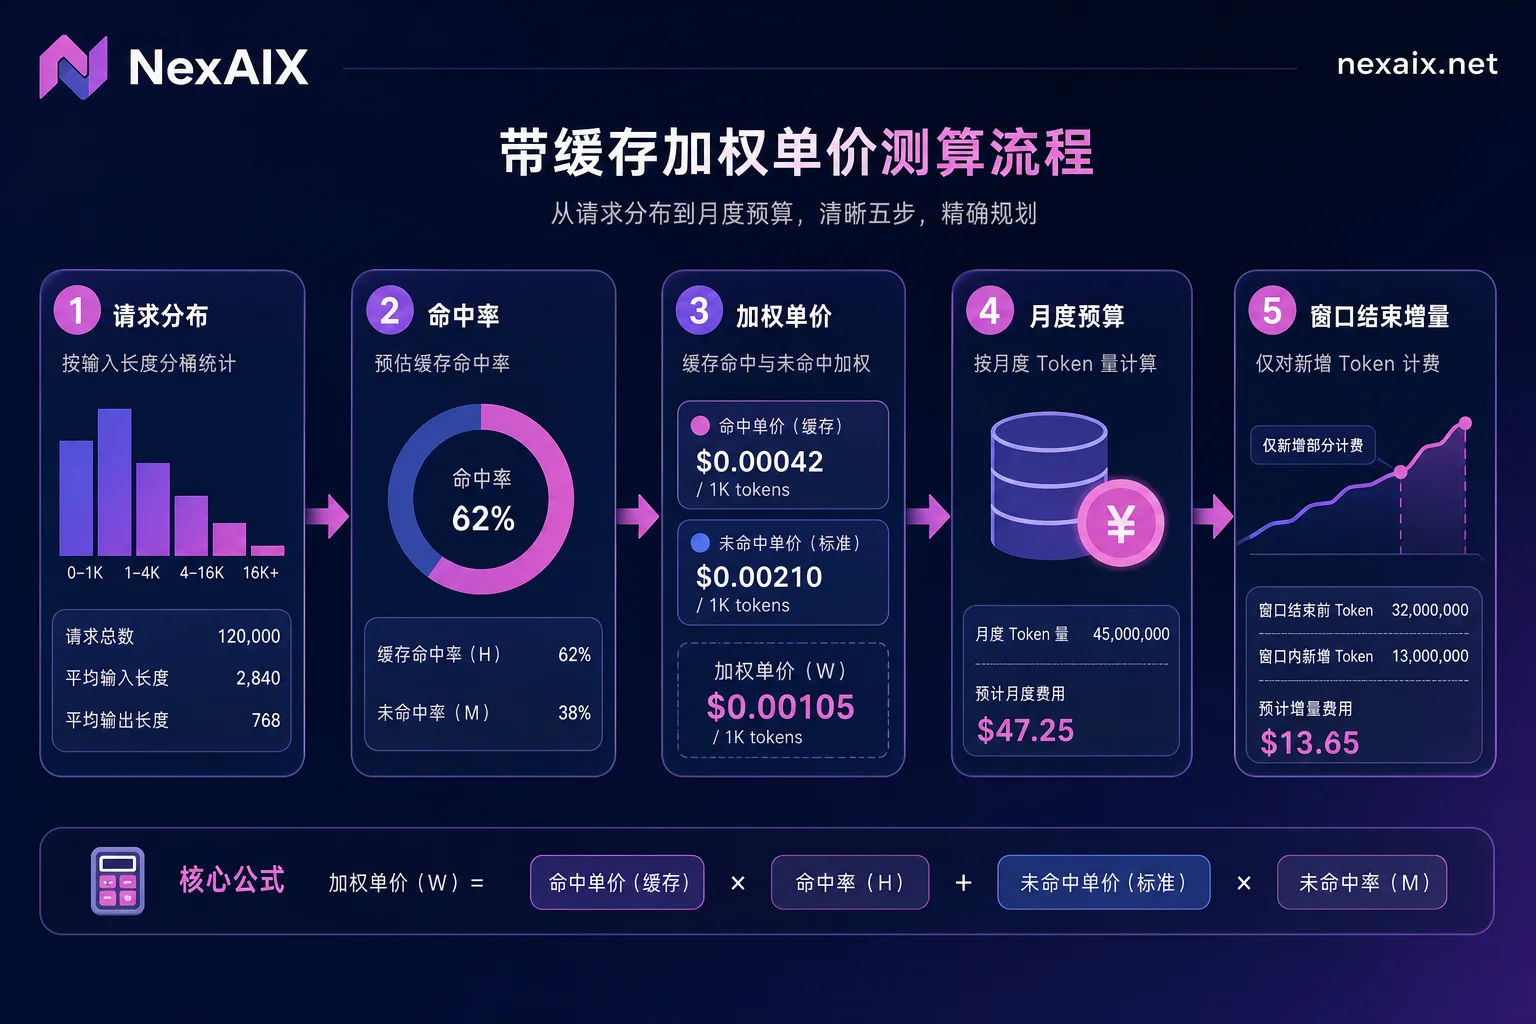
要精确计算实际成本,不能只靠估算。API 响应中的 cached_tokens 字段会返回缓存命中量,控制台的 Usage 或 Prompt Caching Dashboard 里可以看到实际命中率。通过显式断点或自动缓存,把固定系统提示词、工具定义、知识库检索片段稳定放在前缀,就能将重复输入从 $4.00/M 摊薄到 $0.40/M。带缓存加权单价 = 输入占比 ×[(1 − 命中率) × 输入价 + 命中率 × 缓存读取价]+ 输出占比 × 输出价。若首次写入缓存,还需按 Cache Write $5.00/1M 单独计入写入成本。低复用前缀可能因写入成本反而变贵,需要提前评估。
Ultrafast 档位:现在能确定什么、不能确定什么
目前,OpenAI 的 Ultrafast mode 仍处于定向预览阶段,面向高吞吐低延迟推理场景,但正式商用的加价倍率与 GA 时间表均未公开。因此,在月度预算测算模型中,应将其列为待定参数单独预留一行,不并入主口径。在预览档位上做的延迟测试结论,也不能直接外推为正式档位的成本或性能承诺。
促销窗口结束的回退预案:降档触发线与模型开关怎么提前留
把 2026年11月21日当作一个需要提前编排的运维事件。首先,在预算模型里同时保留促销价与恢复原价(输入 $5.00/M、输出 $30.00/M)两套算法,算出窗口结束后的月度成本增量。其次,设定降档触发线,例如某链路月成本占比超过阈值时,就切到低价档模型。最后,在代码层把模型名做成配置项而非硬编码,这样切换时无需改动业务逻辑。官方措辞是“至少持续至”,预案的价值在于无论涨跌,你都不必临时改代码。按量计费AI API怎么算月度成本一文中提到的加权方法可以直接套用。
重算 GPT-5.6 Sol API 月度成本的可执行清单(6 项)
建议按以下六步操作:
- 按链路统计近 30 天真实输入/输出 token 分布。
- 核对是否有请求越过 272K 长上下文阈值。
- 从仪表盘取真实缓存命中率,而不是估算值。
- 算出带缓存加权单价,并乘以预计月请求量。
- 按恢复原价再算一遍,得出窗口结束后的增量。
- 为 Ultrafast 等未定价能力预留独立预算行。
此外,如果你已经在用 OpenAI Chat Completions 兼容接口(base_url https://api.nexaix.net/v1),只需修改 model 参数即可完成跨模型成本对照,业务逻辑无需变动。建议到 NexAIX 模型页与定价页核对 GPT-5.6 Sol 的当前规格与可用性,用测试额度按自己的真实请求分布跑一轮再定预算。
常见问题
GPT-5.6 Sol API 现在多少钱一百万 tokens?
输入 $4.00/1M,输出 $20.00/1M。如果开启缓存读取,命中部分只需 $0.40/1M。注意这是促销价,官方承诺至少到 2026年11月21日。
gpt-5.6 sol 输入和输出 token 价格差多少?
按当前促销价折算,输出单价 $20.00/1M 约为输入单价 $4.00/1M 的 5 倍(该倍数为按公开单价折算所得,非官方单独公布的口径)。但输出降幅更大(降 33.3% vs 20%),所以输出占比高的链路本次让利更明显。
GPT-5.6 Sol 降价会持续到什么时候?
官方表述是“至少持续至 2026年11月21日”。到期后可能延长,也可能调整或恢复原价,建议提前做好预案。
prompt caching 命中率在哪里查看?
在 OpenAI 控制台的 Usage 或 Prompt Caching Dashboard 里可以查看实际命中率。同时 API 响应的 cached_tokens 字段会返回每次请求的缓存命中量。
Ultrafast mode 要不要额外付费?
目前还没有公开的加价倍率或计费细则,它仍处于定向预览阶段。如果业务依赖该档位,建议先在预算中单独留一个待定行,等官方公告后再定。
推理模型换回旗舰档划算吗?
先用近 30 天日志算出该链路的带缓存加权单价与月度总额,再与你当前所用低价档模型的实际账单对比,逐链路决策;本文不提供跨模型单价对照,因所引资料未覆盖其他型号定价。



评论(0)