 NexAIX-官方博客
很多团队以为发了几个测试请求、抓个包就能证明服务商到底有没有存 prompt,但实际上做不到。判断一个零日志AI API 能不能验证,只能靠“字段级承诺 + 合同约束 + 可观测行为交叉判断”三层手段,任何单纯客户端探测都不成立。尤其最近头部聚合网关被支付基础设施公司收购(2026 年 8 月官方公告),Token 计量正在加速并入支付财务体系,这意味着“计费元数据”与“调用正文”的留存边界需要重新逐条确认,而不是继续听一句“我们不存数据”就放心。
先给结论:零日志能不能验证,取决于你问的是哪类数据
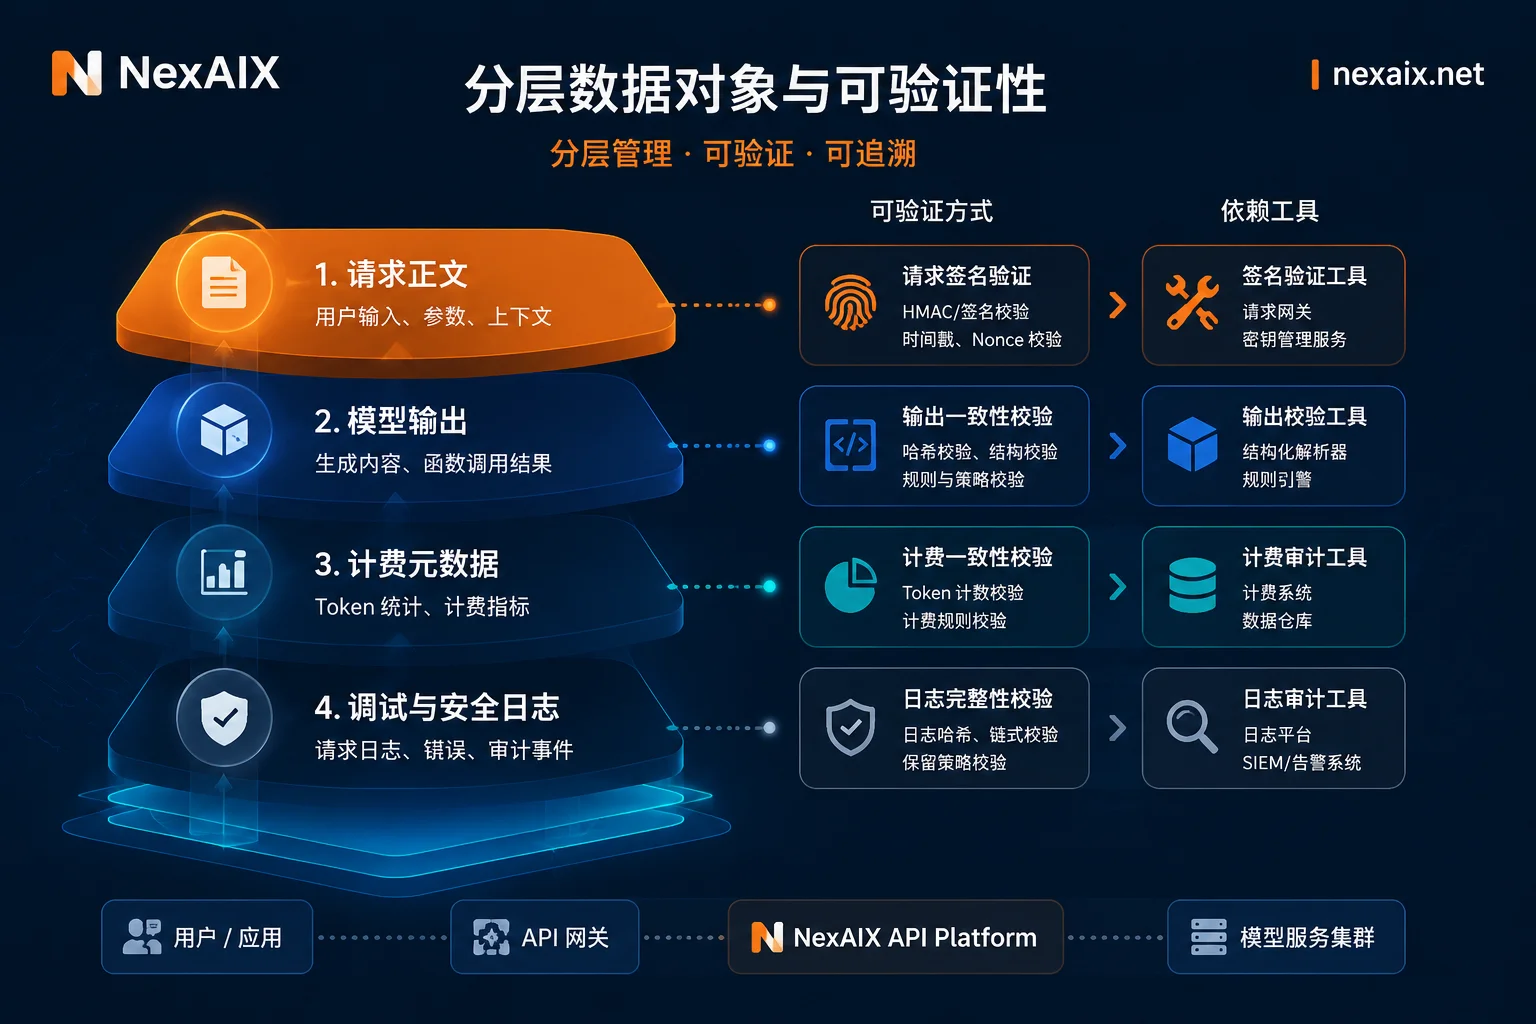
判断一个零日志AI API 能不能验证,取决于你问的是哪类数据。“零日志”不是一个开关,而是一组分级承诺。严格说,服务端是否在推理完成后立即擦除 Prompt 和 Output 正文,客户端无法从外部物理证实;你能验证的是:服务商公开文档里如何界定字段、控制台能否回看历史正文、以及是否提供请求级强制参数。我们可把数据分成四类:请求正文、模型输出、计费元数据、调试与安全日志。每一类的可验证强度完全不同。
四类数据对象拆解:请求正文、模型输出、计费元数据、调试与安全日志
为了让“零日志”可落地,主流网关普遍采用分层治理,典型是 OpenRouter 官方隐私文档(官方文档,2026-06)的做法:默认不存 Prompt 和 Completion 内容,仅记录 token 数、延迟、模型名、时间戳等用于计费与排障的元数据;正文留存需要用户主动 opt-in,并且 API 支持传入 zdr: true 来强制零留存并过滤掉下游保留数据的供应商。据此,四类数据的留存动机与风险等级如下:
| 数据类别 | 典型留存动机 | 合规风险等级 | 可验证性 |
|---|---|---|---|
| 请求正文(Prompt) | 排障、模型调优、滥用分析 | 极高 | 低(只能靠条款与文档) |
| 模型输出(Completion) | 同上,另可能用于质量评估 | 极高 | 低 |
| 计费元数据 | 账单核对、用量统计 | 中 | 高(文档与控制台可核) |
| 调试与安全日志 | 故障排查、安全审计、风控 | 中高 | 中(需索取访问范围) |
“我们不存储数据”这类整体表述没有意义,你必须逐类问清“具体保留哪些字段”。
哪些能自己验证,哪些只能靠条款:三个可做的动作与一条硬边界
评估零日志AI API时,签约前可以做三个动作交叉验证:
- 【可自行验证】 核对返回体
model字段:确认实际执行的模型与请求时指定的一致,防止被静默降级替换,这也是字段级承诺的一部分。 - 【可自行验证】 检查控制台能否回看历史请求正文:如果能回看,说明服务端确实做了持久化;如果控制台只显示 token 数、延迟、状态码,则与“不存正文”的说法更一致。
- 【可观测但非证明】 检查是否提供请求级留存开关:例如部分网关提供的请求级零留存参数(如
zdr: true),它在请求级强制零留存,并过滤掉不承诺的供应商。如果服务商没有这类参数,至少说明其对“零日志”没有产品化设计。
【完全无法外部验证】传输层解密后,服务端“内存丢弃”与“持久化存储”在客户端看来完全相同,任何“发几个请求就能证明没存”的说法都不成立。
计费元数据的合理边界:请求ID、模型名、token数、时间戳、状态码之外还要不要更多
计费元数据是零日志服务中必然留存的部分,但留存集合要有合理上限。以下字段通常被认为是“最小必要”集合:
- 请求 ID(用于账单与排障关联)
- 模型名(区分调用档位)
- token 数(输入/输出)
- 时间戳
- 状态码(成功/失败)
超出这个集合的字段就要多问一句,例如:prompt 摘要、命中缓存的内容片段、用户标识与原文的关联索引。真正合规的做法是把字段清单写进合同附件。
可直接复制给服务商的提问模板:“请以字段名形式列出贵方对每次 API 调用实际持久化的全部字段;如包含 prompt 摘要、缓存内容片段或用户标识与原文的关联索引,请说明用途、保留时长与删除触发条件。”
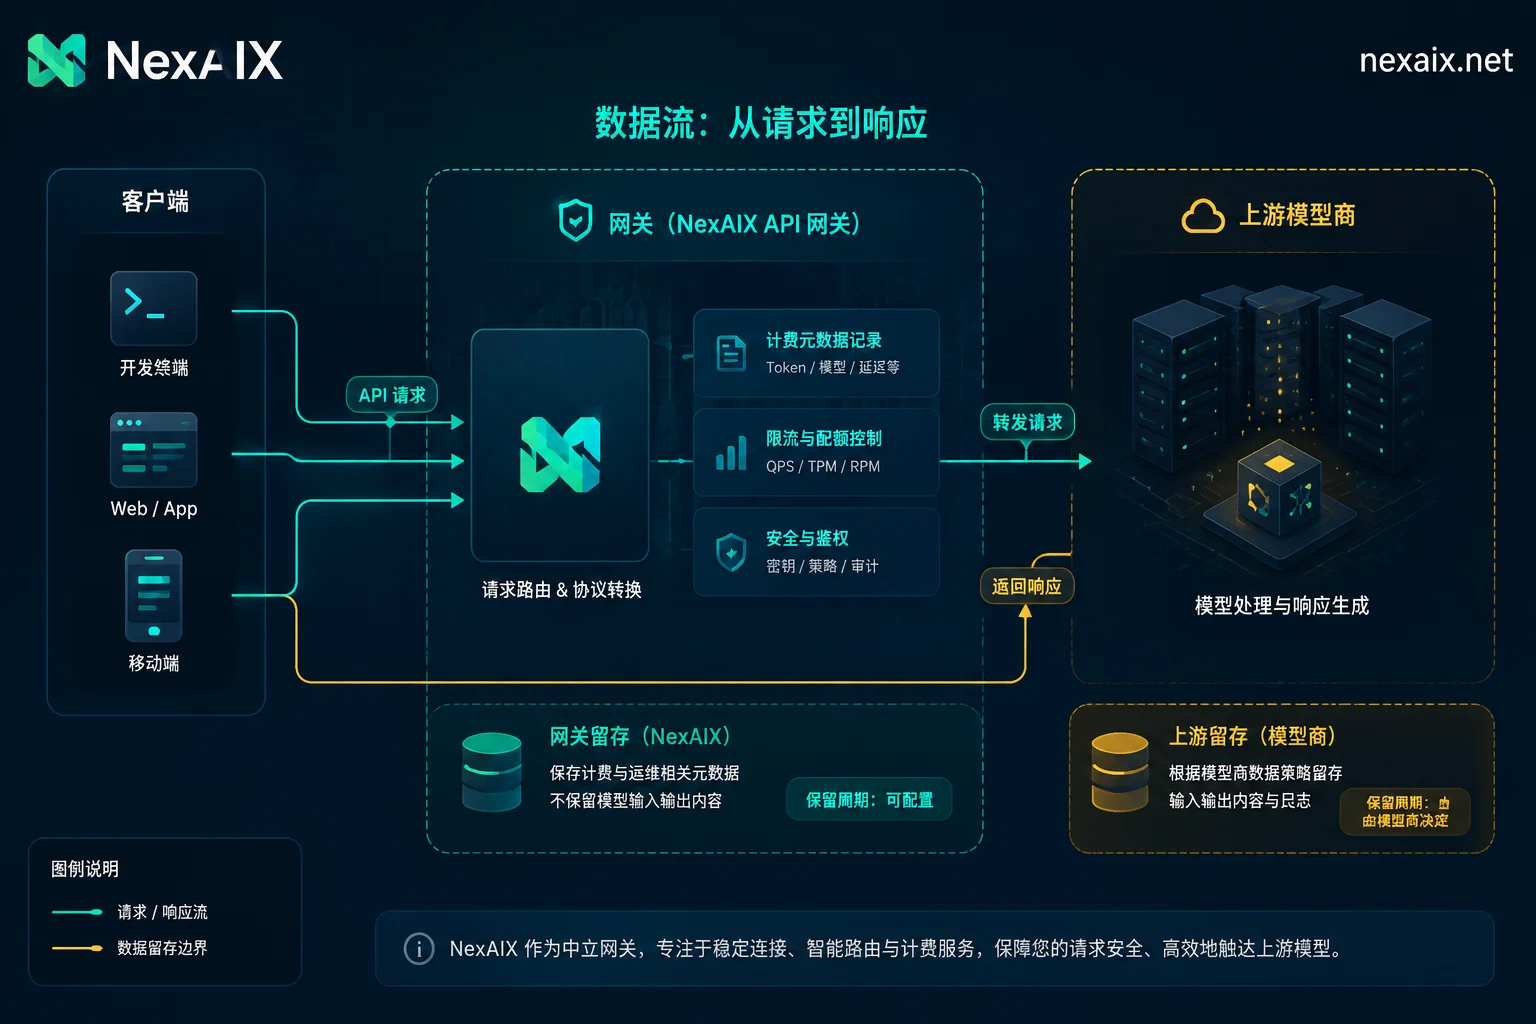
多一跳意味着两笔账:上游模型商留存与网关留存要分开确认
中转链路中,网关方有自己的留存策略,上游模型商也有自己的一套,它们是两套独立承诺,必须分别取得书面口径。同时注意“有状态功能”与“无状态 API”的分区:OpenAI 在 2026 年 8 月 19 日发布的 Zero Data Retention 升级说明(官方公告)中明确,无状态推理 API 在请求完成后会即时擦除正文,但 Vector Store、Threads 等有状态功能不在保证范围内。所以,不能只看服务商整体说“零日志”,而是要按功能模块分别判断。
计费与财务体系耦合后,值得重新确认的三处条款
头部聚合网关被支付基础设施公司收购(官方公告,2026-08-19)后,Token 路由与财务结算深度结合,官方虽声明保持独立运营与中立路由,但企业客户仍有理由重新确认三处条款:
- 账单侧元数据是否与调用正文建立关联索引:例如账单明细里是否包含 prompt 摘要或正文片段,原网关文档默认不存正文,但并入支付体系后新增财务字段的可能性需要书面确认。
- 留存策略变更的通知与生效机制:比如改变元数据保留时长,是否会提前 30 天邮件通知?不写清楚,等于没承诺。
- 控制权变更条款下的数据处理承诺是否延续:收购后原有的数据保护承诺是否继续有效,还是需要重新签 DPA。
在如今的并购潮下,把“零日志”承诺写进 DPA/SLA 比任何时候都重要。
签约前索取的书面承诺清单与试用期核对顺序
与其听零日志AI API服务商的口头保证,不如把下面这张清单直接发给候选服务商,逐条要书面回复:
- 字段级留存列举:列明请求正文、模型输出、元数据、日志各自保留哪些字段
- 保留时长与删除机制:尤其是元数据和日志的天数、删除触发条件
- 子处理方名单:哪些上游模型商、云厂商会接触数据
- 留存策略变更通知期:多少天、什么渠道
- 事故日志的访问权限范围:谁能看、能不能导出、有没有审计日志
一个可比的对照样本是 NexAIX 的公开零日志口径:它明确不记录 prompt 与 completion,仅保留请求 ID、模型名、token 数、时间戳与状态码等计费排障元数据,并使用返回体 model 字段确保实际执行模型一致,满载时返回标准 429 而非静默降级。这类可逐条比对的表述,比“我们不存储数据”更便于落进合同。当然,具体条款以官网当前文档为准。
把上面的字段清单直接贴进采购问卷,向每家候选服务商索取逐条书面回复;需要一份可对照的写法样本时,可查阅 NexAIX 官网当前的数据处理条款与 API 文档,以官网现行版本为准。
试用期核对顺序建议:先读隐私条款 → 比对官方文档 → 在控制台观察可回看字段 → 用小流量压测记录状态码与 model 字段是否正常。关于 AI中转站怎么选,可以参考其数据留存透明度;若发现返回体与请求的模型不一致,还要留意 AI中转站掺水 的常见手段。
常见问题
AI API 会不会保存我的 prompt?
看具体服务商。OpenRouter 官方隐私文档(2026 年 6 月)声明默认不存 Prompt 与 Completion,其他服务商不一定相同。判定依据是对方能否书面列出“正文是否留存、留存多久、谁可访问”三项;给不出字段级书面回复的,按“会留存”处理。
大模型API 数据留存多久?
没有统一答案,也没有行业通用天数可引用。资料包内可确认的只有两点:OpenRouter 默认不存正文、仅留元数据(官方文档,2026-06);OpenAI 前沿模型 ZDR 在无状态请求完成后即时擦除正文,但 Vector Store、Threads 等有状态功能不在保证内(官方公告,2026-08-19)。元数据的具体保留天数必须逐家索取书面口径,不作推测。
调用 AI API 有哪些元数据被记录?
常见有请求 ID、模型名、token 数、时间戳、状态码。如果服务商记录额外字段(如用户 IP 对应的精确位置),要追问原因和留存时长。
中转站零日志是真的吗?
部分真。关键看它是否区分“正文”和“元数据”承诺,以及有没有请求级强制参数(如 zdr: true)。只有口头声明但给不出字段清单的,要怀疑。
企业接入大模型API 合规要问什么?
至少问五件事:正文是否留存、元数据字段清单、留存期限与删除机制、子处理方名单、策略变更通知期。全部落到书面回复,纳入 DPA。更多可参考 AI API选型 清单。



评论(0)