 NexAIX-官方博客
Claude API 返回 400 invalid_request_error 时,重试无效——400 是请求侧被服务端硬拒,必须直接改请求体。近年来从 GPT 生态迁移的调用方,同一套 SDK 代码却开始收到 400,通常就坠入这四类坑:采样参数被硬拒、thinking 块与签名被篡改、兼容层默认值缺口、工具调用回传结构不合规。本文给出 Claude API 400 的四类成因判定与处理动作,并给出适配层参数白名单与回归测试建议。
先给结论:Claude API 的 400 只有四个来源
Claude API 返回的 400 invalid_request_error 属于请求体本身被服务端拒绝,常见诱因可归为四类:采样参数被硬拒(如传递废弃的 temperature)、thinking 块与签名被篡改、兼容层默认值缺口(如 max_tokens 缺省)、工具调用回传结构不合规。每一类都有明确的“必须删、必须原样透传、必须补齐”的判定规则。近年 Claude 模型强化了参数强校验与思考块签名防篡改机制,从 OpenAI 生态迁移的调用方最容易踩中这四类坑。
第一类:采样参数被服务端硬拒,temperature 到底还能不能传
新一代 Claude 模型(如 Claude 5 系列)对采样参数实施硬性校验,按 Anthropic Messages API 参考:传递已废弃或非默认的 temperature、top_p,或同时指定二者,会直接返回 400 invalid_request_error。换句话说,在 OpenAI 链路里全局配置 temperature=0.7 的习惯不能照搬——对不支持该参数的模型,这个字段会被直接拒绝。
处理动作:删除,不是改数值。 如果模型不支持该参数,从请求体中移除即可;不要尝试替换成 0.8 或 0.1,那只会继续触发同样错误。如果你在多模型链路里复用一套请求构造代码,需要按模型能力维护参数白名单。
| 参数 | 典型触发场景 | 处理动作 | 归属层 |
|---|---|---|---|
| temperature | 传递非默认值或与 top_p 并用 | 删除该字段 | 客户端/网关清洗 |
| top_p | 传递非默认值或与 temperature 并用 | 删除该字段 | 客户端/网关清洗 |
| max_tokens | 缺省(Anthropic 强制要求) | 显式补齐 | 客户端/网关补齐 |
| thinking/signature | 历史回传被篡改或剔除 | 原样透传 | 客户端/网关透传 |
第二类:thinking 块与 signature 被改动,多轮历史直接被拦
在涉及思考过程的多轮对话中,Claude API 强制校验 thinking 块及其 signature 签名的完整性与顺序。历史 assistant 消息中的 thinking 块必须原样无修改回传,任何对 signature 的篡改、剔除或重排都会返回 400。如果你的报错来自 extended thinking 参数,处理方式不是改参数值,而是保证 thinking 块整块原样回传。
判定: 思考相关内容一律不删、不改写,历史结构整块保留并原样回传;需要省 token 只能整轮丢弃旧对话,不能在保留的轮次里剥离 thinking 或 signature。
常见破坏点在中转层或自研上下文压缩逻辑——为了省 token 过滤掉思考块,结果触发了签名校验。如果需要节省上下文,可以在发送前截断旧历史,但已包含的 thinking 块和 signature 要保持原样。更多关于多轮对话思考历史的传法,可参考OpenAI SDK兼容多轮对话怎么传思考历史。
第三类:OpenAI SDK 调用 Claude 报 400 是什么原因——max_tokens 与注入参数
OpenAI SDK 调用 Claude 报 400,最常见根因是参数默认值与协议映射断层,参照 OpenRouter 参数转换说明:Anthropic Messages API 强制要求显式传入 max_tokens(而 OpenAI 规范中该参数可选),同时 OpenAI SDK 默认附带的采样参数(如 temperature=0.7)被直接转发,就会触发合规硬拒。
兼容层改造动作: 在适配层补上 max_tokens 必填值,并对请求体中的采样参数做清洗。注意,有些 SDK 会在应用层注入默认参数,你需要确认这些参数是否真正发送到了服务端。用同一段请求打官方端点和中转端点做对照,能快速暴露哪些字段是 SDK 注入的。
第四类:工具调用回传结构不合规的 400 长什么样
在 Tool Use 流程中,Claude API 要求 tool_use 块之后必须紧跟纯净的 tool_result 用户消息,如果缺少对应的 tool_result、tool_use_id 不匹配,或在同一轮中插入未对齐的文本,服务端会立即返回 400。
Agent 循环中最容易出错的三个地方:
- 工具结果没有回传给 API,而是直接拼接在下一轮用户消息里。
tool_use_id复制错误或丢失。- 在
tool_use与tool_result之间插入了额外文本(如状态提示)。
确保工具调用链中每一条 tool_use 都有对应的 tool_result,且结构纯净。关于工具调用完整循环的构建,可以查看工具调用API的实践说明。
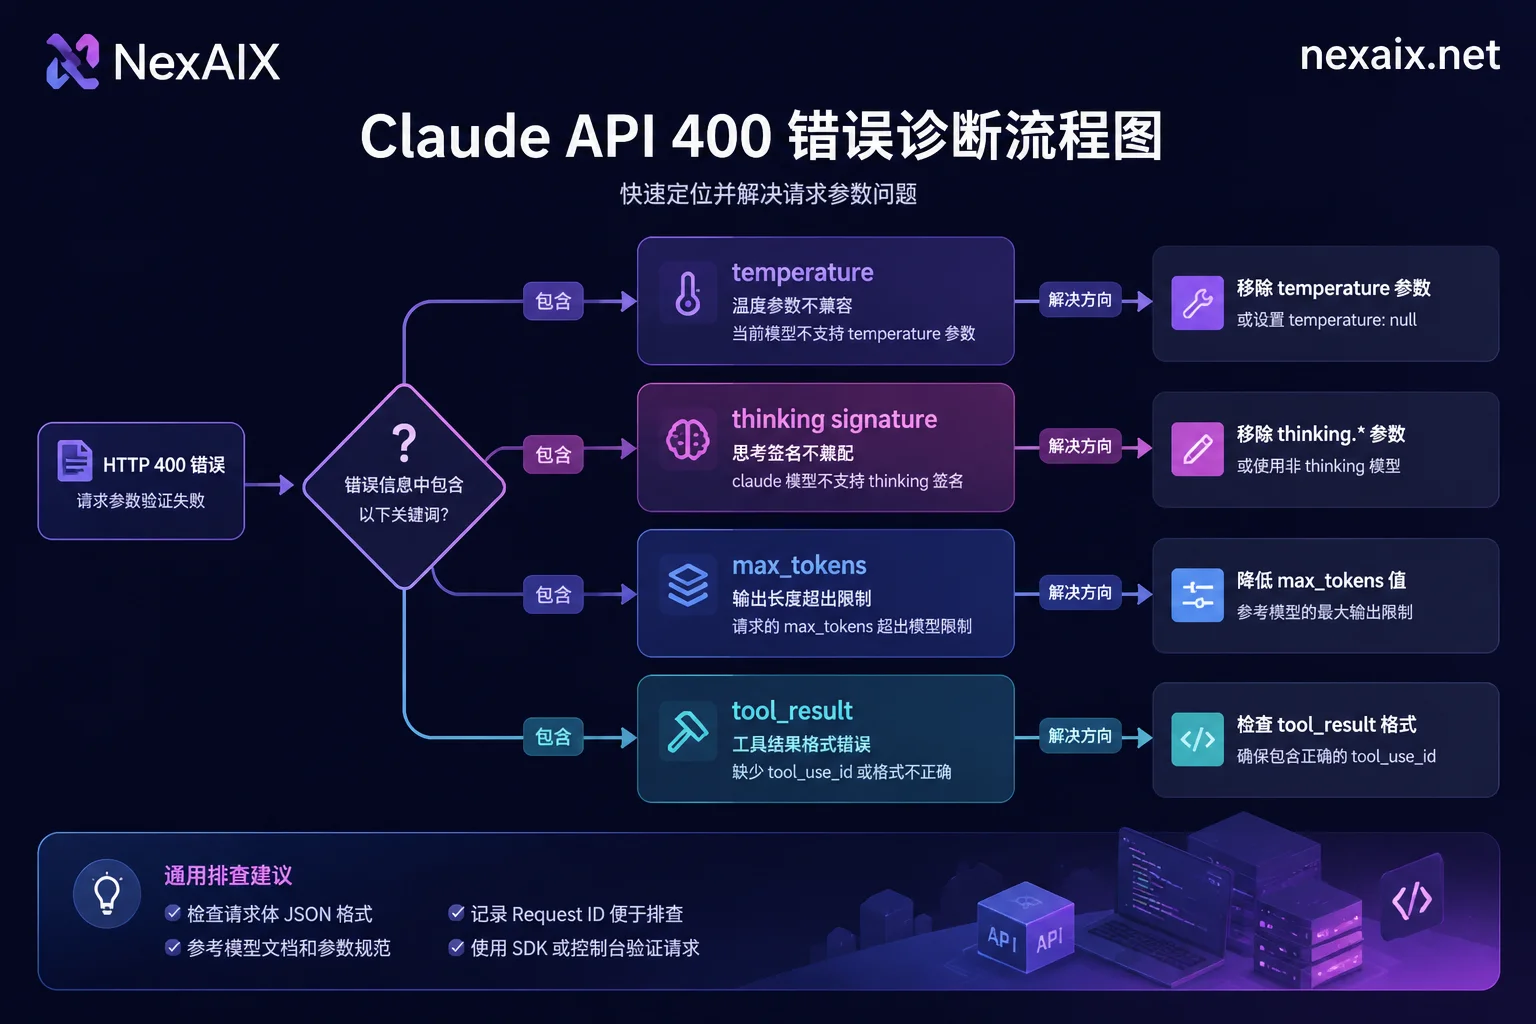
图 1:四类 400 成因判定流程——先看被拒字段,再用最小请求体复现。
三步现场判定:怎么当场把四类 400 分开
收到 400 时,按以下步骤快速定位:
- 读响应体:查看 error 信息,判断被拒字段是
temperature、signature还是tool_result,但不要依赖具体的错误字符串(官方可能随时调整)。 - 最小请求体复现:只保留
model+messages+max_tokens,如果不再报 400,说明问题出在某可选字段或结构上。 - 二分加回参数:逐个加回采样参数、历史 thinking 块、工具调用结果,每一步都测试,直到复现 400,即可锁定变量。
注意:400 与 429、超时属于不同故障族。400 是请求体问题,重试无效;429 是限流,稍后重试可能成功。
适配层怎么写:按模型维护参数白名单而不是散落 if-else
多模型共用一套请求参数时的兼容做法是:按模型能力维护白名单,而不是散落 if-else。把四类成因收敛成工程做法:在网关/适配层按模型能力维护允许参数白名单,转发前清洗不兼容的采样字段、补齐必填字段(如 max_tokens),同时完整透传带签名的 thinking 块与工具调用结构。中转层对参数只有三种处理——原样透传、静默丢弃、擅自改写,后两种会把确定性的 400 变成难复现的行为异常。判断中转端点是否原样透传参数,可参考AI中转站怎么选的对照方法。
客户端删 vs 网关清洗的分工: 如果客户端直接面对多种模型,可以按模型分支删字段;如果走统一网关,就让网关按白名单清洗,客户端保持通用。无论哪种,都不要静默丢弃或改写 thinking 块和 tool_use 结构。
# 伪代码:按模型能力清洗请求体
def clean_request(model, request_body):
    whitelist = get_whitelist(model)  # 从模型能力表读取
    # 1. 剔除白名单外的采样字段
    for key in ['temperature', 'top_p']:
        if key not in whitelist and key in request_body:
            del request_body[key]
    # 2. 缺省时补齐 max_tokens
    if 'max_tokens' not in request_body:
        request_body['max_tokens'] = 4096  # 示例值
    # 3. thinking 块与 tool_use/tool_result 原样透传,不做任何改写
    return request_body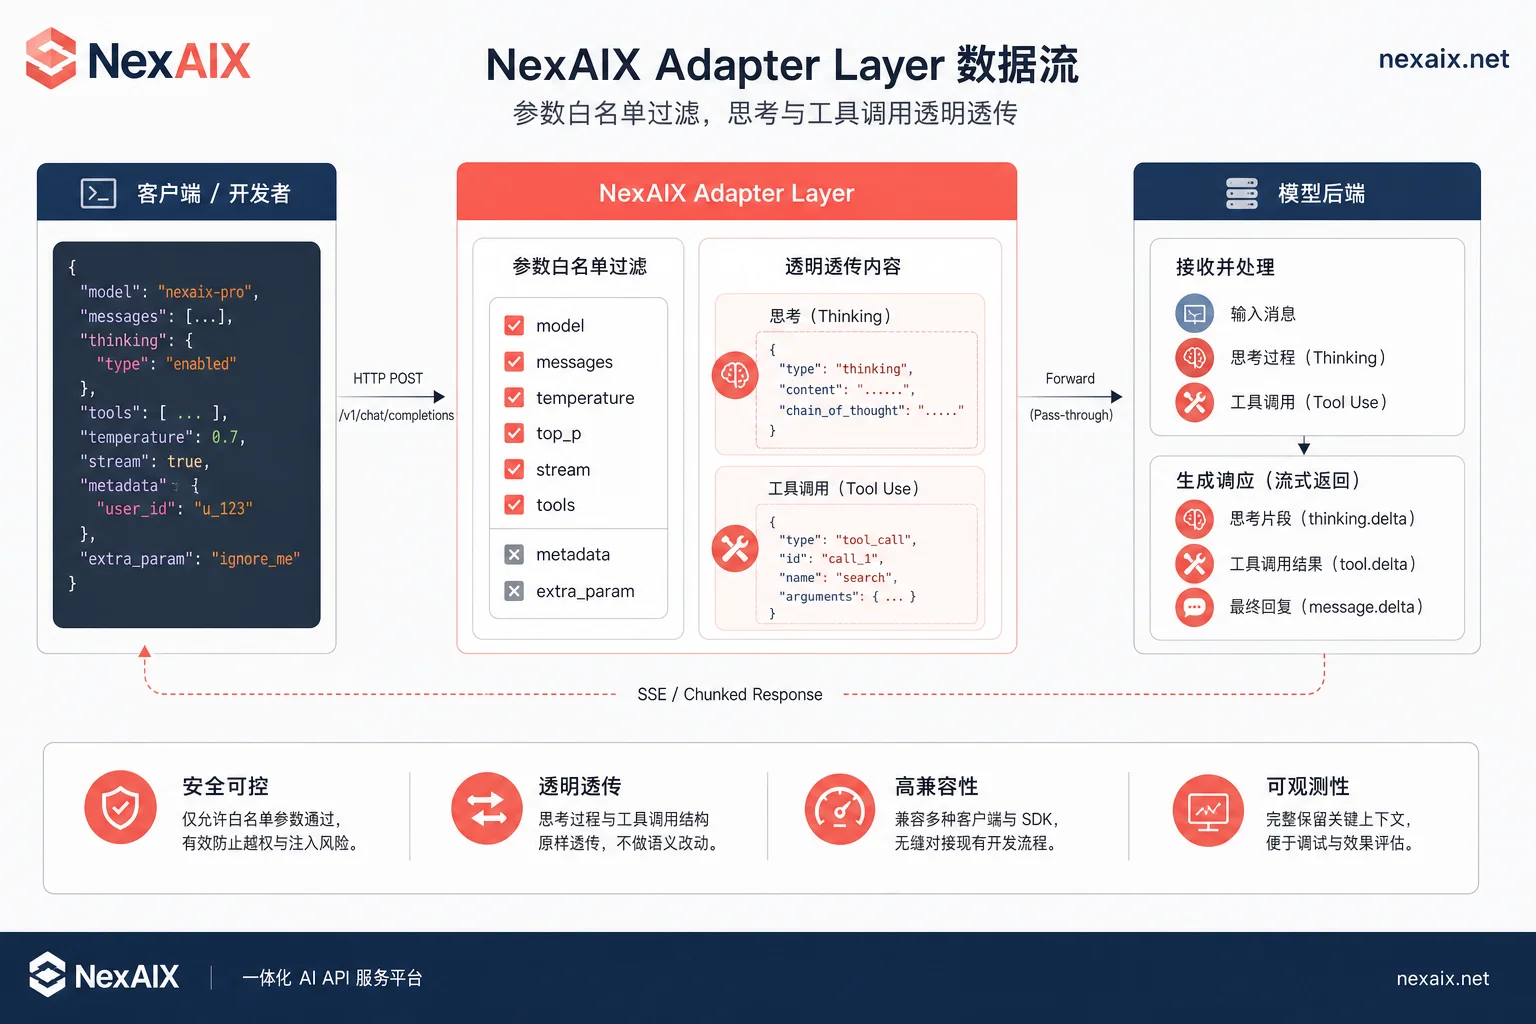
图 2:适配层白名单清洗与签名/工具结构原样透传的数据流。
改完必测四项与换端点前的回归清单
建议把以下四项固化成 CI 里的一组最小请求用例,在换模型或换端点前跑一遍:
- 非流式请求:确保基础参数清洗和补齐生效。
- 流式请求:验证流式模式下思考块和工具调用的透传是否正常。
- 工具调用完整循环:从
tool_use到tool_result全链路跑通。 - 多轮历史(含思考块)回传:带 signature 的历史消息整块透传后,后续对话是否正常。
换模型或换端点前,用同一段请求分别打到官方端点和中转端点做参数透传对照。以 NexAIX 的 OpenAI 兼容接口(base_url https://api.nexaix.net/v1)用测试额度先跑一次参数透传验证,模型满载时返回标准 429 而非静默换模型,返回体 model 字段对应实际执行模型,这样便于把 400 与降级问题分开归因。相关限流识别可参考AI API 429的处理方法。
本文结论基于 Anthropic 官方 Messages API 参考与错误码文档,以及 OpenRouter 的错误处理与参数转换文档;具体模型的参数支持情况以官方文档当前版本为准。
常见问题
temperature 是不是彻底不能设?
对新一代 Claude 模型,temperature 和 top_p 通常不能设置,传了就报 400。需要控制随机性时,检查该模型是否支持 thinking 参数或其它采样方式,以官方文档为准。
400 要不要重试?
不要。400 是请求体被服务端硬拒,重试不会成功。应该立即改请求体,而不是退避重试。
思考历史能不能裁剪省 token?
可以裁剪旧轮次,但已发送的 thinking 块和 signature 必须整块保留。建议在 API 层之前压缩,而不是删除 thinking 块。
网关层该不该帮我过滤不支持的参数?
理想情况下应该,但前提是网关按模型能力维护白名单,且完整透传签名和工具结构。如果网关静默丢弃,可能导致 400 变成更难排查的异常,建议先对照测试。像 NexAIX 这类中转端点,满载时返回标准 429 而非静默换模型,可用于把 400 与降级问题分开归因。
OpenAI SDK 调用 Claude 要改哪几处?
至少补上 max_tokens(必填)、移除可能注入的 temperature/top_p,并确保 tool_use 后的消息结构纯净,thinking 块原样回传。



评论(0)