只是一个默认分类

AI API Key 怎么拿、怎么存、怎么分:从本地开发到生产的接入与隔离

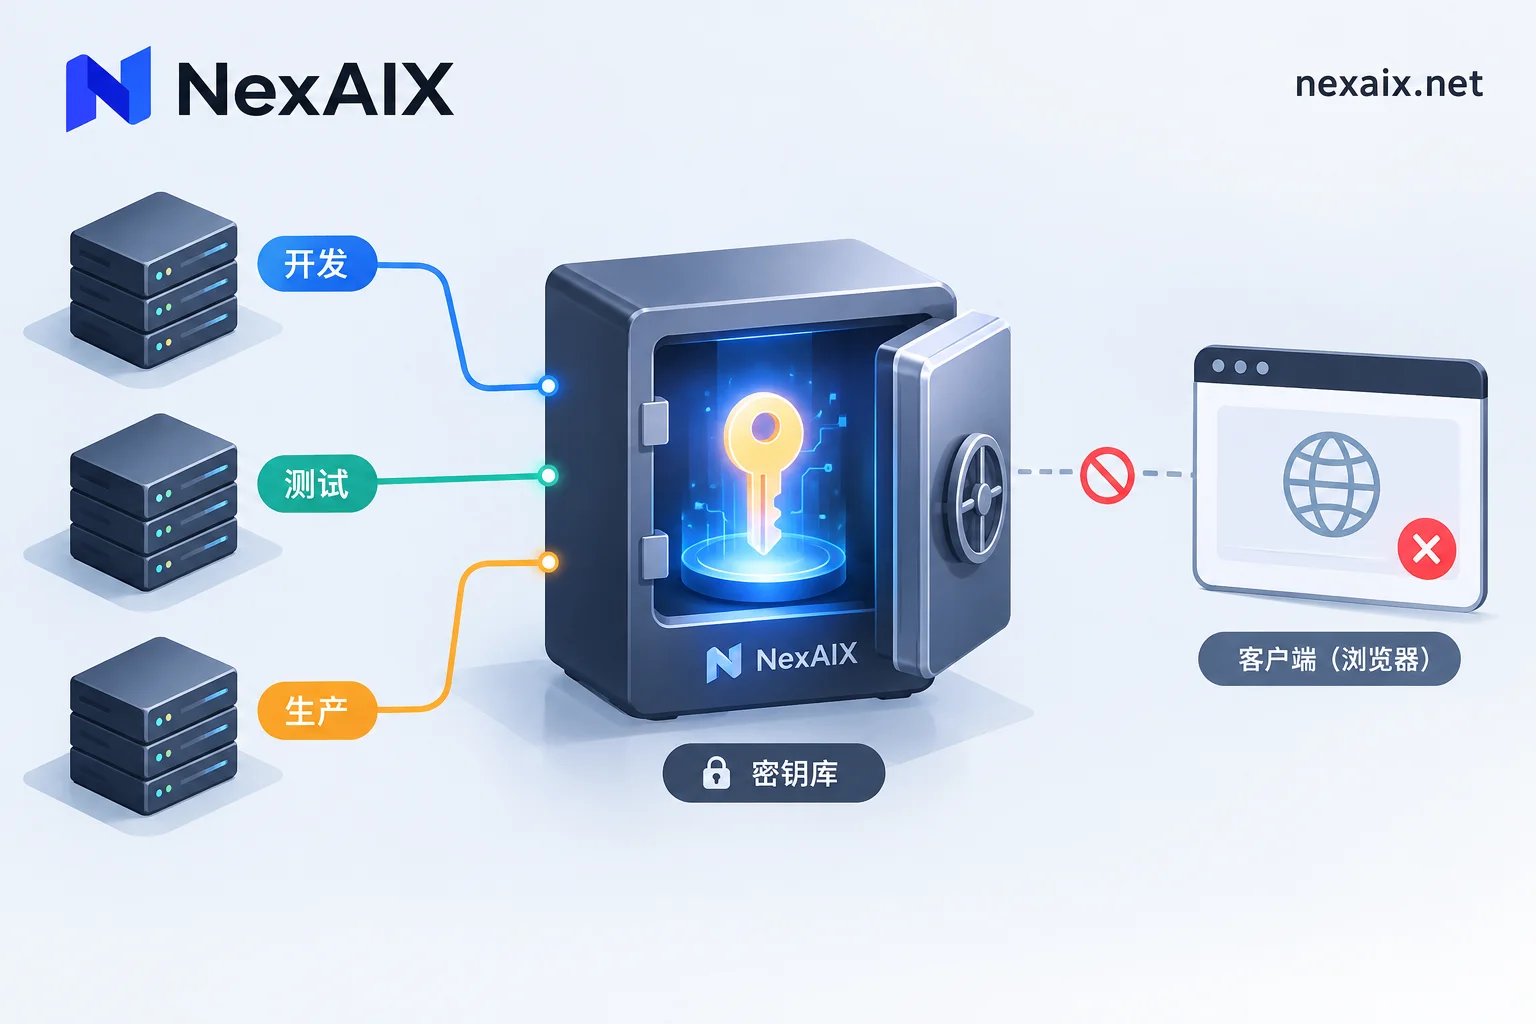
拿到 AI API Key 后,第一步是决定它放在哪里,然后再写调用代码。本文说明如何用环境变量和密钥管理系统注入 Key,如何用 OpenAI 兼容格式只改 base_url 完成接入,怎样按环境和业务拆分 Key,以及 Key 泄露后的处置顺序。

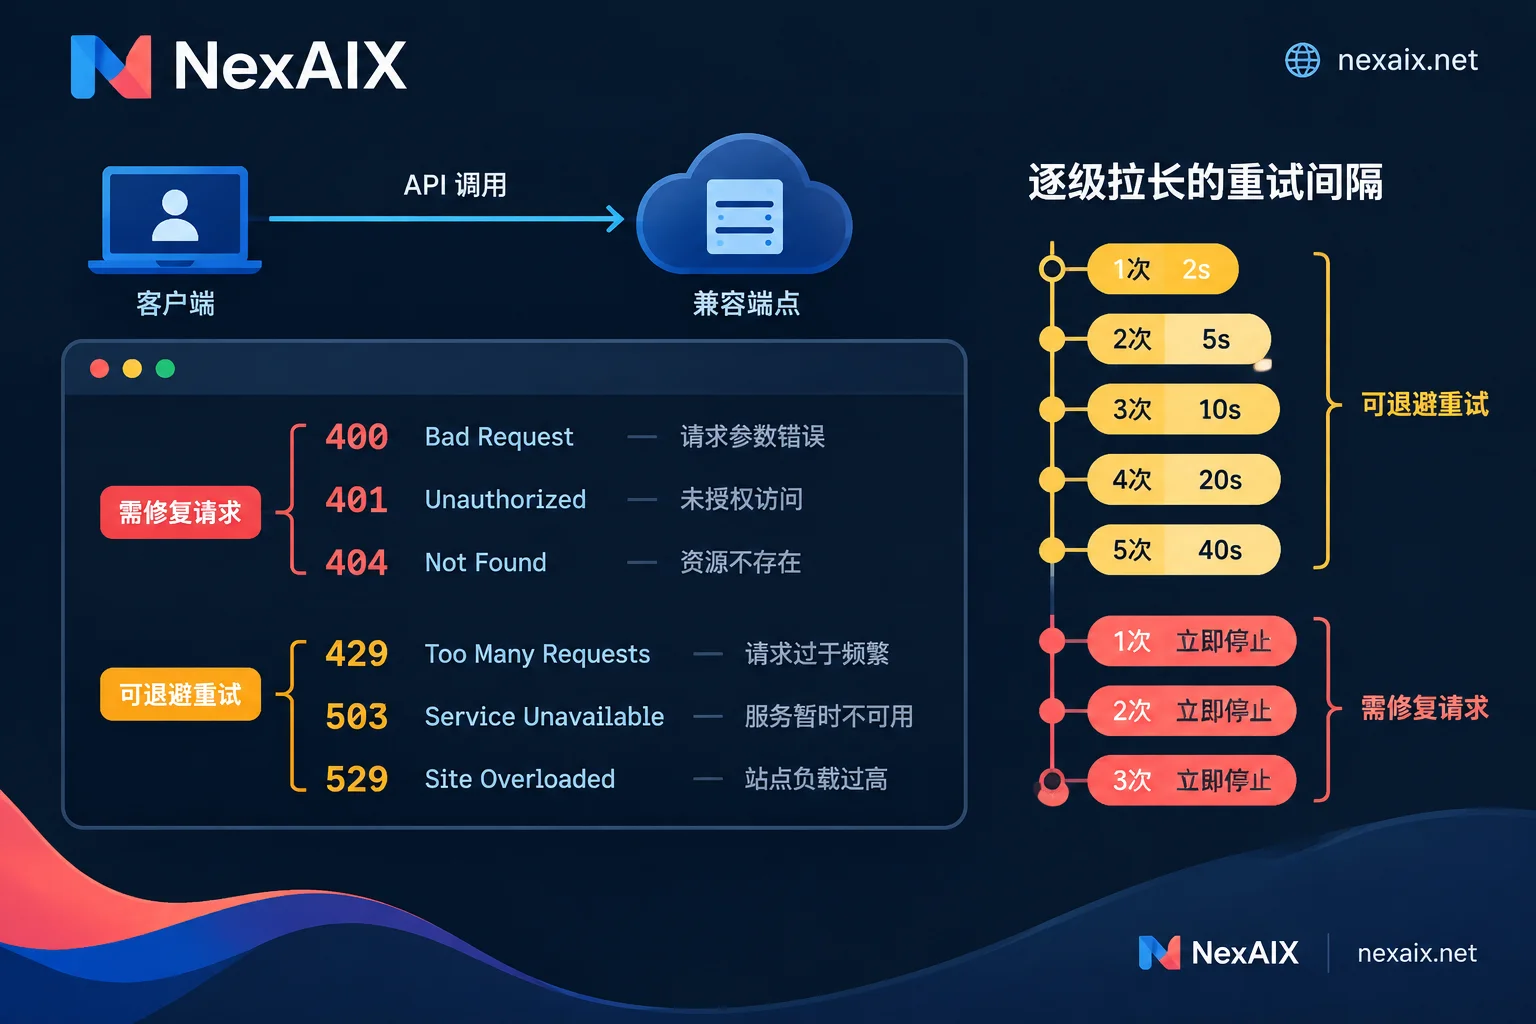
AI API 错误码怎么看:400、401、404、429、5xx 与 529 的原因、重试与降级

按“改了请求才会好”和“等一会儿可能就好”两类,讲清大模型 API 常见错误码的原因和排查顺序。重点区分 429 的速率限制与额度耗尽,并给出退避重试、断路器和降级的写法,避免空转重试和重试风暴。

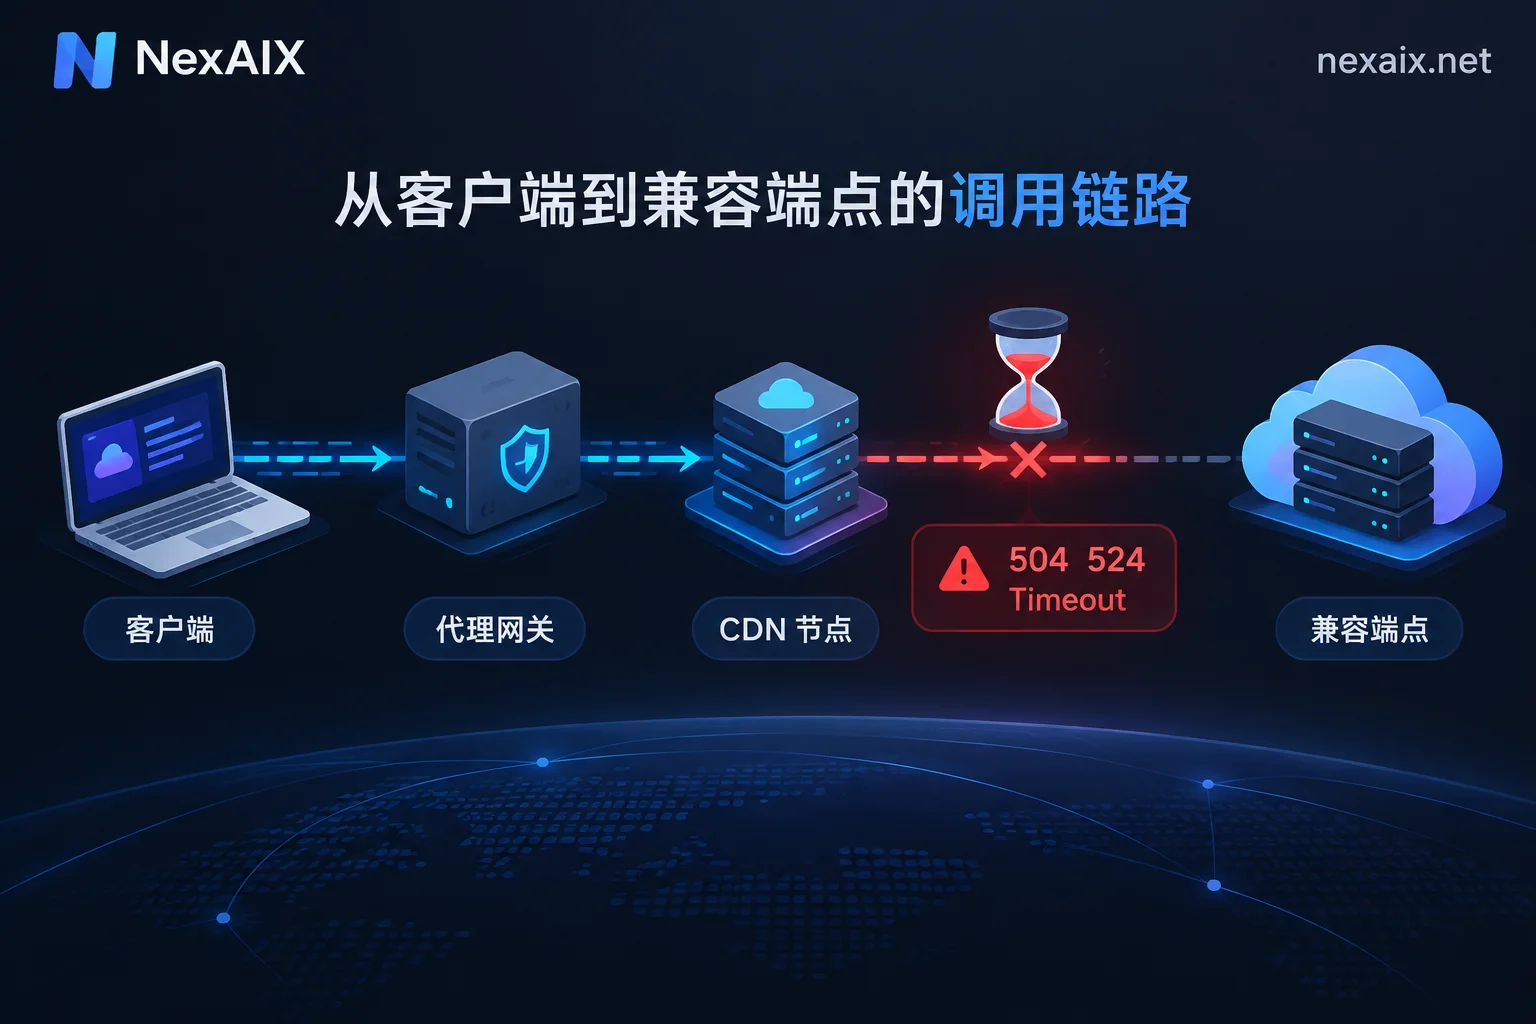
AI API 超时怎么解决:从 504、524 到 APITimeoutError,按链路逐段排查

大模型请求超时,大多是长上下文和长输出的耗时超过了客户端、Nginx 或 Cloudflare 的默认等待时间。本文按“判断断点、开启流式、分段设置超时、调整代理、控制重试和输出长度”的顺序,给出 Python SDK 与 Nginx 的配置示例,并说明各项设置的适用条件。

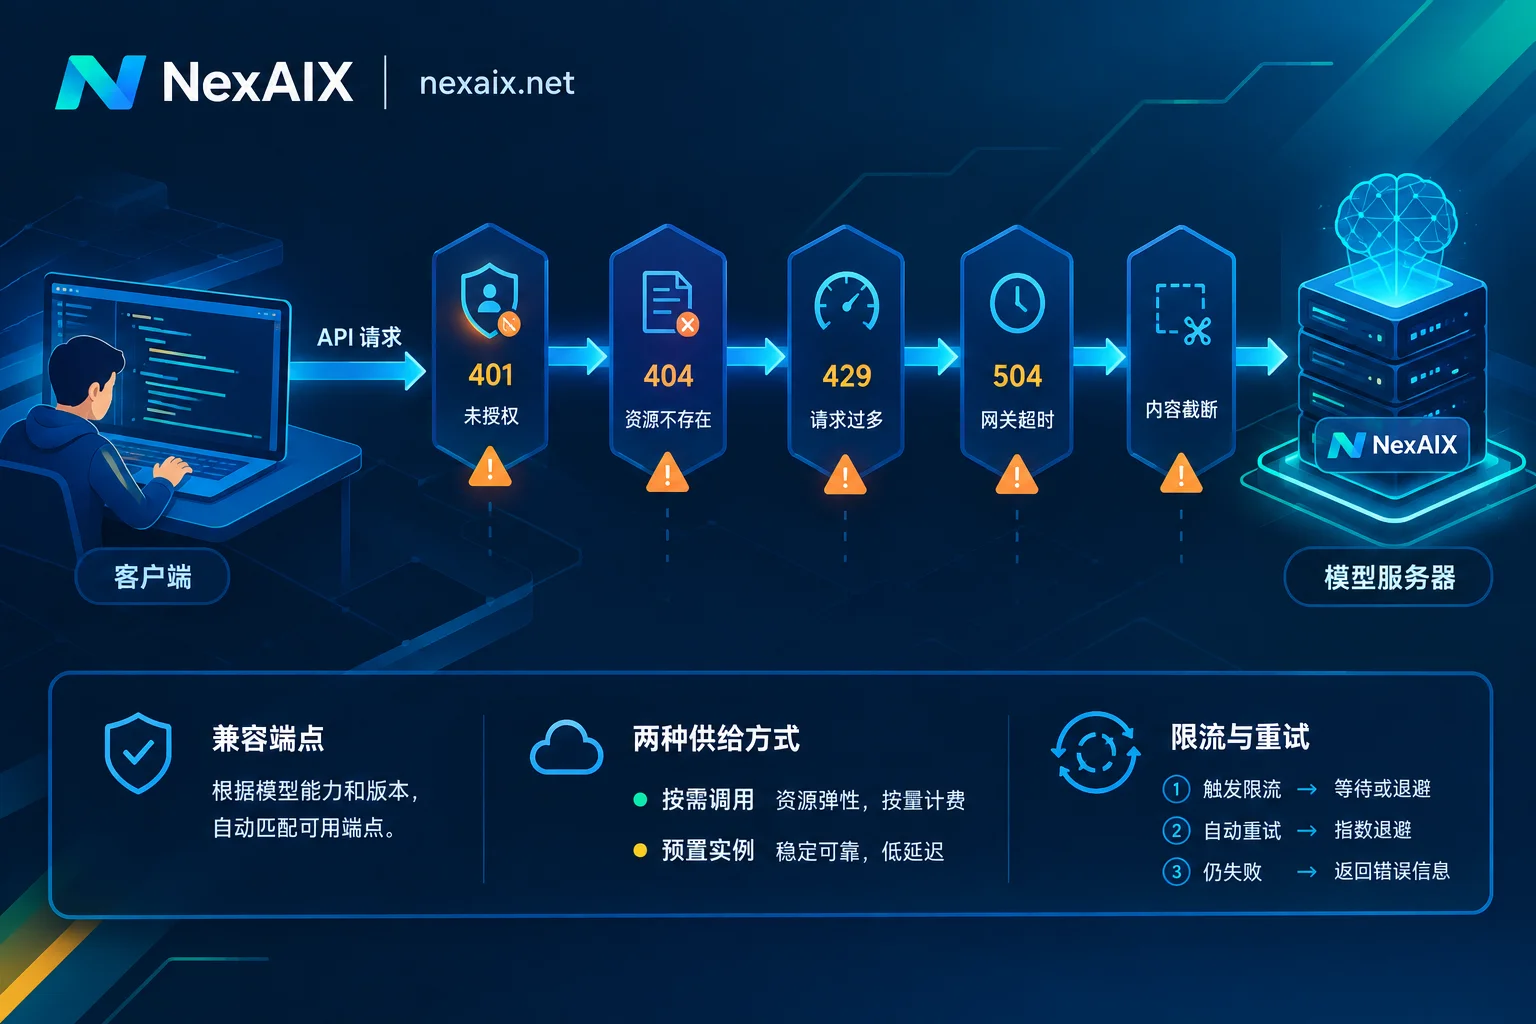
AI API 故障排查:从 401、404、429 到超时、截断和降配怀疑,按顺序定位

调用大模型 API 出错时,先看状态码和响应体里的错误类型,再用最小请求判断问题在客户端还是服务端。本文按认证、路径与模型 ID、限流与配额、5xx 与超时、上下文截断、降配验证的顺序,说明每类问题的判断方法和对应处理。
AI API吞吐量怎么测、怎么提:并发数、RPM/TPM 限流与延迟的取舍

说明如何用每秒输出词元数和每秒完成请求数衡量 AI API 吞吐量,如何通过阶梯压测找到合适的并发数,并按 RPM、TPM 限额估算容量。文章还给出连接复用、Prompt 缓存、控制词元用量和带抖动的 429 退避代码,帮助在吞吐量和首字延迟之间做取舍。