只是一个默认分类

模型上下文窗口对比:窗口与输出上限怎么算,截断、延迟和限流怎么避

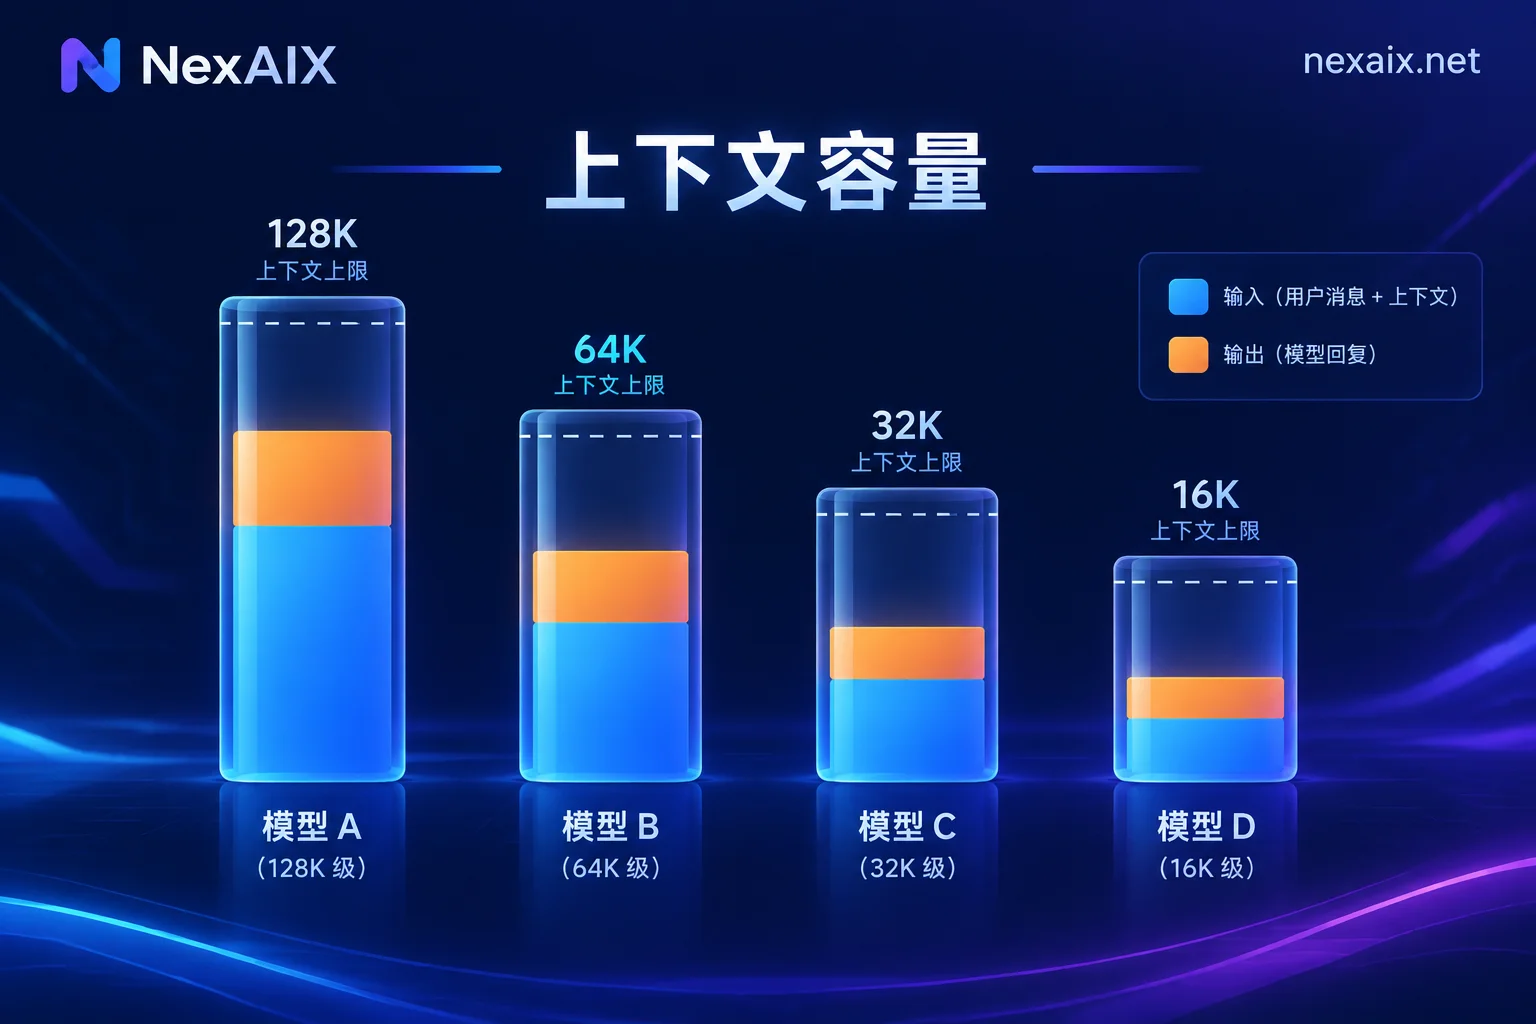
对比 GPT-4o、Claude 3.5 Sonnet、DeepSeek-V3、Gemini 1.5 等代表版本的上下文窗口与单次输出上限。本文说明如何按「输入 + 预留输出 ≤ 窗口」计算 token 预算,并按任务选择窗口档位。遇到输出截断时,可以用 finish_reason 和 usage 定位原因。文中也给出应对长上下文带来的延迟、注意力衰减和 TPM 限流的做法。

DeepSeek 和 Kimi API 对比:上下文、多模态、思维链回传与迁移配置

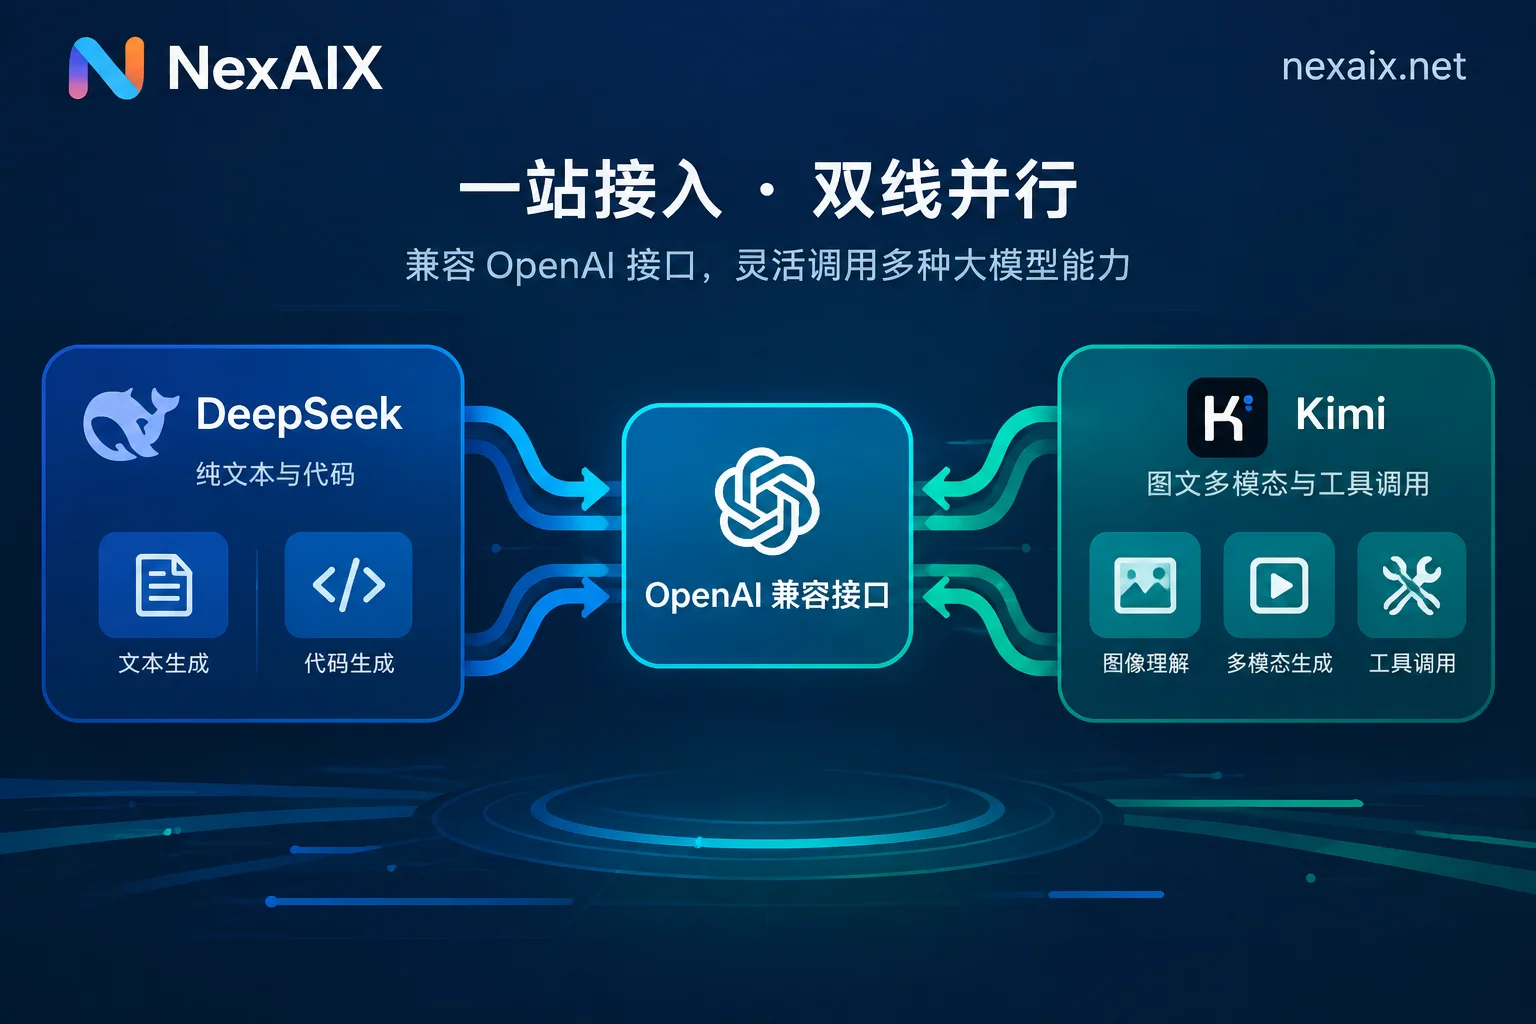
本文对比 DeepSeek 与 Kimi(Moonshot)API 在模型阵容、上下文长度、多模态、思考模式参数和多轮 reasoning_content 回传上的差异。文章先按任务给出选型建议,再说明用同一套 OpenAI 兼容代码切换两家时需要分开处理的地方,以及上线前应该验证的几项内容。

Claude 和 GPT API 对比:协议差异、缓存机制与迁移成本怎么算

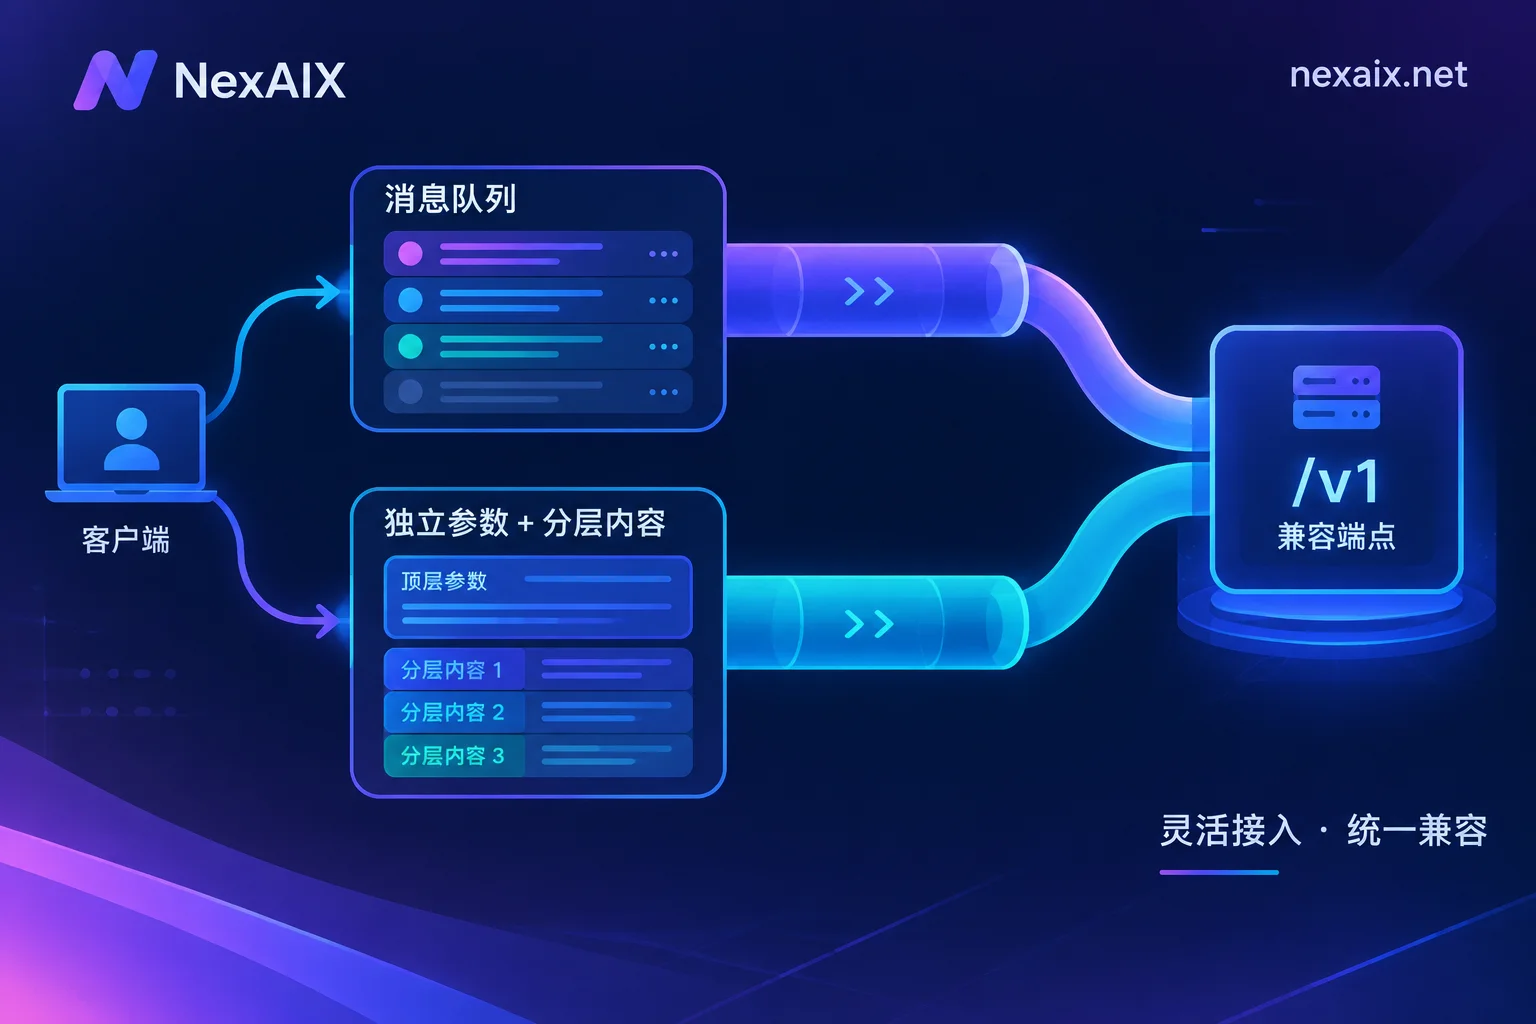
从消息结构、工具调用回传、流式事件和 Prompt Caching 四处实际差异出发,说明 Claude Messages API 与 OpenAI Chat Completions 的工程分野、各自适合的任务类型,以及迁移时选适配层还是统一兼容端点的判断依据,并给出上生产前的验证动作。
gpt-oss-120b API 接入指南:选型判断、reasoning_effort 调档与降配验证

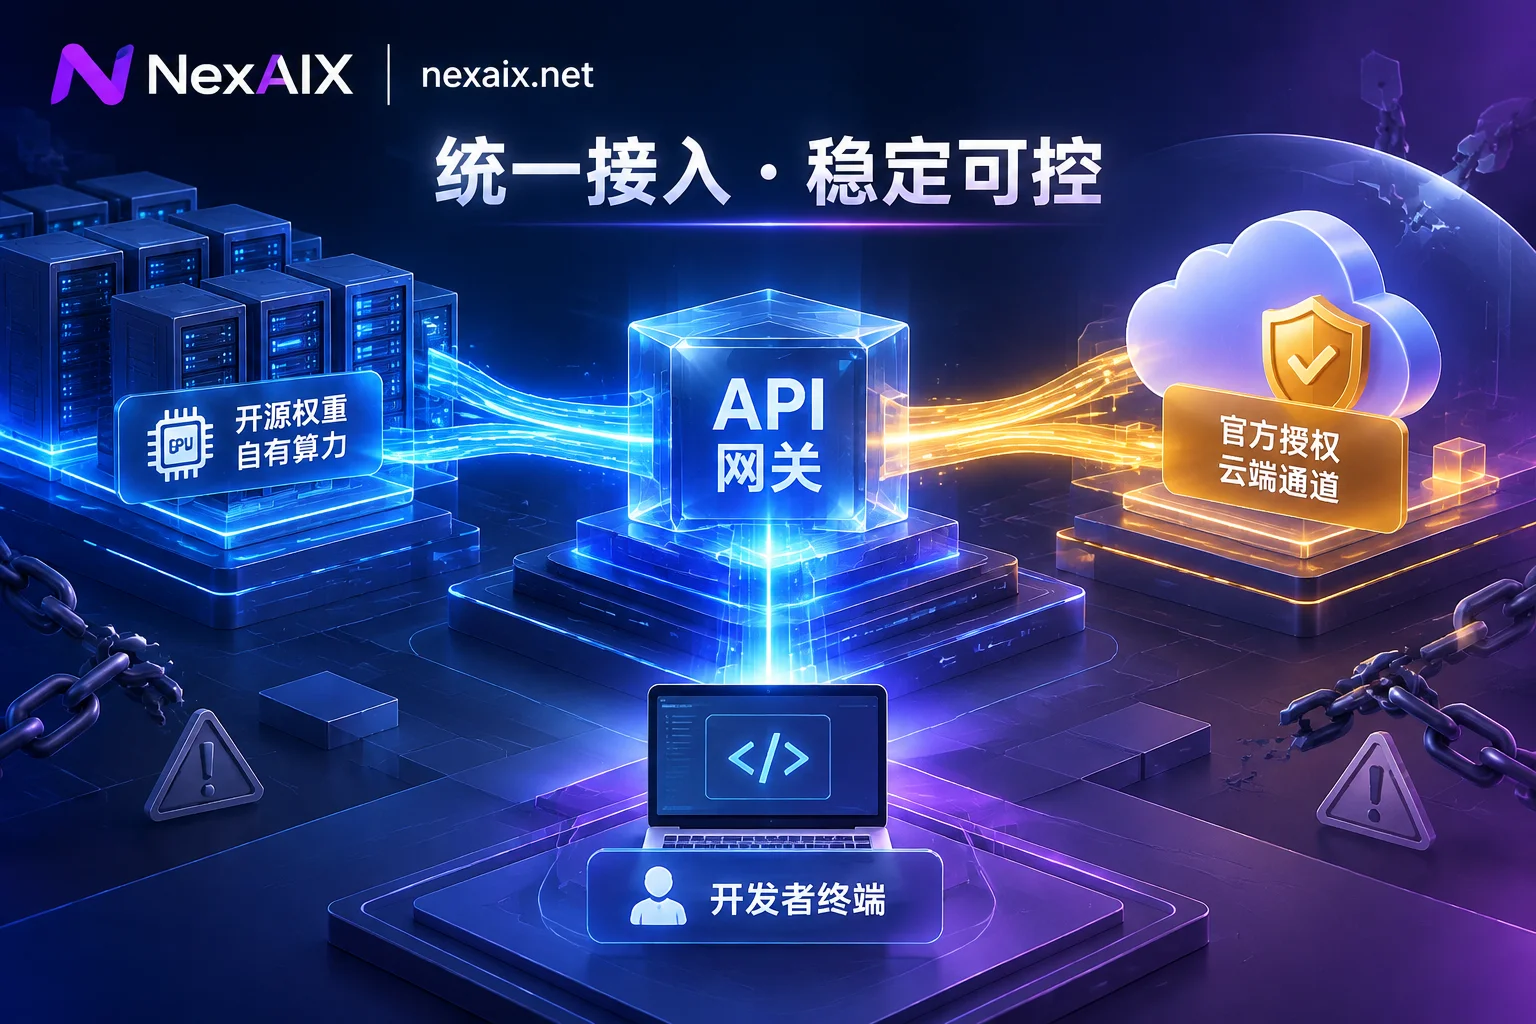
gpt-oss-120b 是 OpenAI 用 Apache 2.0 开源的 MoE 推理模型,117B 总参数、单次激活 5.1B,支持 128k 上下文与 reasoning_effort 推理档位。本文从任务选型切入,讲清 OpenAI 兼容端点怎么改、推理档位怎么选、max_tokens 设太紧为什么会拿到空回复,以及开源权重模型特有的量化缩水与小模型路由该怎么验。

Qwen3.6 API 接入指南:Plus 与开源版怎么选、思考模式开关与长上下文验证

从手上的任务出发判断该用 Qwen3.6-Plus 还是 35B-A3B / 27B 开源版,给出 OpenAI 兼容端点的接入写法、思考模式开关与 reasoning_content 解析、工具调用与思考留存的注意点,以及上下文和降配的实测方法。