NexAIX-官方博客
只是一个默认分类
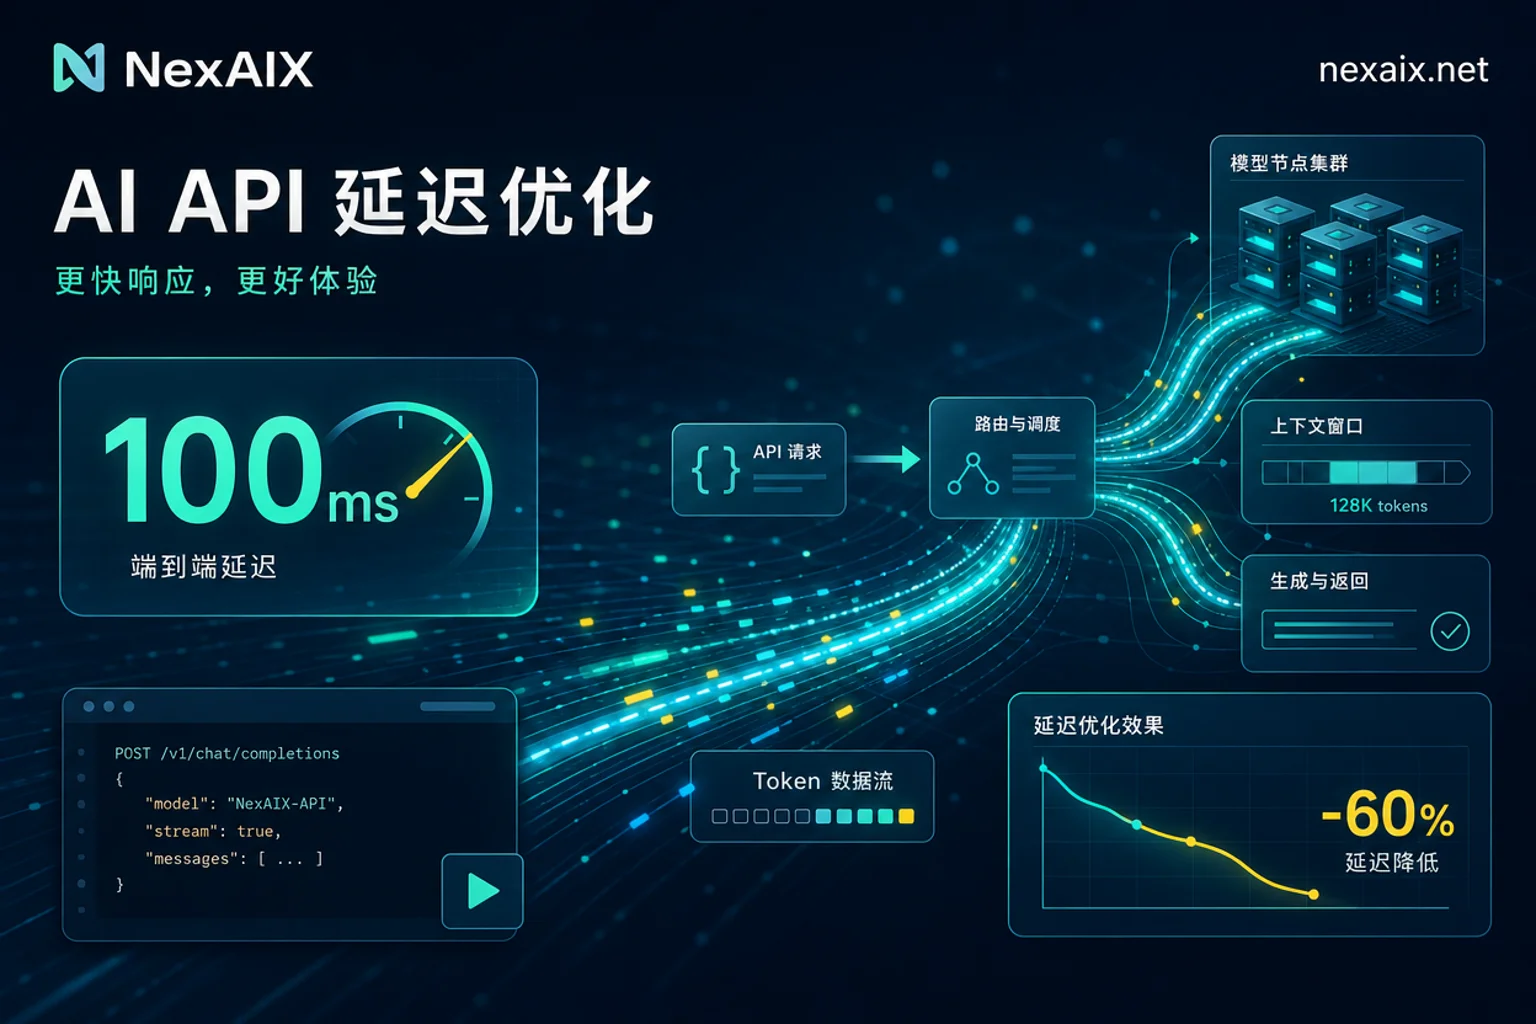
AI API延迟怎么压到100ms内?拆解可控环节与达标线
AI API延迟主要由客户端可控与服务商推理栈决定两部分构成,先分清TTFT与端到端再谈优化。2026年6月,Together AI与NVIDIA展示的推理栈已能把Agent前64词输出压进100ms,说明延迟优化正从“选模型”转向“选推理栈”。先分清三个数:TTFT、输出吞吐与端到端各自决定什么体验讨论AI API延迟,第一步不是调参,而是把三个容易...
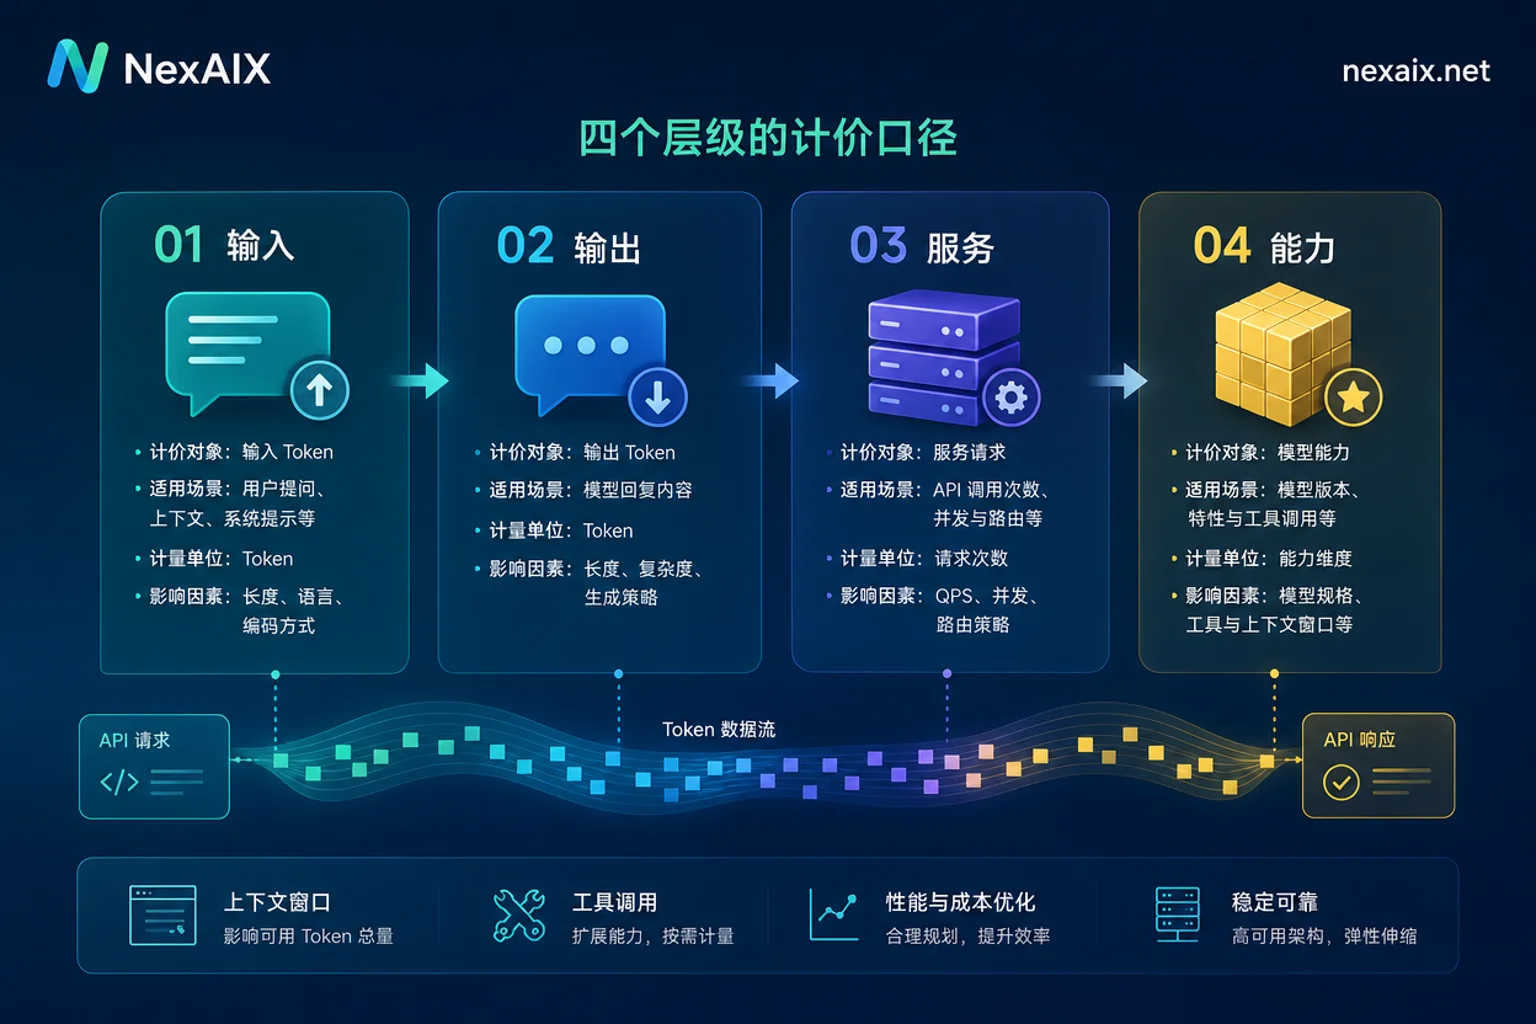
AI API价格怎么比?先统一四层计价口径再算
先给结论:AI API价格不能拿标价直接横向比,必须把输入档(缓存命中/未命中)、输出档、服务档位、能力档位四层口径统一后,再按自己实际请求分布折算成加权单价才有意义。2026年7月30日OpenAI对GPT-5.6阶梯调价、7月31日DeepSeek-V4-Flash-0731上线,两件事同时改写了当前比价基准,正好拿来做量级参照。口径一:输入 to...
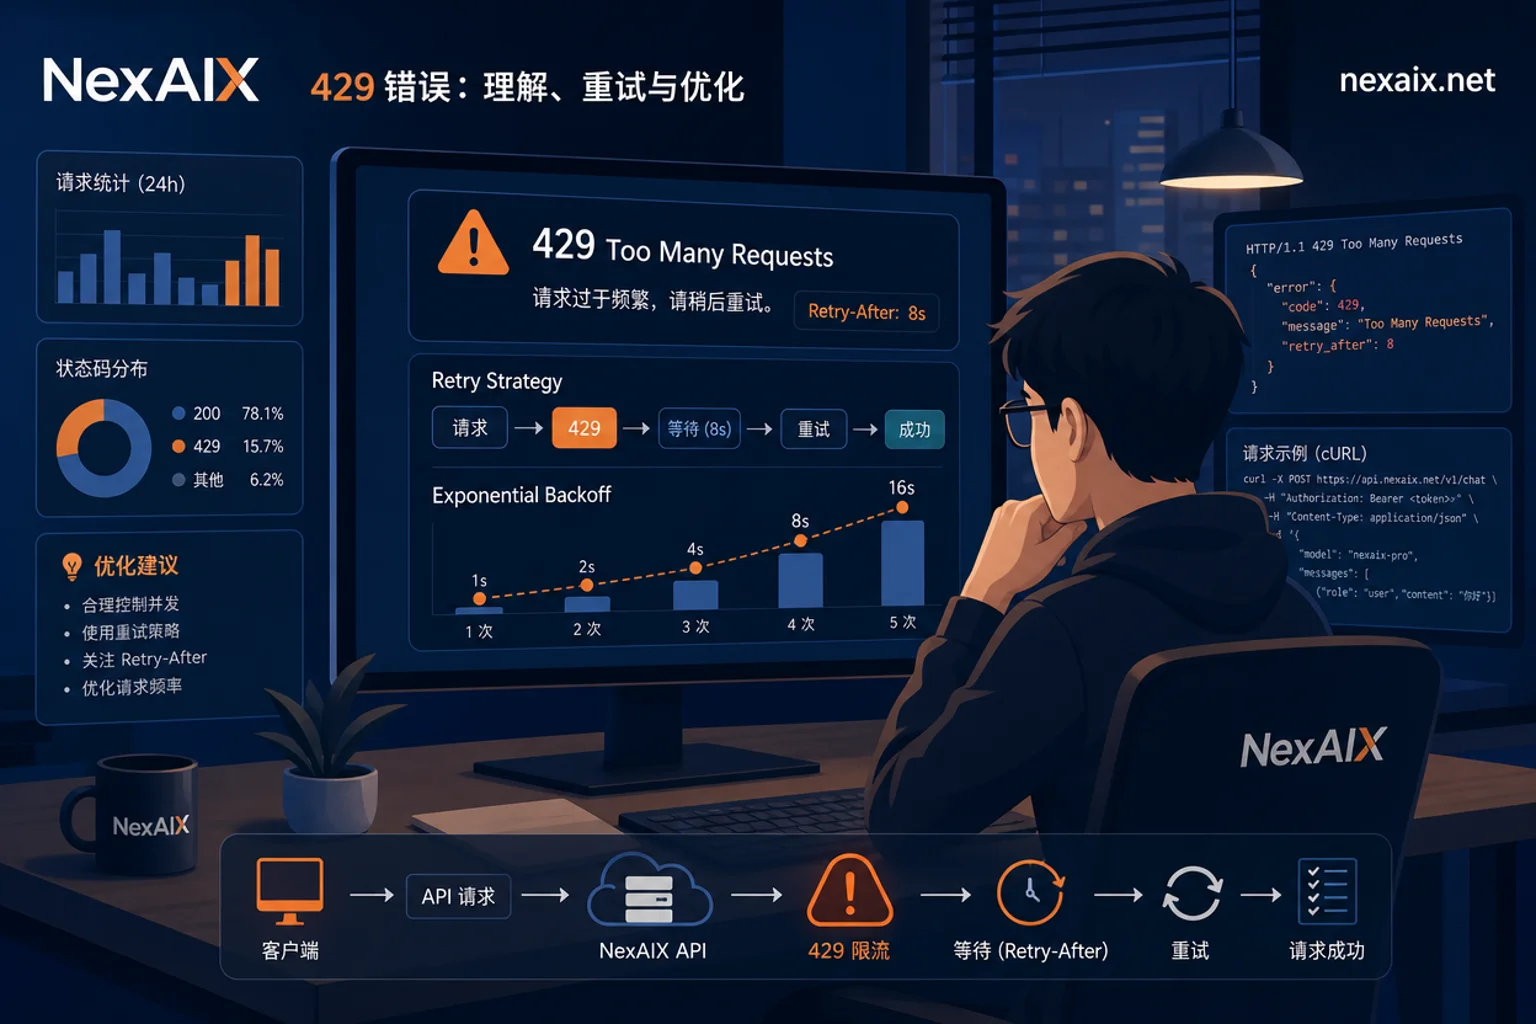
AI API 429报错怎么排查?四类成因判定与重试退避指南
处理 AI API 429 报错,先记住一条原则:不要一律加重试,而是先按三个字段把这 429 分到四类成因里,再决定是改代码、加档位还是充值。OpenAI 官方在 2026 年文档中把 429 拆成了限流、项目消费上限、预付费余额耗尽三种错误体,DeepInfra 则在 2026 年 6 月上线了 service_tier: 'priority' 优...
AI API成本优化怎么算?缓存命中与上下文预算指南
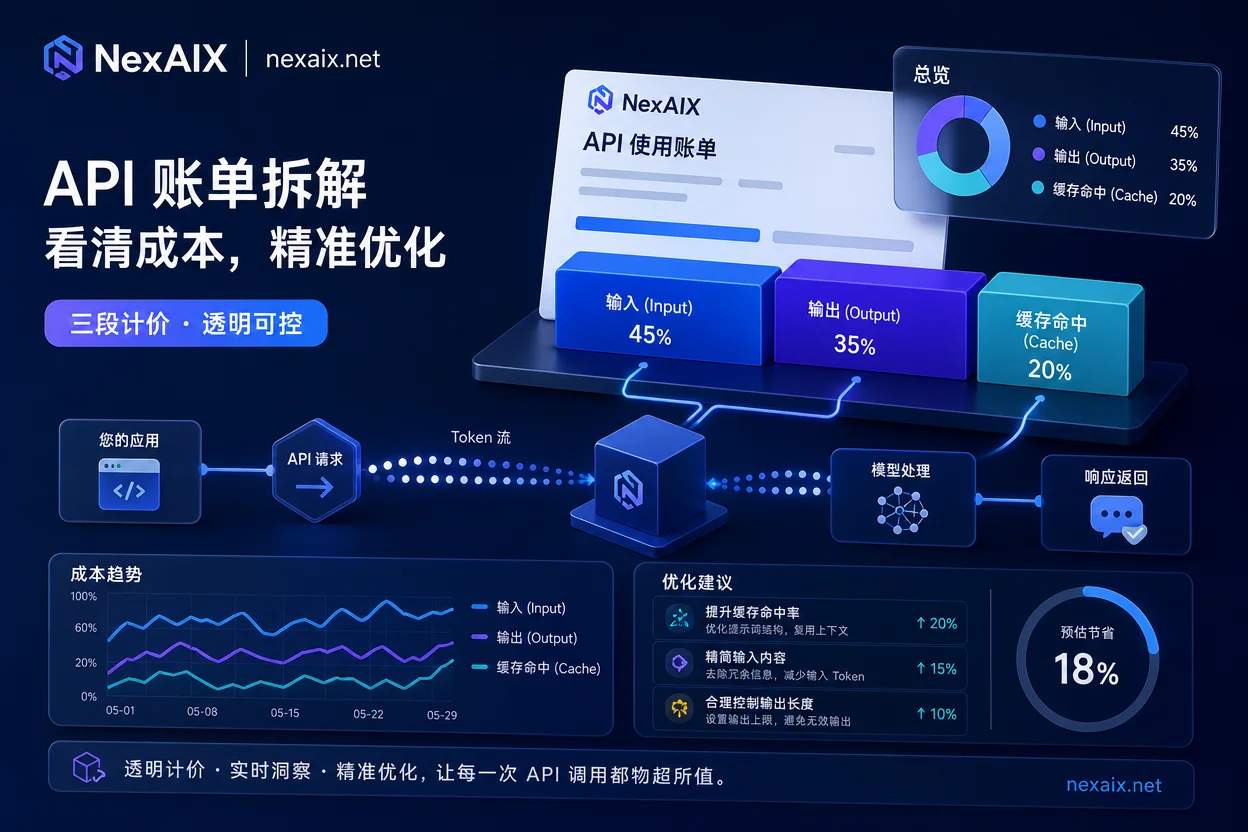
AI API成本优化的核心不是换更便宜的模型,而是先把账单拆开:单次请求价格 = Cache Miss 输入 token 数 × 单价 + Cache Hit 输入 token 数 × 单价 + 输出 token 数 × 单价。从 2026 年 7 月 31 日 DeepSeek-V4-Flash-0731 公测公布的三档单价看,Cache Hit 与...