 NexAIX-官方博客
企业AI API的容量保障不是一个开关,而是账户级配额、共享池请求级档位、专属资源池、私有部署四档递进的形态,能写进合同的通常只有后两档。前两档只影响排队顺序与成本,后两档才谈得上硬承诺。2026年8月11日IBM与Together AI的协议,正在让算力归属成为选型必问项。下文逐档拆解这四档,给出横向对照表、签约前条款清单与试用期验收方法。
先给结论:企业AI API的容量保障分四档
企业AI API的容量保障可以概括为四档:账户级配额、共享池内的请求级服务档位、专属资源池、私有部署。前两档是“软保障”,主要影响排队顺序和成本,但不承诺绝对容量;后两档是“硬保障”,算力被明确归属,容量指标才具备写进合同的前提。绝大多数采购纠纷,都源于拿软保障当硬保障来预期。理解每一档保障什么、失效时看到什么,是签约前必须补的功课。
第一档:账户级 RPM/TPM 配额保障什么,不保障什么
RPM(每分钟请求数)和TPM(每分钟Token数)配额是每个企业AI API账户都有的基础限制,但它本质是上限而非下限:它限制你最多能发多少请求,却不承诺平台一定能全部接住。失效时的典型现象是:配额明明没打满,却出现429限流或排队延迟被拉长。采购沟通时,建议问清三个口径:配额按账户还是按API密钥计算、按分钟还是滑动窗口统计、超限时返回什么错误码以及能否临时提额。如果供应商对这些口径含糊其辞,说明配额管理可能并不透明。同时,关于并发上限与配额口径的设定,可参考AI API并发上限怎么定一文。
第二档:共享池内的请求级服务档位
当多个客户共享同一批算力时,供应商会提供不同优先级的服务档位。以DeepInfra在DeepSeek-V4-Pro-0813上提供的Priority和Flex两档为例(截至2026年8月的公开档位设置),Priority档在排队中拥有更高优先级,但高峰期整池紧张时,它只影响你的相对位置,并不代表有保留容量。这类档位解决的是排队顺序,而不是容量保障。买Priority档不等于买了“不会限流”的保险,它只是共享池中的次优解。理解这一点,就能避免把“优先”和“保留”混为一谈。另外,显式缓存控制(Cache retention)这类参数同样属于成本优化手段,与容量承诺无关。
第三档:专属资源池,AI API专属算力值不值得买
当算力实例与你的账户绑定时,并发上限、延迟分布和维护窗口才具备被写成条款的基础。头部推理服务商近期通过长期算力绑定来支撑企业侧承诺(详见后文时效参照一节)。专属资源池的代价也很明显:起步成本高、容量弹性受限、扩容需要提前排期。适合业务峰值稳定、对延迟敏感的核心生产链路。
第四档:私有部署
私有部署是约束驱动而非性能驱动的选择:数据不能出域、行业合规要求、审计留痕归属、与内网系统的网络边界,这些硬条件会让API调用变得不可行。它把容量问题转化为自建运维问题——你需要自己负责扩容、排障和高峰兜底。评估私有部署前,先确认三件事:模型权重能否合规获得、运维团队是否具备模型调优和推理优化能力、峰值容量由谁承担。如果这三条都不满足,私有部署可能会变成新的瓶颈。
为什么算力绑定成了供应商差异化
推理服务商正从纯Token计费竞争转向以专用硬件锁定吞吐确定性。IBM与Together AI在2026年8月11日达成的2.4亿美元协议,正是在IBM Cloud上部署NVIDIA HGX B300推理集群,协议中提到的“30倍于上一代的AI工厂吞吐输出”是厂商公开口径下的整体产能描述,不能理解成任何单账户的TPS、并发或延迟承诺。作为采购方,这条新闻应该变成你的提问依据:供应商的算力是自有、长约锁定,还是随行就市转售?算力的归属决定了容量承诺的底气。选择中转服务时,可参考AI中转站怎么选的思路。
判据对照:独立资源池和共享池API有什么区别
| 方案 | 成本 | 并发上限 | 延迟确定性 | 故障归因 | 合规审计 | 适用业务形态 |
|---|---|---|---|---|---|---|
| 账户级配额 | 低 | 低,受账户限制 | 低,受共享池影响 | 难,需自行排查 | 弱,元数据有限 | 内部工具、原型验证 |
| 请求级服务档位 | 中 | 中,受共享池整体负载 | 中,Priority提升排队优先级 | 中,有优先级标识 | 中,可观测优先级 | C端峰值业务、批处理 |
| 专属资源池 | 高 | 高,独立算力 | 高,可承诺延迟分布 | 易,算力隔离 | 强,独立审计 | 核心生产链路、稳定峰值 |
| 私有部署 | 最高 | 自建决定 | 自建决定 | 完全自控 | 最强,全程自持 | 强合规、数据不出域 |
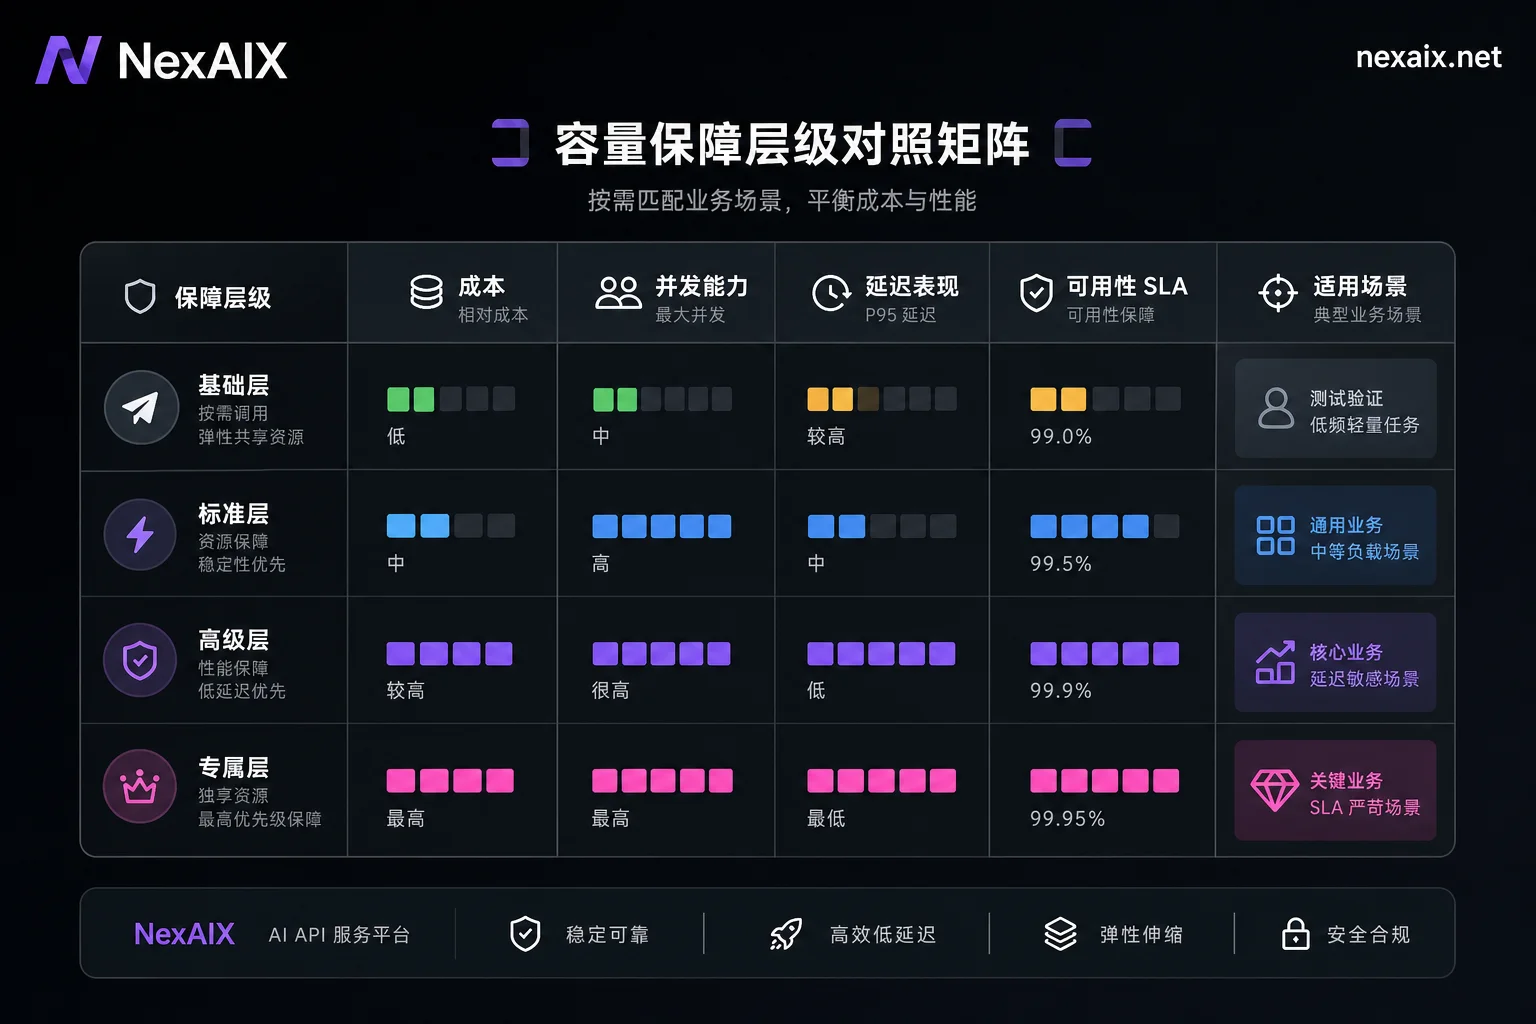 需要说明,以上是定性对比,具体数值取决于供应商的公开文档与合同条款。
签约前必须问清的条款
这部分清单可以带进任何企业AI API的供应商沟通中。
配额口径: 问清配额按账户还是密钥、按分钟还是滑动窗口,超限返回什么错误码。含糊回答意味着风险不可控。
降级行为: 满载时是返回标准429并建议重试,还是静默切换到更便宜的模型?这是判断供应商是否诚实的关键。
模型标识: 若供应商不承诺model字段对应实际执行模型,你就无法从返回体自证高峰期拿到的是不是签约模型——这条应当要求写成书面承诺。
账单对齐: usage汇总与账单是否可逐条对齐?能否看到每次请求的token数和费用明细?
故障责任: 出问题时,故障归因的日志证据由谁提供?是供应商给出完整链路,还是让客户自己猜?
在这方面,NexAIX公开提供企业合同、独立资源池与私有部署评估,并明确承诺:满载时返回标准429与重试建议,不静默切换到更便宜模型;返回体model字段对应实际执行模型;仅保留请求ID、模型名、token数、时间戳、状态码等计费与排障元数据。这些行为承诺正好对应容量审计与账单对齐时的核对点。你可以拿这三条去逐项验证任何供应商——包括NexAIX自身。
试用期怎么验收企业AI API的容量承诺
把合同承诺翻译成可复测的观察项,远比测出峰值数字更有价值。建议这样做:
- 用同一套OpenAI兼容代码,在不同时段(白天、夜间、促销日)运行固定请求集。
- 记录状态码分布,尤其关注是否出现非429的静默失败(比如200但返回错误内容)。
- 检查返回体model字段与请求模型是否一致。
- 汇总usage数据,与账单逐条对齐,验证计费是否准确。
- 观察错误响应是否带有可用的重试指引(如Retry-After头)。
 验收目标不是测吞吐极限,而是验证行为一致性——供应商的承诺是否在任何时段都成立。
常见问题
共享池是不是一定会被限流?
不一定。共享池在高负载时可能触发限流,但具体取决于供应商的容量规划和调度策略。建议在试用期的高峰时段测试,观察是否出现429或延迟明显增加。如果供应商提供Priority档,可以购买后对比效果,但别指望它能完全避免限流。
独立资源池是不是就不会返回429?
不一定。独立资源池通常能提供更稳定的容量,但如果你的请求量超过了池子的实际承载能力,依然可能触发限流或排队。合同里应明确并发上限和超额处理方式。测试时可逐步提高并发,找到实际边界。
专属算力该在什么业务量级开始考虑?
当共享池波动已经影响到你自己的SLA承诺、峰值时段429比例或P95延迟出现周期性抬升、且业务峰值形态稳定可预测时,再评估专属资源池。决策依据建议采用试用期记录的状态码分布与延迟分布。
私有部署和API调用能否混合使用?
可以,混合架构并不少见。比如将核心数据敏感的请求走私有部署,常规请求走API。关键是确保两边的接口兼容和数据一致性。如果想进一步了解,可以参考AI API选型一文。
试用额度能不能验出容量问题?
能,但要注意方法。用固定请求集在高峰时段反复测试,记录状态码和延迟分布。免费额度可能有限,但足够做小规模验证。重点观察是否出现静默降级或配额未满却限流的情况。也可以参考零日志AI API怎么验证中的思路。
建议读者把本文的提问清单直接带进供应商沟通,并到NexAIX的限速与配额、错误码文档及状态页核对当前口径,先用测试额度跑一轮行为一致性验收,再决定是否进入独立资源池或私有部署评估。



评论(0)