 NexAIX-官方博客
拿到 429 Too Many Requests,不要第一反应就加重试。先做一件事:把响应的标头和响应体里的 error code 打出来。因为 429 至少对应两种完全相反的处置:
- 频率/吞吐超限(如
rate_limit_exceeded):等一会儿能恢复,该退避重试; - 账户配额耗尽(如
insufficient_quota,余额不足、额度用完):等一万次也不会好,必须立刻停止重试并告警。
把这两类混在一个 except 里盲目重试,是线上故障被拉长的常见原因——每次重试都在制造无效请求,日志里全是 429,真正的原因(余额)被淹没。
下面按你排查的顺序展开:先看清限流是怎么计量的,再读标头,再写重试,最后才是架构层的规避。
限流不止“每分钟多少次”
多数 OpenAI 兼容端点的限流是多维度的,任意一维打满就返回 429:
- RPM / RPD:每分钟、每天的请求数;
- TPM / TPD:每分钟、每天的 Token 吞吐量;
- 并发或突发上限:短时间内同时在途的请求数。
最容易被忽略的是 TPM 的计量口径。请求进网关时,通常按 输入 Prompt 的 Token 数 + 你声明的 max_tokens 做预占,而不是等生成完了按实际输出结算。这意味着:
一个 3K 输入、max_tokens=8192 的请求,即使实际只输出了 200 个 Token,在进入网关的那一刻仍可能占掉一万多 TPM 额度。所以常见的一种“明明请求量不大却频繁 429”,根源是 max_tokens 随手写了个很大的值,几个并发就把窗口预占满了。把 max_tokens 调到业务实际需要的上限(比如摘要类任务给 512、分类任务给 64),往往比加重试更立竿见影。
另外注意:流式(stream)不会降低限流占用。它改善的是首字延迟和用户体感,Token 该算还是算。
先读标头,别猜等多久
429 响应里通常带有明确的等待指示,优先级高于你自己算的退避时间:
Retry-After:单位一般是秒;retry-after-ms:毫秒级,精度更高。
只要它存在,就按它等。在这个时间之前重试,几乎必然再吃一个 429,等于白烧一次配额和一次连接。
更有价值的是那组余量标头,成功响应里也会返回,可以让你在撞墙之前就减速:
| 标头 | 含义 |
|---|---|
x-ratelimit-limit-requests | 当前窗口请求数上限 |
x-ratelimit-remaining-requests | 剩余可用请求数 |
x-ratelimit-reset-requests | 请求配额重置时间 |
x-ratelimit-limit-tokens | 当前窗口 Token 上限 |
x-ratelimit-remaining-tokens | 剩余可用 Token |
x-ratelimit-reset-tokens | Token 配额重置时间 |
实用做法:在 HTTP 客户端里加一个中间件,把这六个值抽出来写进指标系统。当 remaining-tokens 低于上限的 10%~20% 时,主动把发送速率压下来或把请求塞进队列,而不是等 429 来教你。
有一点要提醒:这套标头是兼容规范里的常见实现,不是所有端点都完整返回。接入任何一个端点前,先用一次真实请求把响应标头原样打出来看看,确认哪些字段可用、单位是秒还是毫秒,再写依赖它们的逻辑。缺字段就退回到纯退避策略。
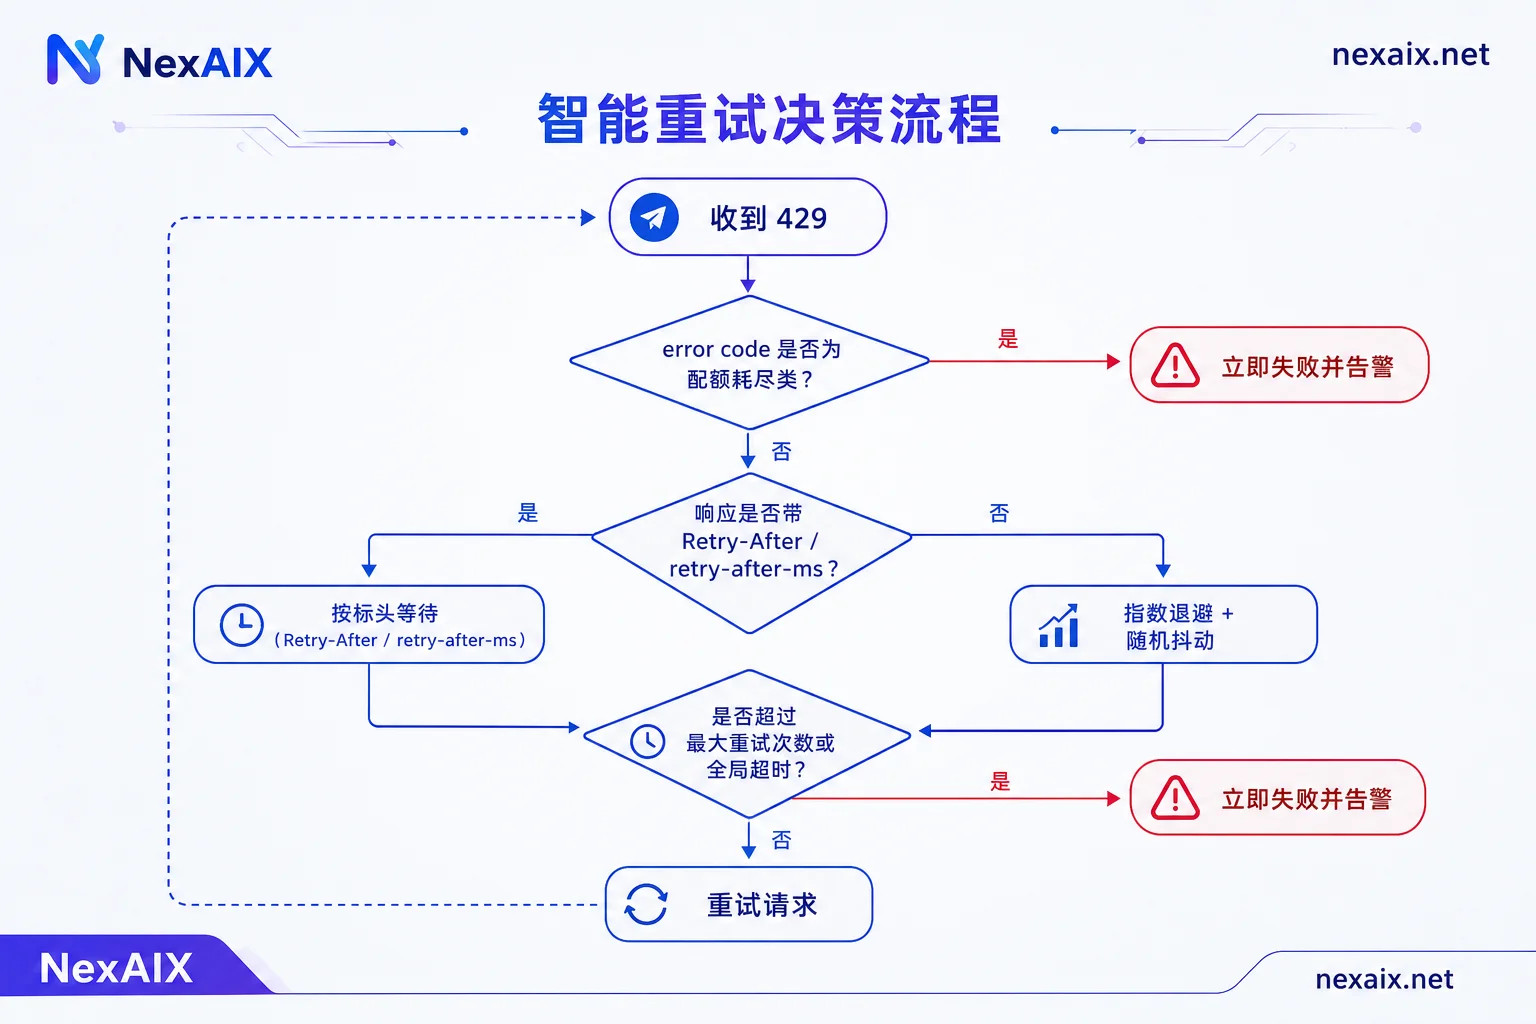
重试骨架:指数退避 + 抖动
拿到 429 且判定为频率超限后,标准算法是带随机抖动的指数退避:
wait = min(max_delay, base_delay * 2^attempt) + random_jitter抖动这一项不是可选装饰。如果十个并发同时被限流、又同时按同一公式退避,它们会在同一毫秒一起回来,形成惊群,再一起被拒——退避变成了同步器。加上随机项才能把重试打散。
一个可以直接改用的 Python 骨架:
import random, time
import httpx

BASE_DELAY = 0.5      # 秒
MAX_DELAY = 30.0
MAX_RETRIES = 5
GLOBAL_TIMEOUT = 90.0 # 整个调用(含重试)的硬上限

FATAL_CODES = {"insufficient_quota", "billing_hard_limit_reached"}

def call_with_retry(client, payload):
    deadline = time.monotonic() + GLOBAL_TIMEOUT
    for attempt in range(MAX_RETRIES + 1):
        resp = client.post("/chat/completions", json=payload)
        if resp.status_code != 429:
            resp.raise_for_status()
            return resp.json()

        # 1. 配额类错误:立即失败,不重试
        code = (resp.json().get("error") or {}).get("code")
        if code in FATAL_CODES:
            raise RuntimeError(f"quota exhausted: {code}")

        # 2. 服务端给了等待时间就照办
        wait = None
        if "retry-after-ms" in resp.headers:
            wait = float(resp.headers["retry-after-ms"]) / 1000
        elif "Retry-After" in resp.headers:
            wait = float(resp.headers["Retry-After"])
        if wait is None:
            wait = min(MAX_DELAY, BASE_DELAY * (2 ** attempt))
        wait += random.uniform(0, wait * 0.3)  # 抖动

        # 3. 超过全局预算就别等了,把失败交回上层
        if attempt == MAX_RETRIES or time.monotonic() + wait > deadline:
            raise TimeoutError("rate limited, retry budget exhausted")
        time.sleep(wait)
几个容易漏掉的边界:
- 必须有全局超时。只设最大重试次数不够,5 次退避加起来可能等上一分钟,前端早超时了,你还在烧配额。
- 区分幂等性。纯文本生成重试没问题;但如果这次调用会触发工具调用、写库、发消息,重试前要确认下游能去重。工具调用循环里的重试要放在循环外层还是内层,取决于你的状态记录方式,可参考工具调用 API 的循环骨架写法。
- 重试要有可观测性。把 attempt 次数、等待时长、error code 打进日志,否则事后无法判断限流是偶发还是常态。
- 关于退避参数怎么取值、什么时候该放弃,可以再看指数退避重试要等多久合适。
还有一类 429 的近亲值得区分:5xx 和连接超时也需要重试,但语义不同。429 是“你太快了”,503 更可能是上游拥塞。前者退避有效,后者退避加上限次数之外还应考虑降级路径。
架构层:让 429 少发生
重试是止损,不是解法。真正把限流压下去靠这四步,按见效速度排序:
1. 收紧 max_tokens。如前所述,它直接决定 TPM 预占。逐个接口审一遍,按任务实际输出长度设值,这是成本最低的改动。
2. 加发送端速率闸。在应用里用令牌桶或漏桶控制出口速率,配合一个并发信号量(比如同时在途不超过 8 个请求)。有了闸门,突发流量会在你自己的队列里排队,而不是变成一批 429。这比在服务端被动挨拒更可控——排队的请求你能看见、能测长度、能设优先级。
3. 分流非实时任务。批量打标、离线摘要、夜间回归这类任务不需要秒级响应,用独立队列低速跑,或者错峰到业务低谷。别让它们和线上对话抢同一个窗口。
4. 用长文档缓存降低计费与吞吐占用。如果同一段长 Prompt(系统提示、文档上下文)会被反复发送,开启 Prompt Caching 类能力可以减少非缓存 Token 的消耗。具体是否支持、命中条件如何,以你所用模型的文档为准。
按 Key 隔离:别让一个脚本拖垮线上
最实用的一条隔离手段是多把 Key 分业务:线上服务一把、内部工具一把、开发调试一把、批量任务一把。这样某个同学在本地跑压测把额度打满,只会打满他自己那把 Key 的窗口,线上请求不受影响;同时用量账单也能按业务归因,排查“谁把 TPM 吃了”只要看 Key 维度的曲线。
NexAIX 就是按 Key 隔离的:每把 Key 有独立的配额、权限和用量账单,配额与限速数值公开可查,你在接入前就能知道自己的窗口有多大,而不是靠反复撞 429 去试探边界。端点是 OpenAI 兼容的 https://api.nexaix.net/v1,迁移时只改 base_url,上面那套标头解析和退避逻辑不用重写。模型清单和每个模型属于哪种供给方式(开源权重模型部署在自有算力集群,或闭源模型走厂商官方授权渠道)在模型页上标明,选模型时顺手确认对应的规格与限速即可。
多把 Key 之间怎么划额度、团队协作时怎么分配,另有一篇写得更细:多人共用 API key 怎么分配额度。
分不清是自己超限还是上游拥塞时
这是走中转接入时最容易卡住的一环:429 到底是你打满了自己的配额,还是中间层把多家用户的流量挤在一条通道上?
判断线索有三条:
- 配额是否公开。如果限速数值明确写出来,你可以拿本地统计的 RPM/TPM 对一下。自己算出来远低于上限却持续 429,问题就不在你这边。
- 余量标头是否可信。
remaining-*还剩很多却被拒,说明拒绝发生在你的配额账本之外。 - 429 的时间分布。如果集中在整点、高峰段,且和你自己的流量曲线不吻合,更像是共享通道的拥塞。
NexAIX 是单一供应方、单一端点,不做多上游路由,也不在高峰时换小模型、降精度或砍上下文;四条承诺和对应的验证方法都写在明处,可以自己复核。关于供给透明度和限流排查在选型阶段怎么核,API 中转站选型的三大工程风险里有更完整的核对方式。
上线前过一遍
- [ ] 把一次真实请求的响应标头完整打印过,确认哪些
x-ratelimit-*字段可用、Retry-After单位是秒还是毫秒; - [ ] 429 处理里区分了
rate_limit_exceeded与insufficient_quota,后者不重试并告警; - [ ] 退避带随机抖动,设了最大重试次数和全局超时;
- [ ] 逐接口核过
max_tokens,没有留下过大的默认值; - [ ] 发送端有速率闸和并发上限,批量任务走独立队列;
- [ ] 线上、内部工具、调试、批量各用独立 Key;
- [ ] 429 次数、退避等待时长、Key 维度用量都进了监控。
真正难受的从来不是偶发 429,而是没有观测手段、只能靠猜的 429。把标头读出来、把 Key 拆开、把速率闸装上,绝大多数限流问题在事故之前就已经暴露在图表里了。



评论(0)