 NexAIX-官方博客
选AI API聚合平台,先看两个能直接影响账单和稳定性的维度:返回体model字段是否与请求一致、满载时是否返回标准429而不是静默切换模型。2026年8月19日,OpenRouter宣布并入Stripe,并披露日均处理来自400多个模型的token量超10T、开发者社区超1000万人,这标志着计量与财务治理成为聚合层的演进方向。对于要接入多家模型的团队,聚合平台的价值不只是多模型中转,而是把成本、配额和归因管清楚。本文按能力维度对照,帮你下单前验证关键差异。
AI API聚合平台和官方API的账单差在哪
先说清楚AI API聚合平台和官方API的区别。接入成本上,聚合平台给一套统一凭证,省去逐家申请、维护多套key的麻烦;运行成本上,路由、重试可能产生额外的token消耗和延迟;治理成本上,聚合层承担计量与财务职责,提供统一的用量视图和配额控制。这些能力都建立在多一跳的架构上,选型时需综合评估。
模型标识怎么核
很多人关心聚合平台调用的是不是官方模型。验证要点在于:返回体中的model字段,是否如实反映实际执行的模型。自己验证的方法:请求时指定具体的版本号,而不是用别名;比对返回体中的model字段与请求值是否一致;留意别名在版本更新期是否发生指向变化;再用固定prompt做输出风格与tokenizer切分的横向对照,但注意这种对照只能作为旁证、不能作为结论。用SDK只换base_url发起请求并读取返回体字段即可。不能自测的,只能靠条款确认,比如平台是否使用第三方推理引擎、是否经过后处理。遇到这类说法,要求对方写进书面说明。
协议兼容层的兼容度
OpenAI兼容不是布尔值,而是分层的。普通对话通,不代表流式增量字段完整;流式通了,不代表并行tool_calls能原样透传;多轮历史中,思考块与signature类字段是否被裁剪,也影响Agent链路的稳定性。验证方法:用同一段代码,只换base_url,依次测试三类场景,并检查:流式响应中delta字段是否包含完整的content与tool_calls增量;并行工具调用时,响应中的tool_calls数组是否原样保留每个调用的id、type、function参数;多轮回传时,如果assistant消息中的思考块或signature字段被裁剪,会导致后续请求中出现400或上下文不连贯。兼容层降级往往先在工具调用链上暴露,跑一遍就知道。
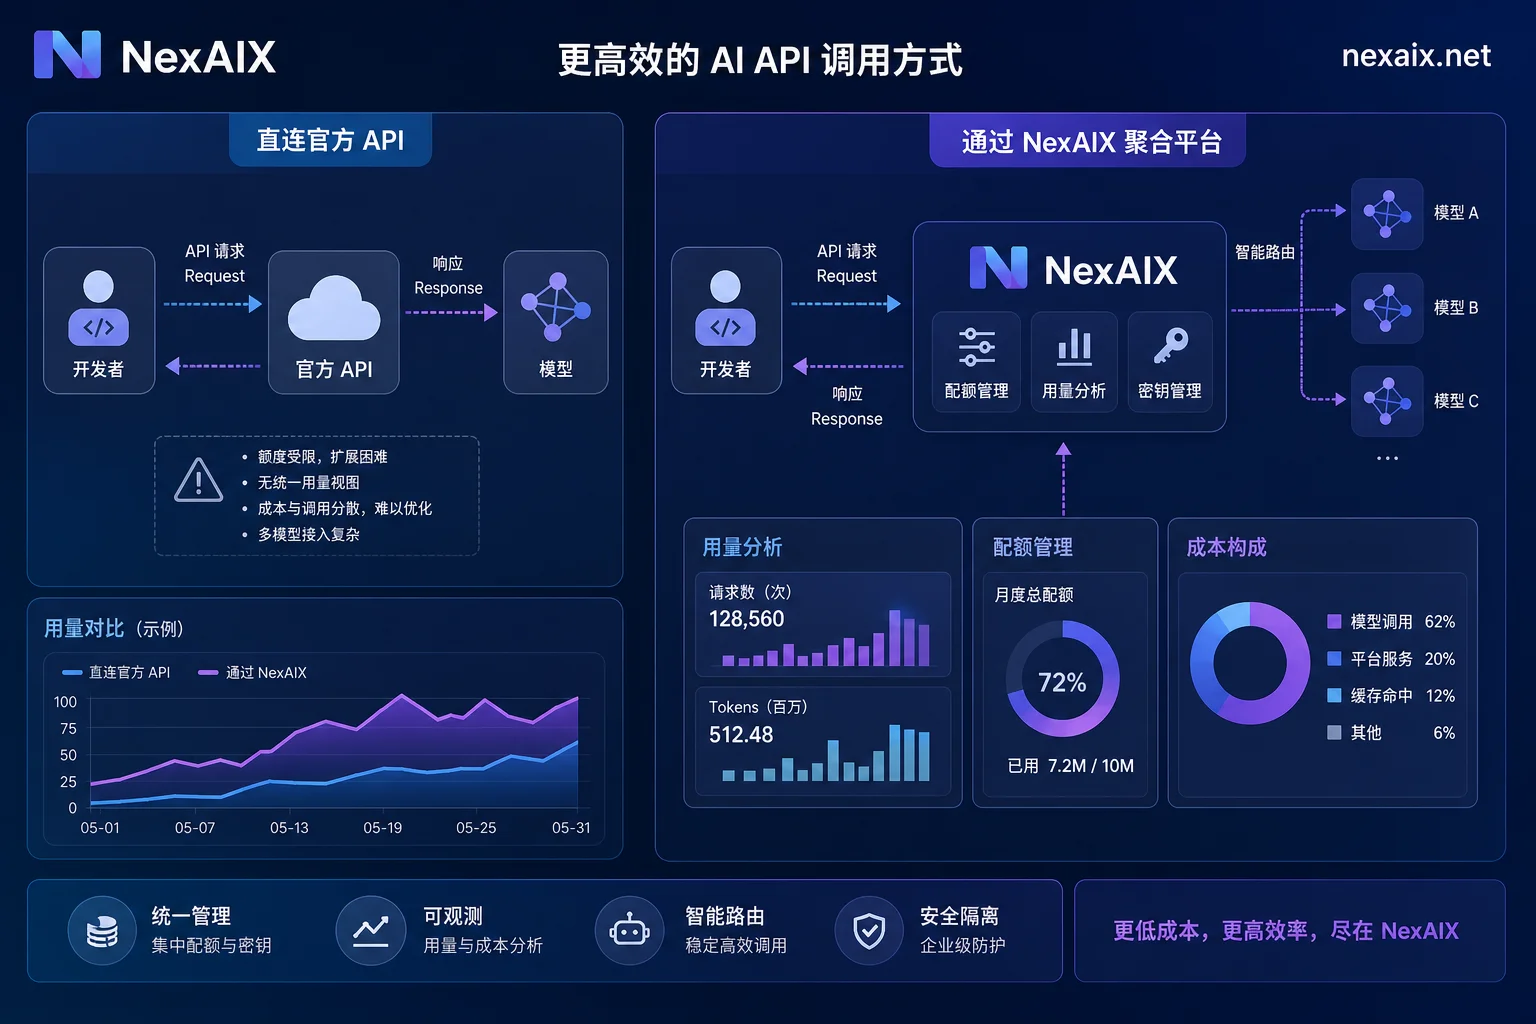
路由控制权与配额支出上限
这是选型的关键点。多人共用一个key时,怎么分配额度?先把“锁定模型”和“允许平台自选”区分开。自动分流在强JSON Schema和长步工具调用里可能导致解析失败,所以路由控制权必须能手动关闭。配额方面,确认平台是否支持按子key或工作区拆RPM、TPM和花费额度;支出上限是硬阻断还是仅告警;触达上限后,是返回标准429还是别的状态码。下表列出需要逐条确认的事项:哪些能自测,哪些必须拿到书面条款。NexAIX可作为样本行供你对照。
| 能力/条款 | 标准做法 | 需确认的细节 | NexAIX样本表现 |
|---|---|---|---|
| 返回体model字段 | 与请求一致 | 别名指向变化 | 对应实际执行模型(可自测) |
| 满载时行为 | 标准429+重试建议 | 是否静默降级 | 返回429,不切更便宜模型(可自测) |
| 配额拆解 | 按key/工作区 | 是否支持RPM/TPM/花销分拆 | 需书面条款(见其文档与合同) |
| 支出上限 | 硬阻断或告警 | 触达后的状态码 | 需书面条款(见其文档与合同) |
| OpenAI兼容 | 分层兼容 | 工具调用透传程度 | 提供base_url https://api.nexaix.net/v1供验证 |
在你正在评估的聚合平台中,自动路由的收益和风险并存,核心是你要掌握路由开关。拿NexAIX的上述两项可自测能力去问对方,能否写进合同或文档。
用量归因:谁跑爆了配额
Stripe收购OpenRouter后,工作区级用量分析正在成为聚合层的能力演进方向。团队应要求平台提供按key、按模型、按时间窗、状态码的用量切分,以及导出明细做二次分摊。但与其事后靠平台后台追查,不如调用侧自打业务标签,把请求ID和usage字段落库。这样即使平台分析维度不够细,你也能自己定位是哪个服务、哪个成员跑爆了配额。每个子key配独立用量报表,在出账时按key维度核对,这比事后猜测更直接。多人共用key时,共享key的限额可能拖累关键业务,此时要确认企业AI API容量保障能力是否具备——毕竟单个业务打满共享额度,会让其他业务无配额可用。
数据留存边界与故障痕迹
数据留存要分三类看:请求正文与模型输出、计费元数据(请求ID、模型名、token数、时间戳、状态码)、调试与安全日志。多一跳意味着上游模型商和聚合层要分别确认留存策略,特别是请求正文的留存期限与脱敏方式,必要时可通过零日志验证确认平台是否真的不记录正文。故障可观测性也很重要:满载时是标准429带重试建议,还是静默降级到更便宜的模型?超时、限流、降级,在状态页和响应体里各自留下什么痕迹?这些可以直接跑压测验证。
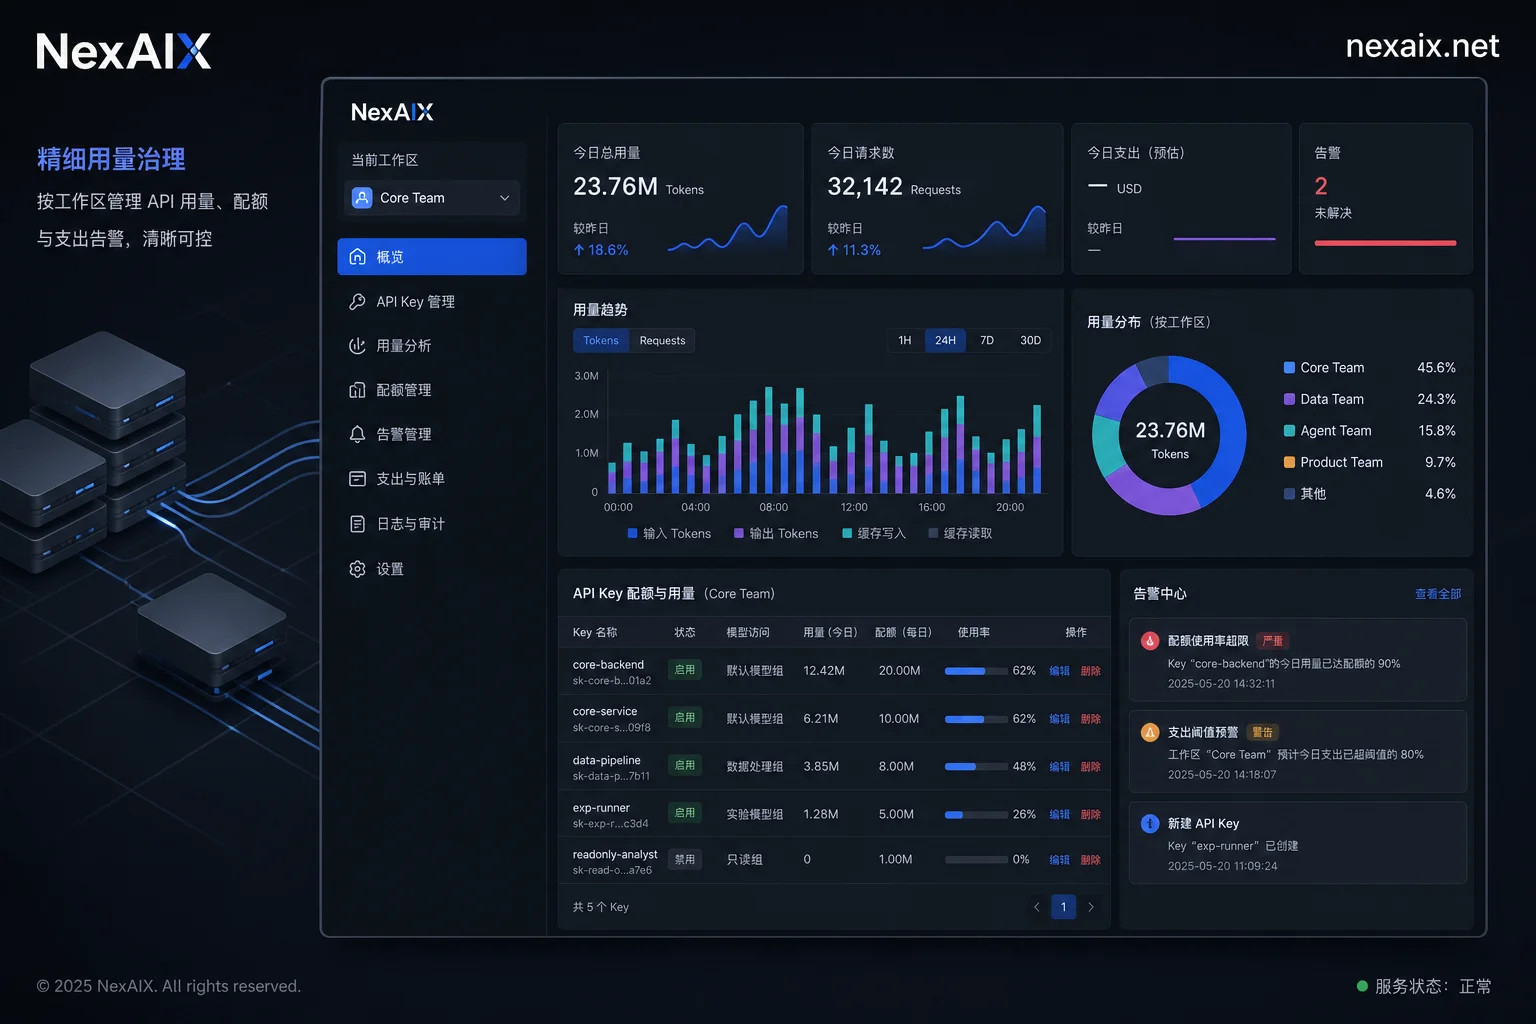
从单一共享key切到工作区配额
迁移到工作区配额,建议按编号步骤进行,避免风险:
- 按业务线拆key,保留旧key只读运行一段时间,观察流量变化。
- 在调用侧写入业务标签,并落库请求ID、usage字段,建立基线。
- 设置软上限(告警阈值),运行一周,了解真实用量分布,再决定硬阻断值。
- 将上限调到硬阻断,并接入告警与模型回退开关。
迁移期最容易出问题的,一是重试逻辑在限流状态下可能成倍放大请求;二是缓存共享前缀被拆散,导致命中率下降、成本上升。所以切key后要留意这两个指标的波动。
长上下文成本折算:以Kimi K3为例
Kimi K3这类开源模型把上下文窗口拉到了原生100万token,并采用单一平铺式计费口径(无阶梯加价),这为长上下文需求提供了新的选项。账面单价低不等于总支出低,实际支出取决于三个变量:月调用次数(N)、单次实际填充token(T)、单价(P,每百万token美元)。折算时要先算缓存折减后的填充量,再叠加重试消耗。月成本 = N × T' ÷ 1,000,000 × P,其中T'为折减后的填充量;重试消耗按折减后的基数百分比计算。
假设你的团队每月有10万次调用,单次平均填充5万token(长上下文可能更高),单价为每百万token 2美元(仅为演示,请按实际合同价替换)。若请求中有60%的前缀可被缓存,且缓存命中率为70%,则折减后的填充量T' = 50,000 × (1 - 0.6×0.7) = 29,000 token,基础月成本 = 100,000 × 29,000 ÷ 1,000,000 × 2 = 5,800美元。若因超时或限流导致5%的重试,额外支出 = 5,800 × 5% = 290美元,最终月支出 = 5,800 + 290 = 6,090美元。下表列出上述演示口径下的变量关系,供你代入自身数据。
| 变量 | 演示值 | 说明 |
|---|---|---|
| 月调用次数 | 100,000 | 按实际替换 |
| 单次填充token | 50,000 | 长上下文可能更高 |
| 单价($/百万token) | 2 | 演示值,按合同价替换 |
| 可缓存前缀占比 | 60% | 取决于实际请求结构 |
| 缓存命中率 | 70% | 需平台提供可观测指标 |
| 折减后单次填充token | 29,000 | 考虑缓存折减 |
| 重试率 | 5% | 额外成本 = 基础成本×重试率 |
| 基础月成本 | $5,800 | 按折减后T计算 |
| 重试额外支出 | $290 | 按折减后基数计算 |
| 含重试的最终月支出 | $6,090 | 基础成本+重试额外支出 |
注意,上述数字均为演示口径,实际成本需按你的分布代入。失效条件:如果没有可缓存前缀,缓存收益为零,且高首包时延可能抵消价格优势,甚至因重试而更贵。建议要求平台提供缓存命中率可观测指标,否则无法核算真实单次成本。
常见问题
AI API聚合平台和官方API有什么区别?
主要差在多一跳的治理能力:官方API给你直接的模型访问,聚合平台额外提供统一凭证、路由、用量分析和配额管理。代价是可能增加延迟和链路复杂度。选型时重点看模型标识是否清晰、配额控制是否硬阻断、用量归因是否够细。
多人共用API key怎么分配额度?
别再用一个裸key。拆成子key或工作区,给每个业务线独立的RPM、TPM和月度花费额度。确认平台支持按维度限额,并且能设置硬阻断。如果平台不支持,就自己用网关层做限流,但成本会更高。
怎么知道是谁把API配额跑爆了?
给每个子key配独立用量报表,按key、模型、时间窗、状态码切分。如果平台维度不够,调用侧打业务标签,落库请求ID和usage字段,出账时自己跑SQL归因。这样最快定位到具体服务或成员。
API key设置支出上限有哪些方法?
在平台控制台找到配额设置,选择月度或日度上限,填金额。注意区分硬阻断和告警:硬阻断会直接返回429,告警只发通知。建议先设一个保守的软上限跑几天,再逐步调低到硬阻断值。
聚合平台调用的是不是官方模型?
可自测部分:请求里用具体版本号,别用别名,然后比对返回体的model字段;用固定prompt做tokenizer与输出风格横向对照(只能作旁证)。只能靠条款确认的部分:平台是否使用第三方推理引擎、是否经过后处理。这类需对方给出书面承诺,别信口头“保证”。
多个团队共用同一个key,成本怎么分摊?
团队规模较小时,保留一个key并靠调用侧打标签分摊也能跑通,但事后对账往往要花额外工时。当多业务线均有稳定调用量时,按团队拆子key是更可靠的分摊方式;若平台不支持,则用网关层限流并加大SQL归因。
选定平台前,用同一段OpenAI SDK代码,只换base_url,跑一遍指定版本号的请求,核对返回体model字段、限流时的状态码与usage口径,再决定是否把生产流量切过去。



评论(0)