 NexAIX-官方博客
距离 2026 年 11 月 18 日 MiniMax-M2.5 与 MiniMax-M2.7(含 -highspeed 变体)正式停服退役已进入最后倒计时。自 10 月 19 日停止向新用户开放以来,不少基于 MiniMax API 构建自动化编程、客服工单流转或文档解析流水线的研发团队,已经在生产监控中观察到了两类截然不同的异常:要么是在按量付费链路上面临即将到来的硬性报错(Hard Failure),要么是在订阅套餐或部分聚合路由中遭遇了“模型 ID 没变、底层已被静默替换”带来的输出膨胀与解析超时。
如果您的团队此前阅读过我们的《MiniMax API 接入与选型指南:从 M3/M3.1 Flash 百万上下文、多模态 Agent 到自有算力调用》,应该已经对 M3 系列的技术底座有了全盘了解。本文将完全聚焦于存量业务割接与生产级排障视角:拆解从 M2.x 切换到 M3 / M3.1 Flash 时的行为契约变化、为什么“自动重定向”反而会冲垮 Agent 工具调用链,以及如何利用确定性的自有算力端点完成零事故灰度迁移。
一、11 月 18 日停服倒计时:为什么“只改一行 Model ID”还不够?
在大模型版本迭代中,最危险的往往不是直接返回 404,而是输入输出契约的隐式漂移。
根据 MiniMax 官方发布的退役日程,M2.5 与 M2.7 系列在 2026 年 11 月 18 日之后将全面停止响应按量 API 请求。而在此前的过渡期内,部分套餐通道已将发往 MiniMax-M2.5 和 MiniMax-M2.7 的流量自动路由至 MiniMax-M3.1-Flash;也有部分云端托管服务计划在停服日自动将未迁移的 minimax-m2.7 请求切往 minimax-m3。
这种看似省事的“无缝代换”,在工程生产环境中极易引发三类连锁故障:
1. 思考模式(Thinking Mode)机制反转导致延迟与 Token 账单激增
在 M2.7 时代,模型的推理输出长度相对固定,团队通常会按既定的平均响应耗时配置网关超时(如 15 秒或 30 秒)。然而到了 M3 代际,两款主力模型的思考机制截然不同:
- MiniMax-M3:支持在请求级别通过参数将思考模式设置为开启(
enabled)、自适应(adaptive)或关闭(disabled)。 - MiniMax-M3.1-Flash:思考模式为常驻开启(Always On),不可完全关闭,而是通过
low、medium、high、xhigh、max五档参数调节思考深度,且默认档位为max。
如果您的线上服务被上游静默路由到了默认开启 max 思考深度的 M3.1 Flash,原本只需输出一段简短 JSON 的工具路由节点,可能会先生成数千 Token 的密集内部推导。这不仅会让首字及完整响应延迟陡增、触发业务网关超时断开,还会直接推高输出 Token 消耗。
2. 上下文窗口与计费阶梯的断层
M2.7 的上下文上限为 204.8K,最大输出建议值为 65,536 Tokens;而 M3 与 M3.1 Flash 基于自研的 MSA(MiniMax Sparse Attention)稀疏注意力架构,将上下文窗口直接拉升到了 1,000,000(1M)Tokens,M3 的最大输出更是扩展到了 524,288 Tokens(推荐 131,072)。
在迁移代码库分析或长文档任务时,如果直接放开输入长度限制而未做分档治理,一旦单次请求的 Prompt 跨过 512K 阈值,就会触发超长上下文的计算开销爬升(在官方标准定价体系中,M3 超过 512K 输入后的单价会翻倍)。
3. 模态扩展与采样参数行为变化
M2.x 系列仅处理纯文本输入,而 M3 与 M3.1 Flash 是从零开始混合训练的原生多模态模型,支持文本、图像与视频输入。同时,M3 在采样温度(temperature)与工具调用(Tool Calling)的严格度上与旧版存在细微差异。如果不经过参数对齐压测就盲目切流,Agent 循环中的正则表达式或 Schema 校验器很容易因为输出格式的微小变化而中断。
二、算力与渠道困局:自建 428B 集群还是忍受黑盒中转?
在规划 M3 系列的生产落地时,基础设施负责人通常会评估两条路径:要么下载开源权重自建推理集群,要么直接调用外部 API。但在 2026 年四季度的实际算力账本下,这两条路都有明显的工程门槛:
- 自建 428B MoE 集群的显存与运维重负:
MiniMax-M3 是总参数量高达 428B(每 Token 激活约 23B 参数)的庞大混合专家(MoE)模型。即便采用 FP8 量化在 4 卡 H200 SXM5 节点上部署,要跑通完整的 1M 上下文并维持稳定的高并发吞吐,也需要深度调优 SGLang 或 vLLM 的算子分片与 KV Cache 内存池。除非团队的日均调用量达到极高水位且具备专职推理引擎团队,否则自租裸金属 GPU 的空置损耗与排障成本远超预期。 - 非透明中转站的“静默换模”与合规短板:
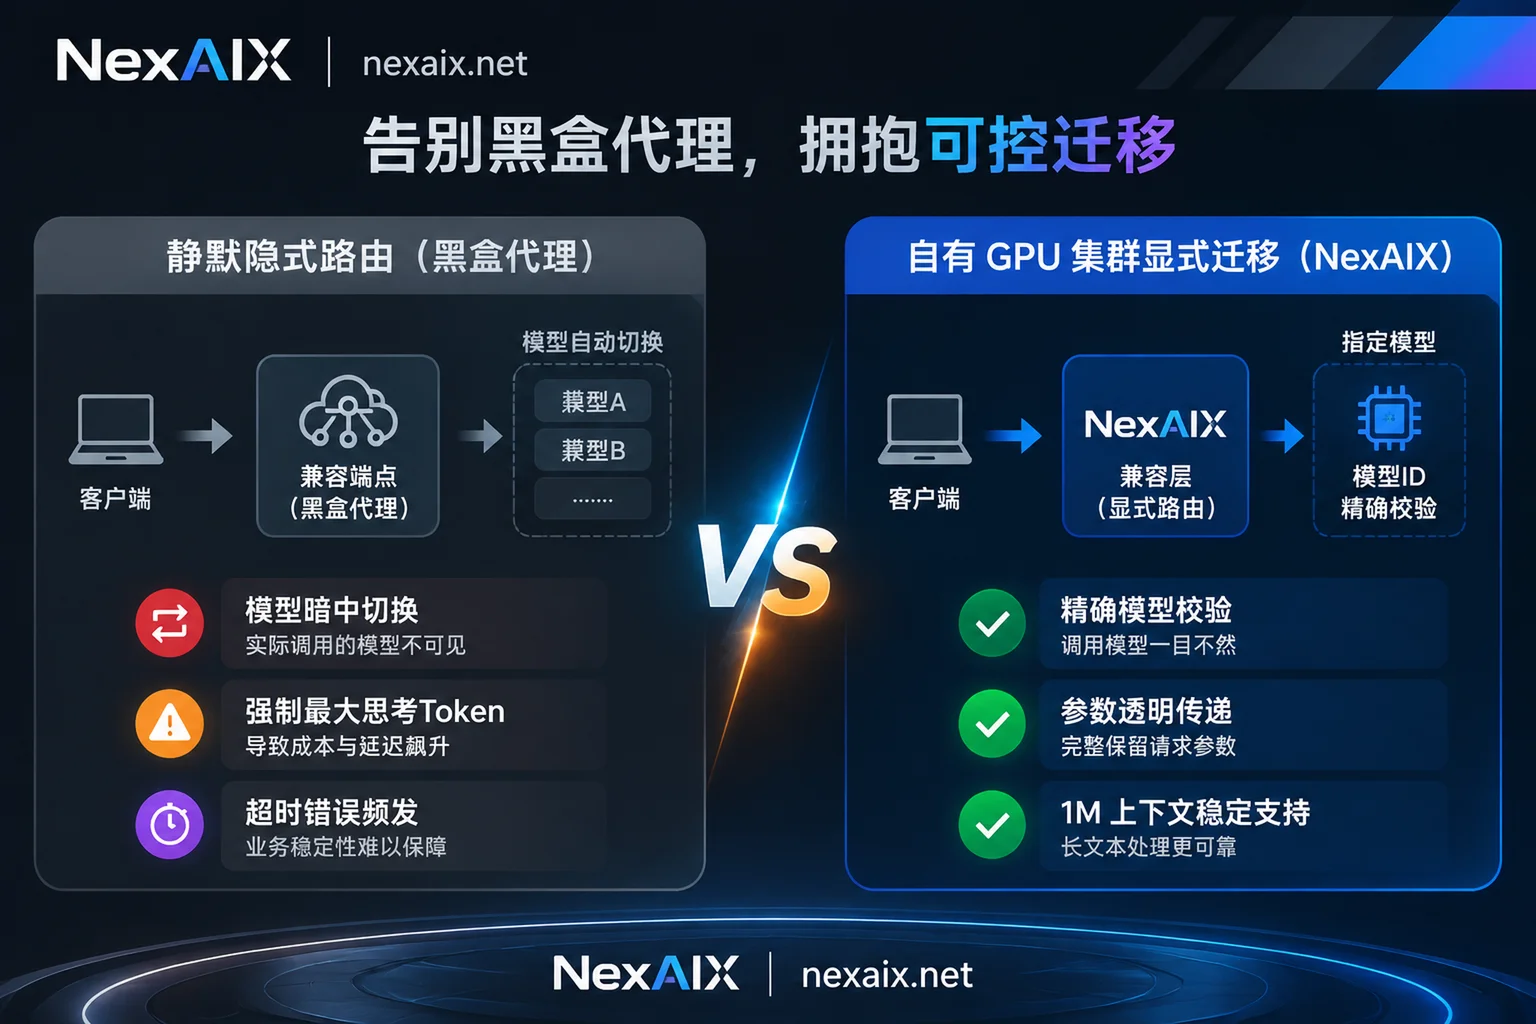
为了省去跨国结算或自建运维,部分团队会尝试接入低价 API 聚合通道。但正如我们在《别让“黑盒”API拖慢Agent开发:构建可审计、不降配的生产级Agent底层》中所剖析的,劣质号池与逆向中转常在流量高峰期将M3请求偷偷降级路由到旧版小模型,或者强行截断长上下文与max_tokens。此外,对于有严格审计要求的企业而言,缺乏国内合规合同、增值税发票以及正式的数据处理协议(DPA),会让代码库外发调用面临合规红线。
NexAIX 的解法:自有算力部署 + 拒绝隐式路由
针对上述痛点,NexAIX(nexaix.net) 提供了兼顾算力确定性与接入便捷性的生产级方案:
- 自有算力部署(开源权重):我们将 MiniMax 等官方发布的开源权重模型直接部署在自建与自租机房的自有 GPU 集群上,由自有工程团队全权运维,绝不转售不可控的第三方额度。您可以直接前往 模型广场 查看当前在售的 MiniMax 系列模型,单个模型详情页均明确标注了「自有算力部署」标签、模型 ID、上下文上限、最大输出、推理精度(如 BF16、FP8、MXFP4 等,按模型实际标注)、输入模态与开源许可。
- 坚持不降配与单一确定性响应:在 不降配与可验证承诺 下,NexAIX 返回体里的
model字段永远是实际执行的模型。我们不提供也不执行任何“静默故障转移”或“自动换模”——不换小模型、不降推理精度、不截断上下文和最大输出、不注入隐藏系统提示词,您的temperature、top_p、max_tokens原样透传。当集群遭遇突发满载时,网关会明确返回标准 HTTP429状态码并携带Retry-After响应头,绝不无限期挂起连接,也绝不自作主张把您的 M3 请求转给其他模型,把重试、排队或切换备选模型的决策权 100% 交还给您的业务代码。
提示:如果您在生产迁移中需要特定版本或尚未在列表中的开源权重模型,可直接发送型号与预计用量至 [email protected],我们的算力团队评估后会快速回复排期。
三、从 M2.x 到 M3 系列:三步完成 OpenAI 兼容代码割接
NexAIX 严格按 OpenAI Chat Completions 规范实现接口,完整支持流式输出(Streaming)、函数/工具调用(Function/Tool Calling)以及多轮对话。关于跨版本接口改造的通用原则,您可以参考《换大模型 API 要改哪些代码:三处必改配置,加四类参数兼容检查》。
下面以 Python openai SDK 为例,演示如何将原有的 M2.x 调用平滑升级并支持多模态与工具调用。
1. 核对模型详情页与 URL 规范
在修改配置前,请先访问 https://nexaix.net/models/ 确认目标模型的准确 model 标识符与参数规格。需要注意站内模型页的 URL 拼接规则:模型详情页路径 https://nexaix.net/models/{slug}/ 会将模型 ID 中的英文句点(.)替换为横线(-),但在 API 请求体中传入的 model 字段仍须保持模型页标注的原始模型 ID。
2. 替换端点与多模态/工具调用实战代码
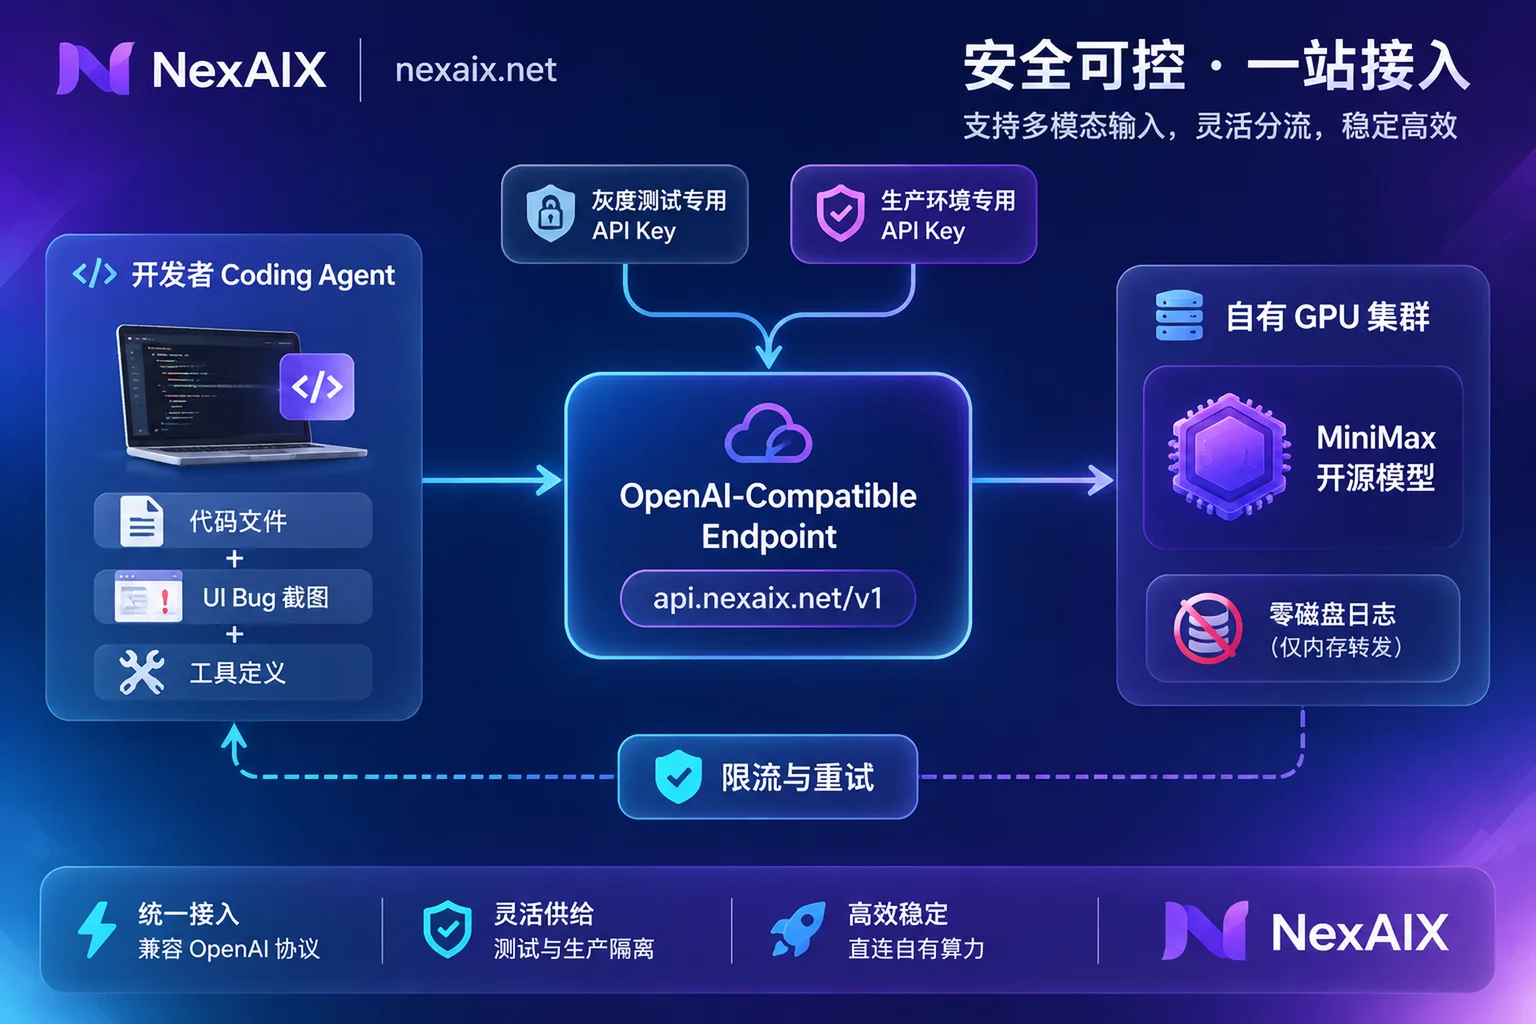
已在用 OpenAI SDK 的项目,只需将 base_url 指向 https://api.nexaix.net/v1 并换上从 NexAIX 控制台 获取的 API Key(詳见 三步零侵入接入指南)。
当迁移到支持视觉理解的 MiniMax 模型时,图像可直接按 OpenAI 多模态标准格式传入 image_url 或 Base64 编码,视频则可按抽帧后的图像序列传入:
import os
from openai import OpenAI

# 1. 统一使用 OpenAI 兼容端点,一把 Key 调用平台全部已开通模型
client = OpenAI(
    api_key=os.environ.get("NEXAIX_API_KEY"),
    base_url="https://api.nexaix.net/v1"
)

# 2. 定义 Coding Agent 的工具契约
tools = [
    {
        "type": "function",
        "function": {
            "name": "apply_code_patch",
            "description": "将生成的修复补丁应用到指定源码文件并运行单元测试",
            "parameters": {
                "type": "object",
                "properties": {
                    "file_path": {"type": "string", "description": "目标文件相对路径"},
                    "unified_diff": {"type": "string", "description": "标准 unified diff 格式补丁"}
                },
                "required": ["file_path", "unified_diff"]
            }
        }
    }
]

# 3. 发起包含报错截图(或视频抽帧序列)与长上下文代码的排障请求
# 注:具体在售 model 名称及支持模态请以 https://nexaix.net/models/ 模型页标注为准
response = client.chat.completions.create(
    model="minimax-m3",  # 请以模型页实际标注的 模型 ID 为准
    messages=[
        {
            "role": "system",
            "content": "你是一个资深全栈排障 Agent。请结合 UI 报错截图与代码上下文,直接调用工具提交修复补丁。"
        },
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "前端控制台在渲染大表格时出现白屏,附上抽帧截图与核心组件代码:"},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/debug-frames/frame_01.png"}
                }
            ]
        }
    ],
    tools=tools,
    tool_choice="auto",
    temperature=0.2,
    max_tokens=4096,
    stream=False
)

# 4. 校验实际执行的模型名并处理工具调用
print(f"实际执行模型: {response.model}")
message = response.choices[0].message
if message.tool_calls:
    for tool_call in message.tool_calls:
        print(f"触发工具: {tool_call.function.name}")
        print(f"参数载荷: {tool_call.function.arguments}")
如果您使用 LangChain、LlamaIndex、Vercel AI SDK,或是 Dify、Cherry Studio、NextChat、Cline、OneAPI 等工具链,同样只需修改自定义 OpenAI base_url 即可无缝接入。
四、生产环境灰度割接与稳定性治理清单
为了确保在 11 月 18 日停服大限前完成零故障切换,建议技术负责人在架构层落实以下四项治理措施:
1. 利用“按 Key 隔离”实现新旧模型灰度对比
在迁移验证期,切忌让线上旧业务与新模型的压测流量共用同一把 API Key。在 NexAIX 中,每把 Key 拥有独立配额、独立权限与独立用量账单(详见 零日志与密钥隔离机制)。
- 您可以为灰度环境单独创建一把 Key,专门跑 MiniMax 新模型的回归测试;
- 账单按模型分项统计,可以精确核算迁移前后的单次任务 Token 成本变化;
- 若测试环境的 Key 不慎在日志或前端配置中泄露,可随时单独吊销,绝不波及生产主链路;
- 每次调用均会返回唯一的请求 ID(Request ID),一旦在参数适配中遇到异常状态码,带着请求 ID 联系技术支持即可快速定位。
2. 执行四步“防掉包与防降配”基线核验
在将核心生产流量切入任何 API 端点前,建议按《怎么确认 API 返回的是不是原版模型:四类可复核的检查方法》以及 NexAIX 不降配自查指南 做一次完整体检:
- 核对返回体
model字段:确认响应 JSON 中的model与请求完全一致,排除静默重定向; - 固定 Prompt 与随机种子复测:检验采样参数(
temperature、top_p)是否被原样透传; - 长窗口边界压测:使用接近模型标称上限的上下文长度与
max_tokens发起测试,确认没有隐式截断(需要留意的是,超长输入的首 Token 延迟和费用会随输入长度自然上升); - 消息复述测试:让模型复述收到的全部前置消息,验证网关未在底层注入任何干扰性的隐藏系统提示词。
3. 配置显式的 429 退避与跨模型主备编排
每把 Key 均设有 RPM(每分钟请求数)、TPM(每分钟 Token 数)与并发上限(若业务大促或批量迁移需要更高配额,可随时联系申请,我们将按实际集群容量答复,详见 高吞吐与限流说明)。
关于限流阈值的精细化调优,可参阅《AI API 限流实战排查与架构治理:拆解 RPM、TPM 与在途并发的三维瓶颈》。由于 NexAIX 坚持单一供应方、单一端点的透明原则,满载时会直接返回标准 429 及 Retry-After。您可以在业务代码的重试拦截器中,利用同一把 Key、同一个端点的特性:当主模型触发限流或处于维护窗口时,只需在应用层将请求体的 model 字段显式改为同在自有集群上的 DeepSeek、GLM、Kimi、Qwen,或通过 官方授权渠道 接入的 Claude、GPT-5.6、Gemini 系列,实现完全受控的客户端容灾。
4. 落实代码资产零留存与企业合规审计
Coding Agent 与研发流水线往往涉及企业核心源码。如《AI API 隐私合规实战指南:应对 Agent 数据外泄、上游留存分歧与生产级防线构建》所强调,开源权重模型运行在 NexAIX 自有算力集群上时,Prompt 和 Completion 仅在内存中流转,请求结束立即释放,绝不落盘写盘;平台仅保留请求 ID、模型名、Token 计数、时间戳与状态码用于计费排障,从客户端到推理节点全程采用 TLS 1.3 加密,数据绝不用于训练或转交第三方(查看零日志架构详情)。
同时,NexAIX 拥有完整合规主体,支持签订正式商用合同、开具增值税发票,并可签署服务级别协议与数据处理协议(DPA);针对金融、政企等强监管场景,还可发邮件至 [email protected] 洽谈独立资源池与私有化部署方案评估。
五、结语:把模型升级主动权握在自己手里
MiniMax M2.5 与 M2.7 的退役,标志着长程 Agent 与多模态编程正式全面迈入百万上下文的 M3 代际。面对上游模型的版本更迭,与其被动承受隐式路由带来的参数失控与超时故障,不如借此机会将调用底座迁移到规格透明、算力自主、接口统一的工程架构之上。
现在即可前往 NexAIX 控制台(api.nexaix.net) 使用邮箱注册——无需繁琐的企业资质审核,注册即送测试额度。花五分钟替换 base_url 并走通一轮灰度压测,让您的 Agent 应用在 11 月 18 日停服节点前后依然稳如磐石。