 NexAIX-官方博客
在 2026 年下半年的开源大模型生态中,智谱(Z.ai)的 GLM-5.3 家族引发了现象级的工程迁移。此前以匿名代号 stealth/ox-alpha 刷屏各大聚合榜单的神秘模型揭晓真身——作为 GLM-5 系列首款原生多模态模型,GLM-5.3-Flash(320B 总参数、18B 激活参数的 MoE 架构,采用混合线性与稀疏注意力机制)凭借 1M 上下文窗口与极低的推理成本,迅速成为构建视觉 Agent、GUI 自动化与前端 UI 还原的首选基座;而同期的旗舰模型 GLM-5.3(753B 总参数、40B 激活参数)则在后训练中大幅强化了长程软件工程(Terminal Bench 3.0 等开源 SOTA)与网络安全漏洞分析能力(CyberGym 基准领先);甚至在垂直领域,还进一步衍生出了面向合同审查与跨文档校验的 GLM-5.3-FlashX-Legal。
如果您的团队此前关注过基础的模型选型与套餐规则,可以参考我们早期的《GLM API 接入与选型指南:从 GLM-5.2/5.3 百万上下文、Coding Plan 限流避坑到自有算力调用》。而当下的热点需求已经迈入了深水区:如何将 GLM-5.3-Flash 的原生多模态感知能力,与 GLM-5.3 的深度架构推理能力,无缝编排进同一个生产级 Agent 工作流中?
本文将跳过基础概念,直接从生产环境的代码与基础设施视角,拆解调用 GLM API 时的模态分工、参数迁移陷阱、第三方算力劣化问题,并给出高可靠的生产落地实践。
一、 GLM-5.3 家族的“双核”分工:别让错误的模型接管错误的模态
在早期的模型迭代中,开发者习惯于认为“Flash 版只是旗舰版的低价阉割版”。但在 GLM-5.3 系列中,这种认知会导致严重的架构设计失误。根据官方技术文档与权重架构,这两款模型在生产链路中承担着截然不同的角色:
| 维度 | GLM-5.3(旗舰深度推理) | GLM-5.3-Flash(原生多模态高性价比) |
|---|---|---|
| 模型架构 | 753B 总参数 / 40B 激活 MoE | 320B 总参数 / 18B 激活 MoE(混合线性+稀疏注意力) |
| 输入模态 | 仅支持纯文本 | 原生多模态(文本、图像、视频抽帧序列等) |
| 上下文与最大输出 | 1M 上下文 / 128K 最大输出 | 1M 上下文 / 支持长序列结构化输出 |
| 核心工程定位 | 复杂系统重构、多步 CLI 工具调用、安全审计与漏洞推理 | UI 截图转代码、图表/文档视觉解析、高频子任务执行、视频流理解 |
| 开源许可 | MIT License | MIT License |
在实际研发中,不少团队在把业务从旧版视觉模型或纯文本模型迁向 GLM-5.3 时,直接将带有图像 payload 的请求发往 glm-5.3 导致接口报错;或者反过来,用 glm-5.3-flash 去硬扛极度复杂的跨模块后端架构重构。正确的做法是构建“多模态感知 + 深度规划”的双层路由架构。
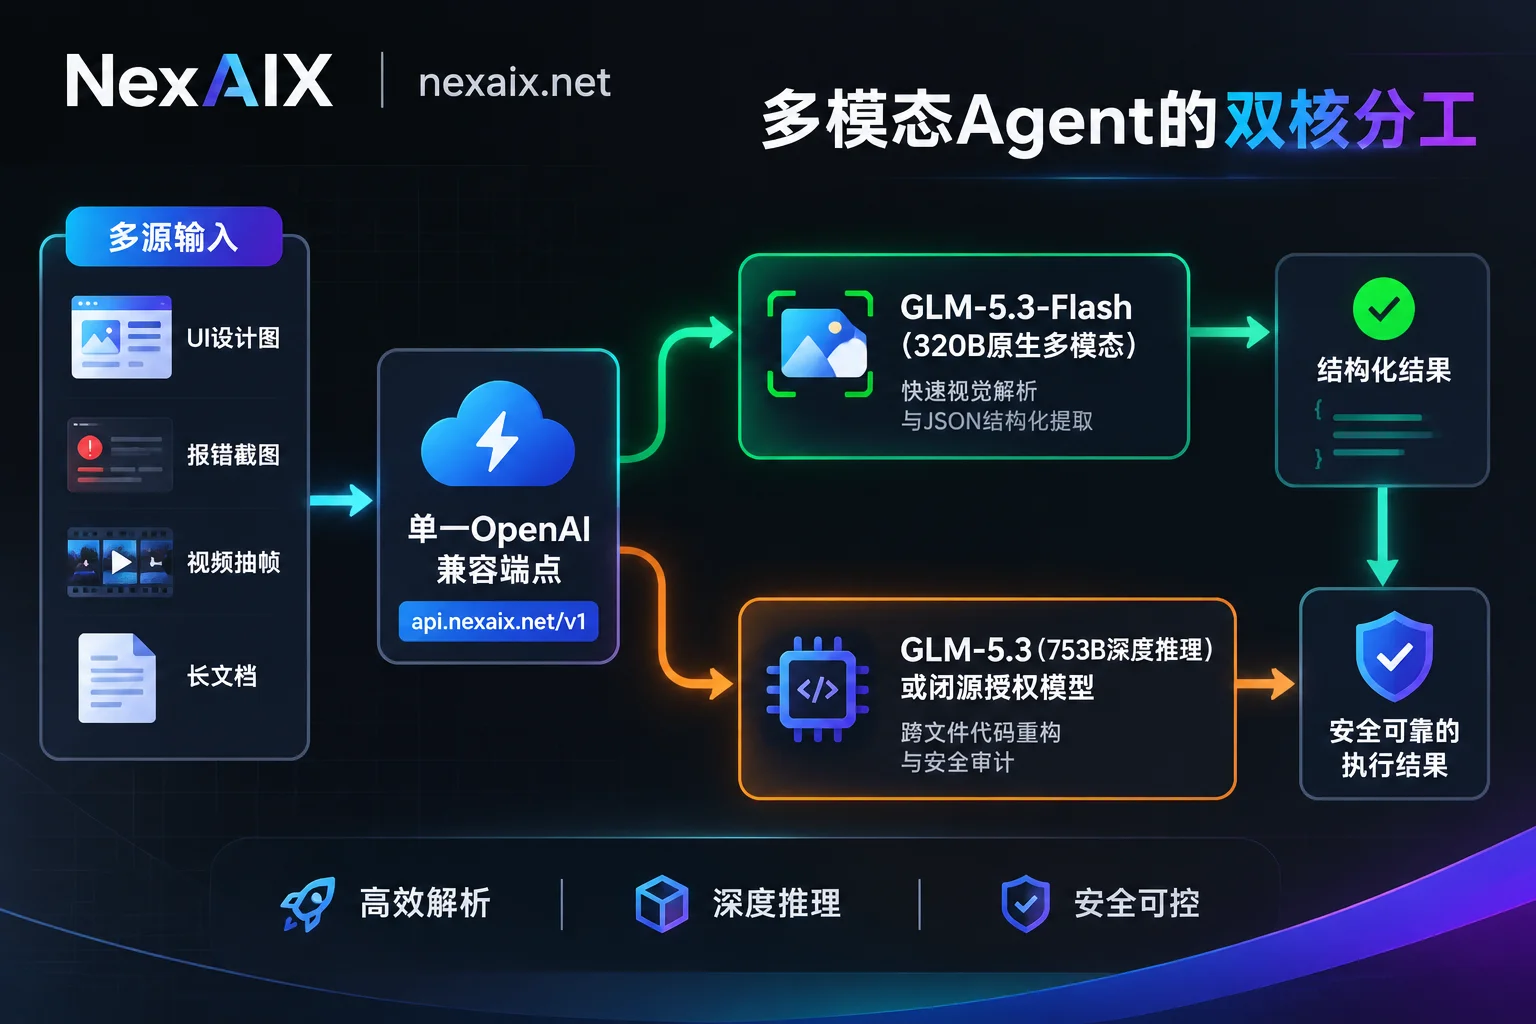
如上图所示,在一个典型的全栈研发或自动化运维 Agent 中:
- 感知与高频执行层(GLM-5.3-Flash):负责接收前端报错截图、Figma 设计稿或监控视频抽帧序列,结合
tools定义快速提取结构化 DOM 树或异常指标。 - 核心规划与重构层(GLM-5.3 / 闭源旗舰):接收感知层提炼后的纯文本上下文与代码库索引,开启深度思考进行跨文件架构修改与安全边界校验。
二、 生产环境接 GLM API 的三大工程暗礁
当您决定将上述架构推向生产环境时,直接对接散乱的上游渠道或廉价聚合平台,往往会撞上以下三个棘手的技术痛点:
1. 强制思考机制与迁移参数报错(400 Bad Request)
从 GLM-4.x 或早期 GLM-5 版本升级到 glm-5.3 与 glm-5.3-flash 时,最常见的线上故障是参数校验失败。在 GLM-5.3 中,深度思考能力(Thinking)被设计为常驻开启,不再支持手动关闭。
如果您的历史代码中保留了 thinking: {"type": "disabled"} 的配置,请求切换模型 ID 后会直接失败。针对轻量级任务,正确的做法是将思考模式保持为开启,并将推理强度参数 reasoning_effort 显式调低为 low(复杂编码任务则使用 high 或 max)。此外,在多轮工具调用(Function Calling)中,必须确保接口层不篡改、不丢弃模型原生的思考与工具调用字段。
2. 第三方转售商的“精度缩水”与隐式路由掉包
由于 GLM-5.3 与 GLM-5.3-Flash 均采用 MIT 协议开源了权重,目前海外与国内聚合平台上托管这两款模型的供应商已超过 30 家。然而,753B 和 320B 的 MoE 模型对显存带宽与多机互联有着极高的要求。
部分低价 API 渠道为了压低单卡成本,会在后台采取以下暗箱操作:
- 激进量化劣化:将官方推荐的高精度权重私自压制为低比特量化版本,导致模型在百万上下文检索(NIAH)和输出复杂 JSON Schema 时频繁出现语法崩坏(关于精度差异的底层逻辑,详见《模型推理精度 BF16 和 FP8 有什么区别:显存、速度、质量与选型》)。
- 隐式模型降级:在算力满载或高峰期,将原本请求
glm-5.3的流量静默转发给成本仅为十分之一的glm-5.3-flash甚至更早期的轻量模型,导致长程 Agent 任务在中途莫名“失智”。
3. 个人订阅包(Coding Plan)与多端协议割裂
很多开发者最初是在 Cline、Claude Code 或 OpenCode 等工具里通过个人订阅套餐体验 GLM-5.3 的。但正如我们在之前关于限流排查与架构治理的探讨中指出的,个人套餐受制于 5 小时动态刷新池、周限额以及高峰期积分加倍扣除规则,且在协议支持上存在诸多限制,根本无法承载企业生产系统的高并发、无状态 API 调用。
同时,各家云厂商对模型 ID 的命名五花八门(如 z-ai/glm-5.3、zai-org/GLM-5.3-Flash 等),多平台切换时不仅要维护多套 Base URL 和账单,还要反复修改代码中的硬编码标识。
三、 为什么生产团队选择在 NexAIX 调用 GLM API?
针对上述痛点,NexAIX(nexaix.net) 为开发者与企业技术团队提供了一套透明、纯粹的生产级 AI API 基础设施。在接入 GLM 系列及构建多模型 Agent 时,您可以直接获得以下确定性保障:
1. 自有算力集群部署,推理精度与规格全透明
在 NexAIX 的模型列表中,包含 GLM、DeepSeek、Kimi、MiniMax、Qwen、gpt-oss 在内的开源权重模型,全部采用「自有算力部署」模式:我们将官方发布的开源权重直接部署在自建与自租机房的自有 GPU 集群上,由自有工程团队全权运维,绝不转售任何第三方的二手额度。
在每个独立的模型详情页(注意:访问单个模型页时需将模型 ID 中的点替换为横线,例如 glm-5.2 对应详情页为 https://nexaix.net/models/glm-5-2/,而 API 请求体中的 model 字段仍写标准 ID),我们都会明确标注该模型的供给方式、上下文长度、最大输出、推理精度(BF16、FP8、MXFP4 等按模型如实标注)、输入模态与开源许可。如果您需要的特定开源权重变体(如特定行业微调版)暂未在清单中列出,还可以直接发送型号与预计用量至 [email protected],我们会在评估算力后回复上线排期。
2. 承诺“不降配”,参数原样透传且支持四维自查
生产环境的 Agent 最怕底层基座成为“薛定谔的黑盒”(参见《别让“黑盒”API拖慢Agent开发:构建可审计、不降配的生产级Agent底层》)。NexAIX 严格执行不降配承诺:
- 返回体中的
model字段严格对应实际执行推理的模型; - 不换小模型、不降精度、不截断上下文和最大输出、不注入任何隐藏系统提示词;
temperature、top_p、max_tokens等核心控制参数原样透传。- 您随时可以通过固定 prompt 与随机种子复测、核对返回
model字段、接近上限长度压测、让模型复述收到的全部消息这四种方法进行独立核验。
3. 单一 OpenAI 兼容端点,开源与闭源模型无缝协同
NexAIX 严格按照 OpenAI Chat Completions 规范实现接口(详见一行接入说明),完整支持流式输出(Streaming)、函数/工具调用(Function Calling)以及多轮对话。
更重要的是,一把 API Key 即可访问平台全部已开通模型。无论是运行在自有算力集群上的 GLM、Kimi、DeepSeek 等开源模型,还是通过厂商官方商用授权渠道接入的 Claude、GPT-5.6、Grok、Gemini 等闭源模型(有正规合同、发票、可审计,绝不用号池或逆向客户端协议),接口格式完全一致。您在代码中切换模型,只需修改 model 字段的字符串。
四、 实战代码:基于单一端点实现“视觉解析 + 深度重构”工作流
下面我们通过一段标准的 Python 代码示例,展示如何使用官方 openai SDK 接入 NexAIX,先用支持多模态的 GLM 模型解析架构/UI 图像(视频场景同样支持,按抽帧后的图像序列传入即可),再将结果无缝交由深度推理模型生成修复方案。
只需将 base_url 指向 https://api.nexaix.net/v1,并换上您在控制台获取的 API Key(具体模型 ID 与支持模态请以官网模型广场实时标注为准):
import os
from openai import OpenAI

# 1. 初始化客户端:仅需修改 base_url 和 api_key
client = OpenAI(
    api_key=os.getenv("NEXAIX_API_KEY"),
    base_url="https://api.nexaix.net/v1"
)

def multimodal_agent_workflow(image_base64: str, repo_context: str):
    # 阶段一:调用多模态模型(如 glm-5.3-flash)解析前端报错截图或架构图
    print("[Step 1] 正在通过多模态模型解析视觉输入...")
    vision_response = client.chat.completions.create(
        model="glm-5.3-flash",  # 实际可用模型ID请以 https://nexaix.net/models/ 为准
        messages=[
            {
                "role": "user",
                "content": [
                    {
                        "type": "text",
                        "text": "请仔细分析这张前端控制台报错与UI偏移截图,提取出具体的报错堆栈信息和样式冲突的组件名称,以精简的Markdown列表输出。"
                    },
                    {
                        "type": "image_url",
                        "image_url": {
                            "url": f"data:image/png;base64,{image_base64}"
                        }
                    }
                ]
            }
        ],
        temperature=0.2,
        max_tokens=2048
    )

    visual_diagnosis = vision_response.choices[0].message.content
    # 每次调用均返回唯一请求 ID,便于生产排障
    print(f"视觉解析完成 (Request ID: {vision_response.id})")

    # 阶段二:仅修改 model 字段,无缝切入深度推理模型(如 glm-5.3)进行代码重构
    print("[Step 2] 正在通过旗舰推理模型生成跨文件修复补丁...")
    coding_response = client.chat.completions.create(
        model="glm-5.3",  # 无需更换 client 或端点,只改 model 字符串
        messages=[
            {
                "role": "system",
                "content": "你是一名资深全栈架构师。请根据视觉诊断结果与仓库代码上下文,输出可直接应用的 Git Diff 补丁。"
            },
            {
                "role": "user",
                "content": f"### 视觉诊断结果:\n{visual_diagnosis}\n\n### 相关仓库代码:\n{repo_context}"
            }
        ],
        temperature=0.1,
        max_tokens=8192,
        stream=True  # 生产环境长输出建议开启流式响应
    )

    print("\n--- 修复方案输出 ---")
    for chunk in coding_response:
        if chunk.choices and chunk.choices[0].delta.content:
            print(chunk.choices[0].delta.content, end="", flush=True)
如果您在团队内部使用 LangChain、LlamaIndex、Vercel AI SDK 进行编排,或者在 Dify、Cherry Studio、NextChat、Cline、OneAPI 等客户端工具中配置,同样只需填入上述 base_url 与 Key 即可即刻跑通(配置细节可参考《LangChain 怎么改自定义 base_url》与《One API 怎么添加 OpenAI 兼容渠道》)。
五、 企业级生产的隐私、流控与账单治理
将 GLM API 纳入企业核心研发流水线或面向客户的业务系统时,除了模型本身的效果,技术负责人往往更关心安全性与高可用治理。NexAIX 在底层架构上为此做好了完备的工程设计:
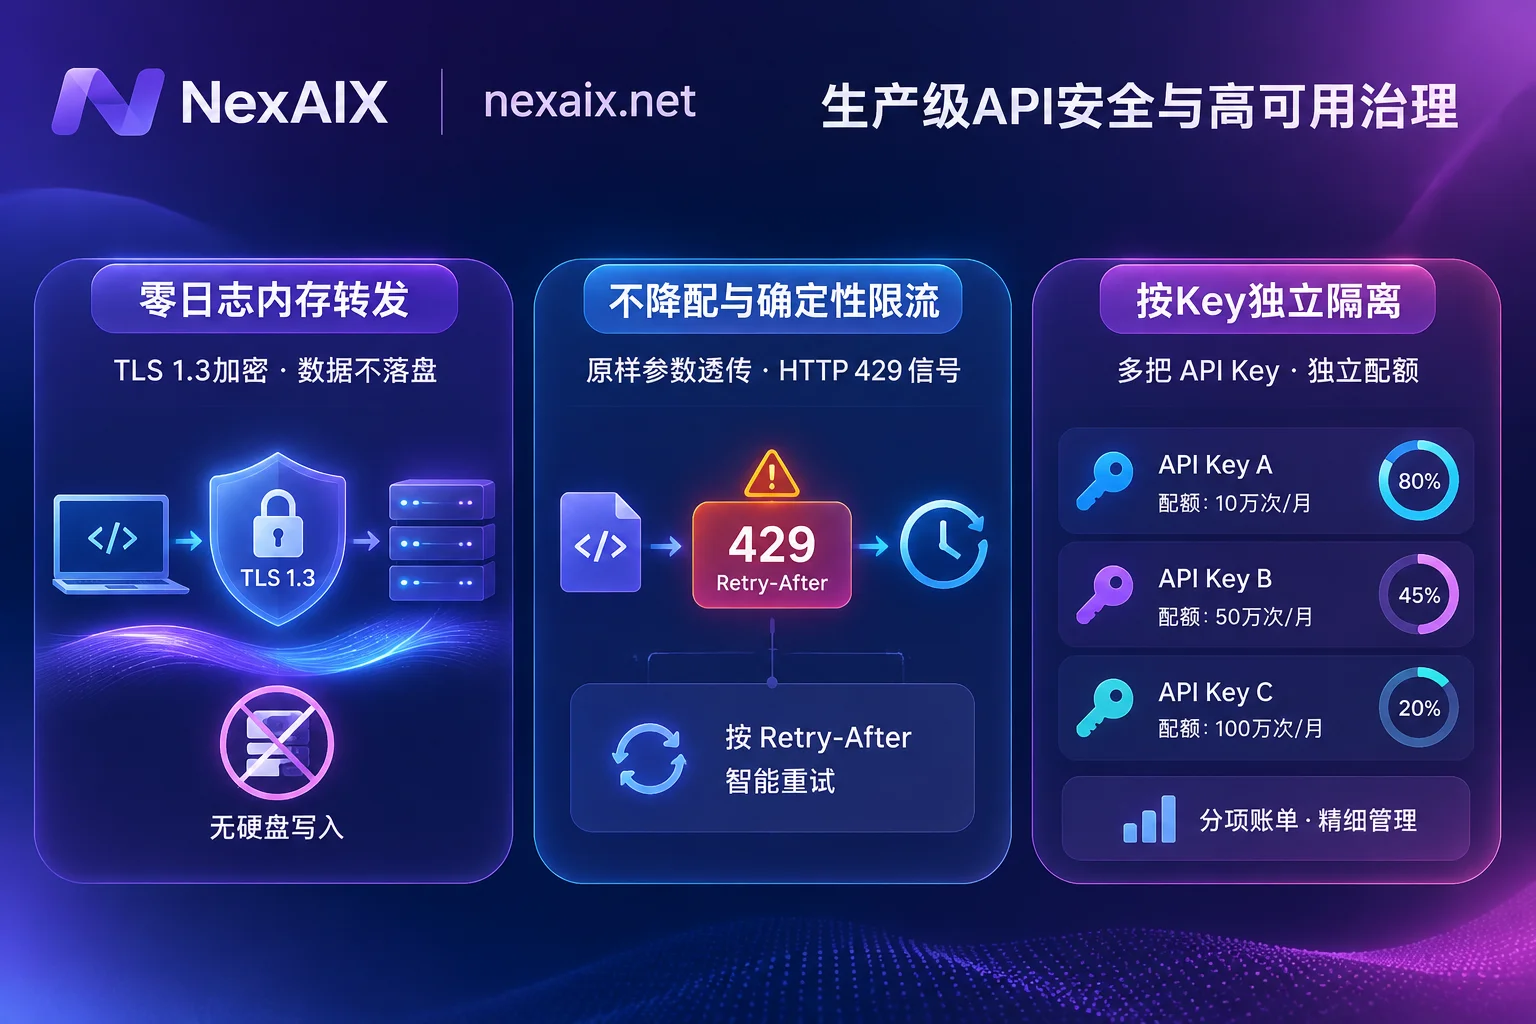
1. 零日志内存转发,拒绝数据留存隐患
代码仓库与业务截图往往包含核心商业机密。在 NexAIX 平台侧,我们严格实行不记录对话策略:
- 您的
prompt和completion仅在内存中完成转发,请求结束即刻释放,绝不落盘写盘; - 平台仅保留用于账单核算与排障的元数据(请求 ID、模型名、token 计数、时间戳、状态码);
- 绝不将用户数据用于训练,也不转交给任何做训练的第三方;从客户端到推理节点全程采用 TLS 1.3 加密传输。
- 注:对于运行在 NexAIX 自有算力集群上的 GLM 等开源模型,数据生命周期完全在我们的零日志内存闭环内结束;若您同时调用了闭源模型,请求到达上游厂商后的数据留存则按各厂商官方条款处理(目前官网在 Claude Opus 5 页面标注了支持零数据保留,Fable 5 标注了 30 天留存)。
2. 确定性的 429 限流契约,拒绝“死等”与暗中替换
在百万上下文压测或突发流量洪峰下(注意:超长输入的首 token 延迟和费用会随输入长度自然上升),最致命的不是报错,而是上游接口无限期挂起(Hang)拖垮整个调用链线程池。在 NexAIX 的高吞吐与限流机制下:
- 每把 Key 设有清晰的 RPM、TPM 和并发上限(若业务增长需要更高配额,可随时联系我们按实际集群容量评估上调);
- 当遇到算力满载时,接口会立即返回标准的 HTTP 429 状态码并附带
Retry-After响应头,绝不无限期挂起连接,也绝不会自作主张把请求偷换为更便宜的模型。 - 因为 NexAIX 坚持单一供应方、单一端点的确定性交付,不搞黑盒自动路由,您可以基于明确的 429 信号在业务代码层自主决定是指数退避重试、进入消息队列,还是显式降级切换到备用模型。
3. 按 Key 隔离与合规商务支持
在多团队或多 Agent 协作场景下,NexAIX 支持创建多把 API Key:每把 Key 拥有独立配额、独立权限与按模型分项的独立用量账单。一旦某把用于前端测试的 Key 意外泄露,可单独吊销而不影响生产主干;线上出现任何异常,只需带着每次调用返回的 Request ID 联系技术支持即可快速定位。
在商务合规层面,NexAIX 拥有正规企业主体,支持签订正式合同、开具增值税发票、签署 SLA 服务协议与数据处理协议(DPA)。对于有严苛物理隔离或内网合规要求的金融、政企团队,也可以直接发信至 [email protected] 洽谈独立资源池或私有化部署方案。
结语:立即开启生产级 GLM API 体验
无论是利用 GLM-5.3-Flash 构建看图写代码、GUI 自动化的多模态智能体,还是借助 GLM-5.3 攻克百万 Token 级别的长程软件工程重构,稳定、透明、不降配的算力底座都是决定 Agent 能否走出 Demo、真正在生产环境产生商业价值的分水岭。
现在,您无需准备繁琐的企业资质,只需使用邮箱前往 NexAIX 控制台(api.nexaix.net) 即可免费注册,注册即送测试额度。花三分钟时间获取 API Key 并替换一行 base_url,即可在自有 GPU 算力集群上体验原汁原味的前沿大模型能力。