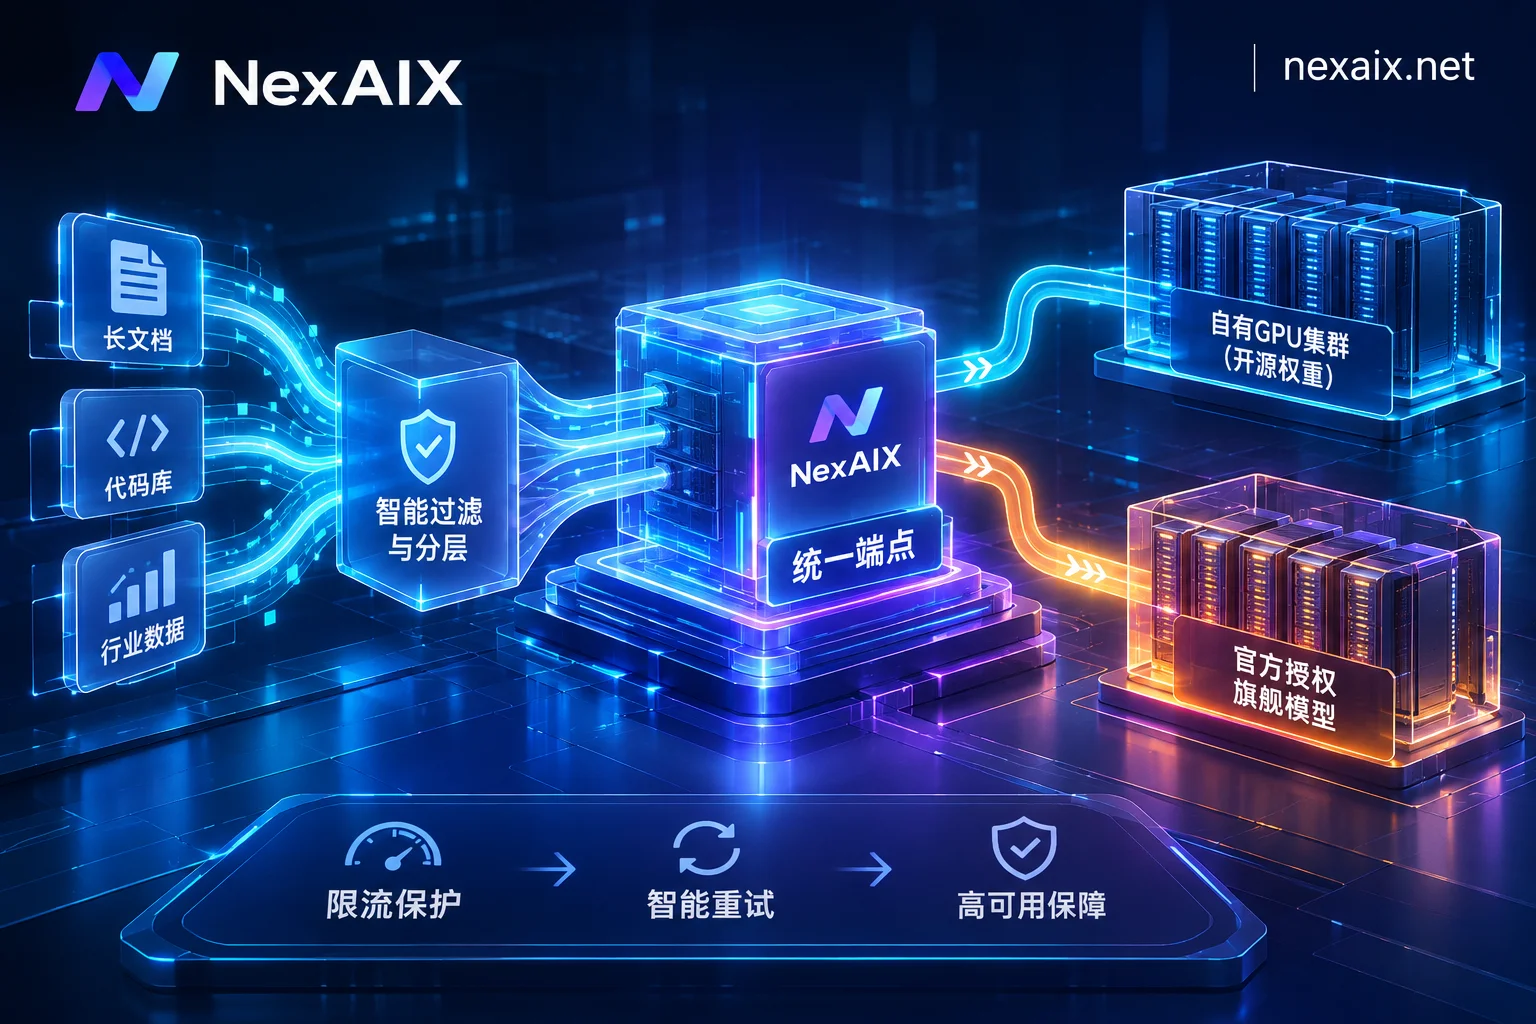
 NexAIX-官方博客
2026 年 11 月初,随着月之暗面(Moonshot AI)如期在 Hugging Face 公开 Kimi K3.1 Pro 的完整开放权重,以及多智能体(Multi-Agent)托管与协同架构在开发者社区引发新一轮热议,Kimi API 的核心应用场景已经完成了从“单次长文档问答”向“7×24 小时自主规划、跨工具调用与长程任务交付”的彻底演进。
无论是在投研工作流中并行拉取十余个数据源并生成结构化研报,还是在研发流水线中挂载终端工具进行跨文件代码重构,当前的工程团队对 Kimi 家族(从 2.8T 参数、百万级上下文的 K3 与 K3.1 Pro,到专注编码与高频调度的 K2.6、K2.7 Code)提出了更严苛的要求。如果你正在处理早期接口下线后的迁移工作,可以先参考本站此前的《Kimi API 接入与迁移指南:从 moonshot-v1 下线应对、K3 与 K2.7 选型到自有算力调用》。
而本文将完全聚焦于生产级长程 Agent 与高频工具调用(Tool Call)的深水区,拆解为什么许多团队在本地 Demo 跑通后,一旦将 Kimi API 推向生产环境,就会遭遇 JSON 结构损坏、自建显存算账亏本、海内外端点鉴权报错以及多模型账单失控等工程暗礁,并给出可验证的架构解法。
一、 为什么同一个 Kimi 模型,在不同渠道下的工具调用表现天差地别?
在长程 Agent 架构中,模型的价值不再仅仅取决于“文采好不好”,而是取决于“能不能精准讲好机器语言”。一次完整的长程任务往往包含数十轮连续的 Function Calling(函数调用),任何一轮出现参数缺失或类型错位,都会直接击穿下游业务系统的解析器。
然而,不少开发者在对比测试中发现:同样是请求 kimi-k2.6 或 kimi-k3 系列模型,有些低价 API 渠道返回的工具调用结果频频翻车。这也是为什么官方专门开源了 K2-Vendor-Verifier(KVV)供应商验证项目,用来评测不同 API 服务商在 Tool Call 场景下的真实精度。
结合评测反馈与生产排障经验,第三方劣质渠道导致 Kimi 工具调用崩溃的根源主要集中在以下三点:
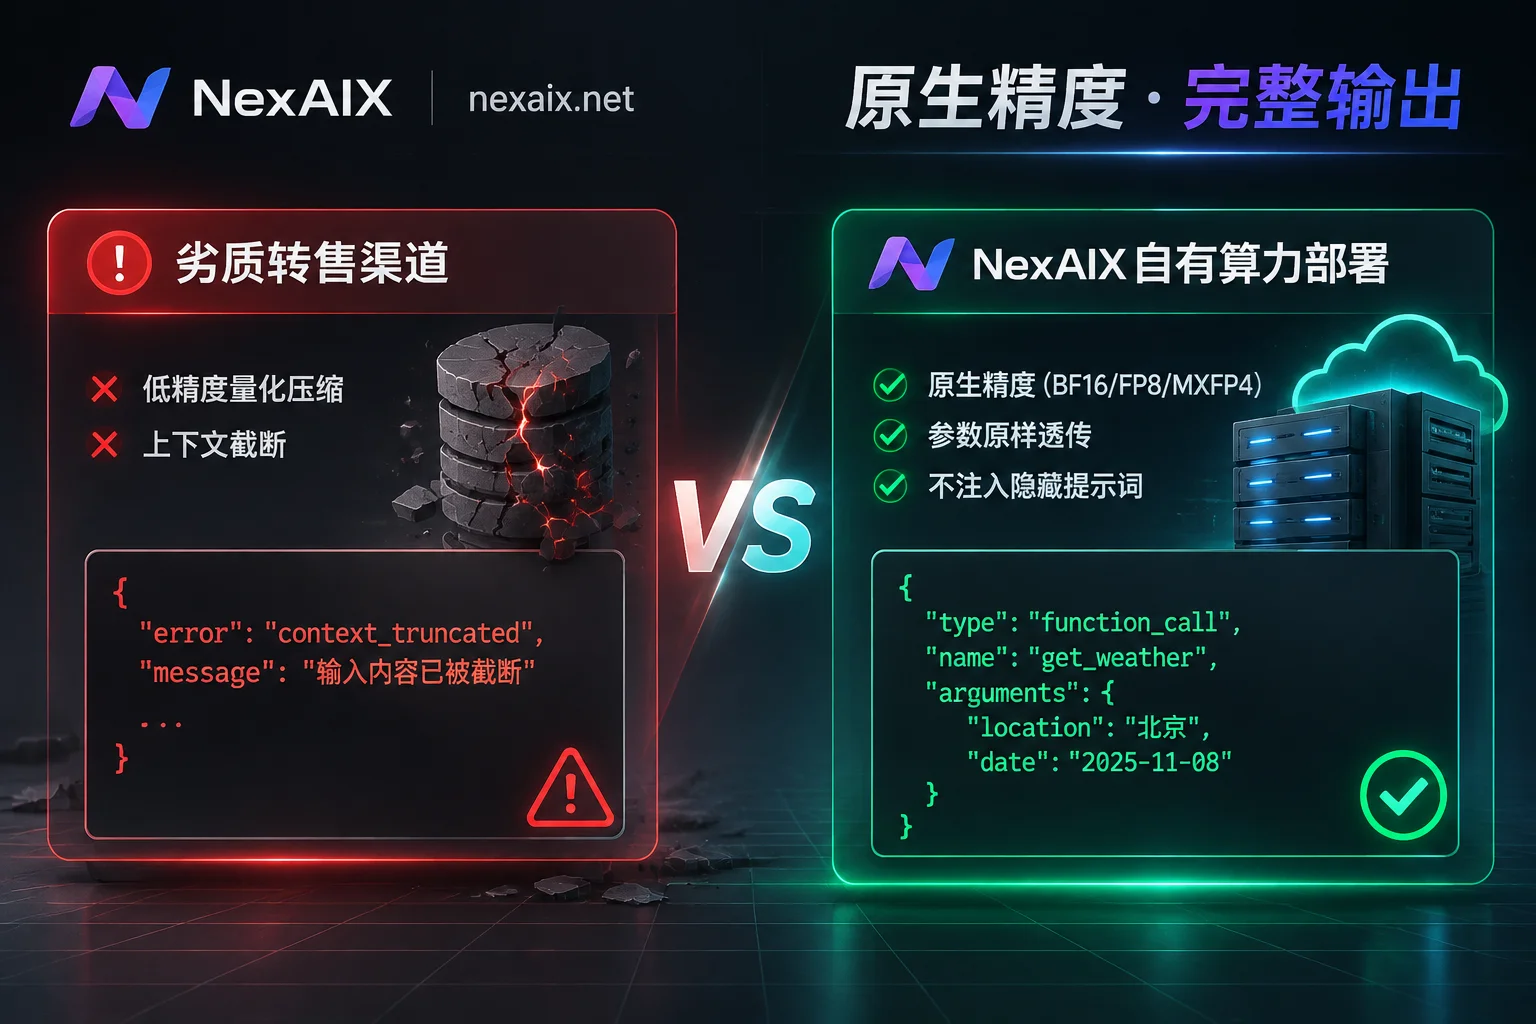
- 粗暴的低精度量化与蒸馏掉包:开源权重模型在官方发布时有明确的原生精度标准(例如 Kimi K3.1 Pro 采用量化感知训练的 MXFP4 权重 + MXFP8 激活,而部分模型标准为 BF16 或 FP8)。部分转售渠道为了在单台机器上塞进更多并发,私自将模型压缩为非标准的低比特量化版本,甚至混入小尺寸蒸馏模型。这种算力层面的“缩水”在普通闲聊中不易察觉,但在复杂的多工具选择中会导致决策边界模糊(在闲聊时胡乱触发 API,或在明确指令下漏调工具)以及 JSON Schema 约束失效。
- 隐藏提示词注入与上下文暗截:长程 Agent 依赖完整的推理链条(包括思考过程与历史工具返回结果)来维持多步规划的一致性。部分黑盒中转站为了节省显存开销,会在网关层静默截断超长历史消息,或强行注入全局 System Prompt,直接破坏了模型内部对工具状态的追踪。
- 后处理解析器篡改参数:非标准网关在转发请求时,往往会吞掉或覆写开发者传入的
temperature、top_p与max_tokens参数,导致原本需要高确定性的代码与结构化生成出现不可控的随机发散。
生产级解法:自有算力部署与“不降配”透明契约
要让 Kimi 系列模型在工具调用中交出稳定的生产级表现,底层算力必须拒绝任何形式的“黑盒魔改”(关于 Agent 底层的可审计性,可延伸阅读《别让“黑盒”API拖慢Agent开发:构建可审计、不降配的生产级Agent底层》)。
在 NexAIX 模型广场 中,包括 Kimi 系列在内的所有开源权重模型均采用自有算力部署:
- 自建与自租机房集群直供:我们将官方发布的开源权重直接部署在自有 GPU 集群上,由自有工程团队直接运维,绝不转售不可控的第三方二手额度。每个模型详情页(格式为
https://nexaix.net/models/{slug}/,注意 URL 中的 slug 需将模型 ID 里的点替换为横线)均明确标注该模型的供给方式、上下文长度、最大输出、推理精度(如 BF16、FP8、MXFP4 等,严格按模型标注)及开源许可。若你有清单以外的特定开源权重模型(如最新发布的特定快照版本)接入需求,也可直接注明型号与预计用量发送邮件至 [email protected],我们会评估算力后回复排期。 - 严格执行不降配承诺:响应体中返回的
model字段严格对应实际执行推理的模型;不换小模型、不降精度、不截断上下文和最大输出、不注入任何隐藏系统提示词,且请求中的temperature、top_p、max_tokens原样透传。
开发者随时可以使用我们在不降配说明页公开的四种方法进行线上自查:
- 固定 Prompt 与随机种子(Seed)进行跨批次复测比对;
- 核对响应体中的
model字段与实际能力特征; - 构造接近模型标称上限的超长上下文进行针海压测(NIAH);
- 直接下发指令让模型完整复述其收到的全部系统与用户消息,检验是否存在隐藏注入。
二、 1.56TB 权重的自部署算账:自建 GPU 集群还是调用自有算力 API?
每当 Kimi 发布新一代开放权重(如近期公开的 Kimi K3.1 Pro),许多技术负责人都会面临来自管理层或财务部门的灵魂提问:“既然权重已经免费开源,内部商用也没有许可证障碍,我们为什么还要按 Token 付 API 账单,而不是自己租 GPU 部署?”
正如近期海外云成本分析机构(如 CloudZero 与 Spheron)在 2026 年开源模型成本报告中所指出的:“免费权重(Free weights)”往往是软件工程里最昂贵的免费。
以刚刚公开的 Kimi K3.1 Pro 为例,我们可以算一笔真实的硬件与运维硬账:
- 存储与显存硬门槛:仅基础权重文件就包含 96 个
safetensors分片,磁盘占用高达 1.56 TB。即便采用原生的 MXFP4 权重 + MXFP8 激活格式,要完整加载权重并为百万级长上下文预留充足的 KV Cache 显存空间,单机根本无法容纳,必须直接上多机多卡(如高性能 H200 或 B200 节点)配合高速 InfiniBand 互联架构。 - 闲置算力损耗(Idle Cost):自建或长租 GPU 集群是按“卡时”计费的——无论凌晨三点有没有业务请求,集群每秒钟都在燃烧高昂的租赁与电力成本。行业测算表明,除非你的团队每天能维持数亿乃至上百亿 Token 的极高且绝对平滑的稳态吞吐,否则自建集群为波峰预留的冗余算力,会让单次有效任务的真实分摊成本远高于按量付费的 Serverless API。
- 高昂的 AI Infra 运维尾成本:针对超大规模 MoE 架构,自己搭建推理引擎、调优 Gated 稀疏注意力算子、处理多节点通信故障,需要一支全职的底层推理工程师团队(有关多源异构与自建重负的拆解,详见《多款开源大模型 API 统一接入与生产架构指南:告别多端碎片化与自建运维重负》)。
通过直接接入 NexAIX 的自有算力端点,研发团队相当于免去了 1.56TB 级多机集群的固定资产投入与运维重担,以按 Token 计费的轻量模式,直接享用满血精度的开源模型算力。
三、 跨国端点割裂与数据隐私红线:企业级落地的合规解法
在将 Kimi API 引入企业内部生产力工具、金融投研系统或代码助手时,架构师往往还会撞上另外两堵墙:连接管理碎片化与数据留存合规分歧。
1. 告别 .cn 与 .ai 的端点割裂
许多折腾过直连配置的开发者都踩过“有效 Key 返回 401 报错”的坑:直连生态中存在国内版(.cn)与国际版(.ai)两套相互独立的平台与账户体系,两边的 API Key 与请求根地址严禁混用。如果一个研发团队既有海内外的混合部署节点,又需要同时在业务流中混用 Claude、GPT-5.6、DeepSeek 或 GLM 等模型,维护多套域名、多份预充值余额与多套鉴权逻辑会迅速演变成配置灾难。
2. 核心资产的“零数据留存”诉求
在金融分析、法律合同审阅与私有代码库扫描场景中,Prompt 里包含大量未公开的财报数据、核心业务逻辑与客户隐私。第三方评测与成本追踪机构(如 Spheron 在 2026 年的对比报告)曾提醒开发者关注直连 API 条款中的默认数据使用规则与训练豁免条款问题。对于受到严格合规审计约束的企业而言,任何“对话内容可能被落盘或用于模型训练”的风险都是一票否决项。
生产级解法:零日志内存转发 + 混合模型一把 Key 调度
针对上述合规与架构痛点,NexAIX 在网关与算力层构建了清晰的隔离防线(关于渠道透明度的完整说明,请参阅供给方式与自查指南):
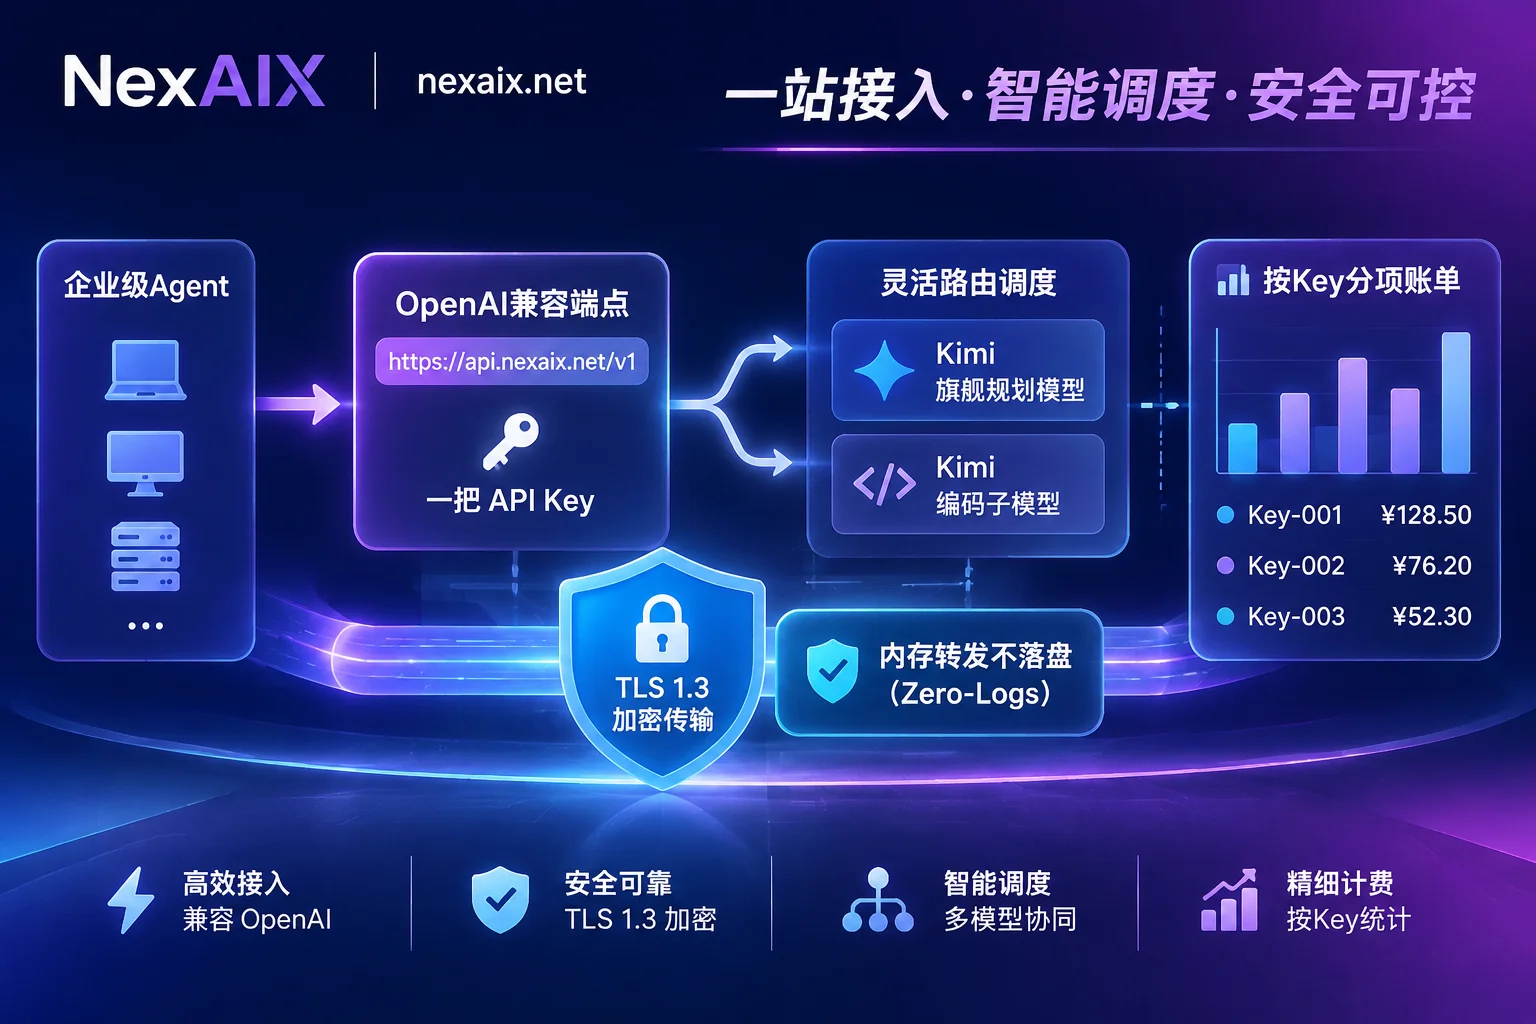
- 开源模型全链路不记录对话:在 NexAIX 这一侧,所有请求的
prompt和completion仅在内存中完成转发,请求结束即刻释放,绝不写盘;不用于任何模型训练,也不转交给做训练的第三方;从客户端到推理节点全程采用 TLS 1.3 加密传输。系统仅保留用于计费与排障的元数据(请求 ID、模型名、Token 计数、时间戳、状态码)。由于 Kimi 等开源权重模型直接运行在 NexAIX 的自有 GPU 集群上,没有外部上游厂商链路,因此你的代码与文档数据在推理全生命周期内均处于严格的“内存即焚”保护之下。 - 开源与闭源同台混调,边界诚实透明:如果你的多智能体架构不仅需要 Kimi 处理长文档,还需要联动闭源旗舰模型(如 Claude、GPT-5.6、Grok、Gemini 系列),NexAIX 同样通过官方授权渠道提供接入(签有正规商用合同、有发票、可审计,绝不用个人号池或逆向客户端协议)。对于闭源模型,我们也诚实告知边界:本站侧同样不落盘,但请求到达上游厂商后按各厂商条款处理(目前官网中仅 Claude 的两个模型页单独标注了上游留存:Opus 5 支持零数据保留,Fable 5 目前有 30 天留存;其余闭源模型以官网及对应厂商政策为准)。
- 企业级商务与私有化支撑:NexAIX 具备完整实体主体,支持签订正式服务协议、数据处理协议(DPA)并开具增值税发票;针对有极端物理隔离合规要求的场景,还可以直接联系 [email protected] 洽谈独立资源池或私有化部署方案评估。
四、 生产级长程 Agent 架构实战:三步接入、分层控费与 429 韧性治理
在多智能体协同(如“主控规划 Agent + 多个垂直执行子 Agent”)场景中,如果所有步骤一刀切地全部调用最昂贵的万亿参数旗舰模型,Token 账单会呈指数级膨胀。更合理的生产实践是同家族/跨家族混合分层调度:
- 主控规划与百万字材料通读:交由具备超大上下文与深层推理能力的旗舰型号(如 Kimi K3 系列)负责全局任务拆解与最终质检;
- 高频代码修补与子任务执行:分发给响应极快、单价更具性价比的编码或轻量专精型号(如 K2.7 Code、K2.6 或 GLM、DeepSeek 系列)。
借助 NexAIX 的 OpenAI 兼容接入标准,你不需要为不同模型引入多套 SDK,只需一个端点、一把 Key,通过动态修改请求中的 model 字段即可实现丝滑路由。
1. 零改造成本接入代码示例(Python)
无论你使用的是原生 OpenAI SDK,还是 LangChain、LlamaIndex、Vercel AI SDK、Dify、Cherry Studio、Cline、NextChat、OneAPI 等主流框架与客户端,只需将 base_url 指向 https://api.nexaix.net/v1 并换上在 NexAIX 控制台 获取的 API Key(邮箱注册即送测试额度,无需企业资质):
import os
import json
from openai import OpenAI

# 1. 统一使用 OpenAI 兼容端点,一把 Key 调度全平台开源与闭源模型
client = OpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key=os.environ.get("NEXAIX_API_KEY")
)

# 定义提供给 Kimi Agent 的工具契约 (Function Calling)
tools = [
    {
        "type": "function",
        "function": {
            "name": "query_financial_filing",
            "description": "检索指定上市公司的财报核心指标与原文段落",
            "parameters": {
                "type": "object",
                "properties": {
                    "ticker": {"type": "string", "description": "股票代码,如 AAPL 或 00700.HK"},
                    "metric": {"type": "string", "description": "财务指标名称,如 自由现金流、研发费用"},
                    "year": {"type": "integer", "description": "财报年份"}
                },
                "required": ["ticker", "metric", "year"]
            }
        }
    }
]

def run_agent_step(messages, model_id):
    """
    执行单步 Agent 推理,支持传入不同 model_id 实现主从模型分层调度
    注意:具体在售的 model_id 请以 https://nexaix.net/models/ 实时列表为准
    """
    response = client.chat.completions.create(
        model=model_id,
        messages=messages,
        tools=tools,
        tool_choice="auto",
        temperature=0.1,  # 原样透传,确保工具调用 JSON 参数的高确定性
        max_tokens=4096
    )

    # 验证不降配:返回的 model 字段即为实际执行的模型
    print(f"[Audit] 实际执行模型: {response.model} | 请求ID: {response.id}")
return response.choices[0].message路由排障小贴士:在查阅 NexAIX 模型列表 时,请注意区分网页 URL 的 slug 与代码里的model参数。单个模型介绍页的网址会把模型 ID 里的英文句点(.)替换成短横线(-),例如访问https://nexaix.net/models/glm-5-2/查看文档与三步接入代码(直接拼写/models/glm-5.2/会返回 404),但在上方 Python 代码的model字段中,仍应按页面标注的真实模型 ID 填写。
2. 高并发限流(429)与长输入延迟的确定性治理
当多智能体工作流并行扇出(Fan-out)数十个子任务时,极易瞬间打满单把 Key 的 RPM(每分钟请求数)、TPM(每分钟 Token 数)或在途并发上限(关于三维限流瓶颈的深入拆解,推荐阅读《AI API 限流实战排查与架构治理:拆解 RPM、TPM 与在途并发的三维瓶颈》)。
在生产环境中,最致命的不是报错,而是“静默挂起”或“暗中降级”。NexAIX 的高吞吐与限流策略坚持确定性工程原则:
- 拒绝假死与偷换模型:当请求触发配额上限或算力满载时,网关会立即返回标准的 HTTP
429 Too Many Requests状态码,并在响应头中附带明确的Retry-After等待时间建议;绝不无限期挂起连接拖垮你的工作线程池,也绝不会为了掩盖满载而在后台偷偷把请求切给更便宜的小模型(本站采用单一供应方、单一端点架构,不做隐式自动故障转移,由业务侧完全掌控退避重试或切流逻辑)。 - 超长输入与流式保活:在向 Kimi 投喂数十万乃至百万 Token 的超长文档时,首 Token 延迟(TTFT)和计算费用会随输入长度自然上升。建议在生产代码中全面开启流式输出(
stream=True),NexAIX 全部模型均支持标准流式返回,可有效避免客户端负载均衡器或反向代理因等待首包时间过长而主动断开 TCP 连接。 - 弹性扩容申请:如果业务迎来大促或批量跑批高峰,现有 Key 的默认配额不足,可直接联系我们申请更高配额,工程团队会按自有集群的实际容量快速评估答复。
3. 按 Key 隔离的成本核算与故障定位
在复杂的 Agent 系统中,为了搞清楚究竟是“投研摘要模块”还是“代码审查模块”消耗了大部分预算(详见《AI API 成本优化实战指南:从 Agent 多模型分层、隐性损耗排查到多 Key 账单治理》),我们强烈建议利用 NexAIX 的按 Key 隔离机制:
- 为不同的 Agent 微服务、不同的研发环境(Dev / Staging / Prod)分别创建独立的 API Key;
- 每把 Key 均拥有独立配额、独立权限与独立用量账单,且账单支持按模型分项统计,登录控制台即可随时导出用量明细;
- 一旦某个前端插件或测试环境的 Key 意外泄露,可单独将其吊销,完全不影响核心生产流水线;
- 每次 API 调用均会返回唯一的请求 ID(Request ID),线上遇到任何异常状态码时,只需携带该请求 ID 联系技术支持,即可在不触碰任何对话内容的前提下完成秒级链路排障。
结语:把底层算力交给确定性基建,把精力留给 Agent 业务逻辑
从早期的长文本阅读器,到如今由 Kimi K3.1 Pro、K3 与 K2.6/K2.7 Code 驱动的复杂多智能体协同网络,Kimi 模型家族的演进正在让更多高价值的端到端自动化交付成为现实。在这场工程化落地的竞赛中,底层的 API 基础设施不应该是那个偷偷削减量化精度、乱改工具调用参数或让团队背上沉重 GPU 运维包袱的短板。
如果你希望在生产环境中直接调用自有算力部署、原生精度不降配、内存转发零日志的 Kimi 系列模型,并实现与全球主流开源、闭源大模型的同端点混合编排,欢迎立即前往 NexAIX 控制台 使用邮箱注册账号(注册即送测试额度,无需企业资质),或在 模型广场 查阅最新在售规格,用三行配置开启高可靠的 Agent 生产之旅。