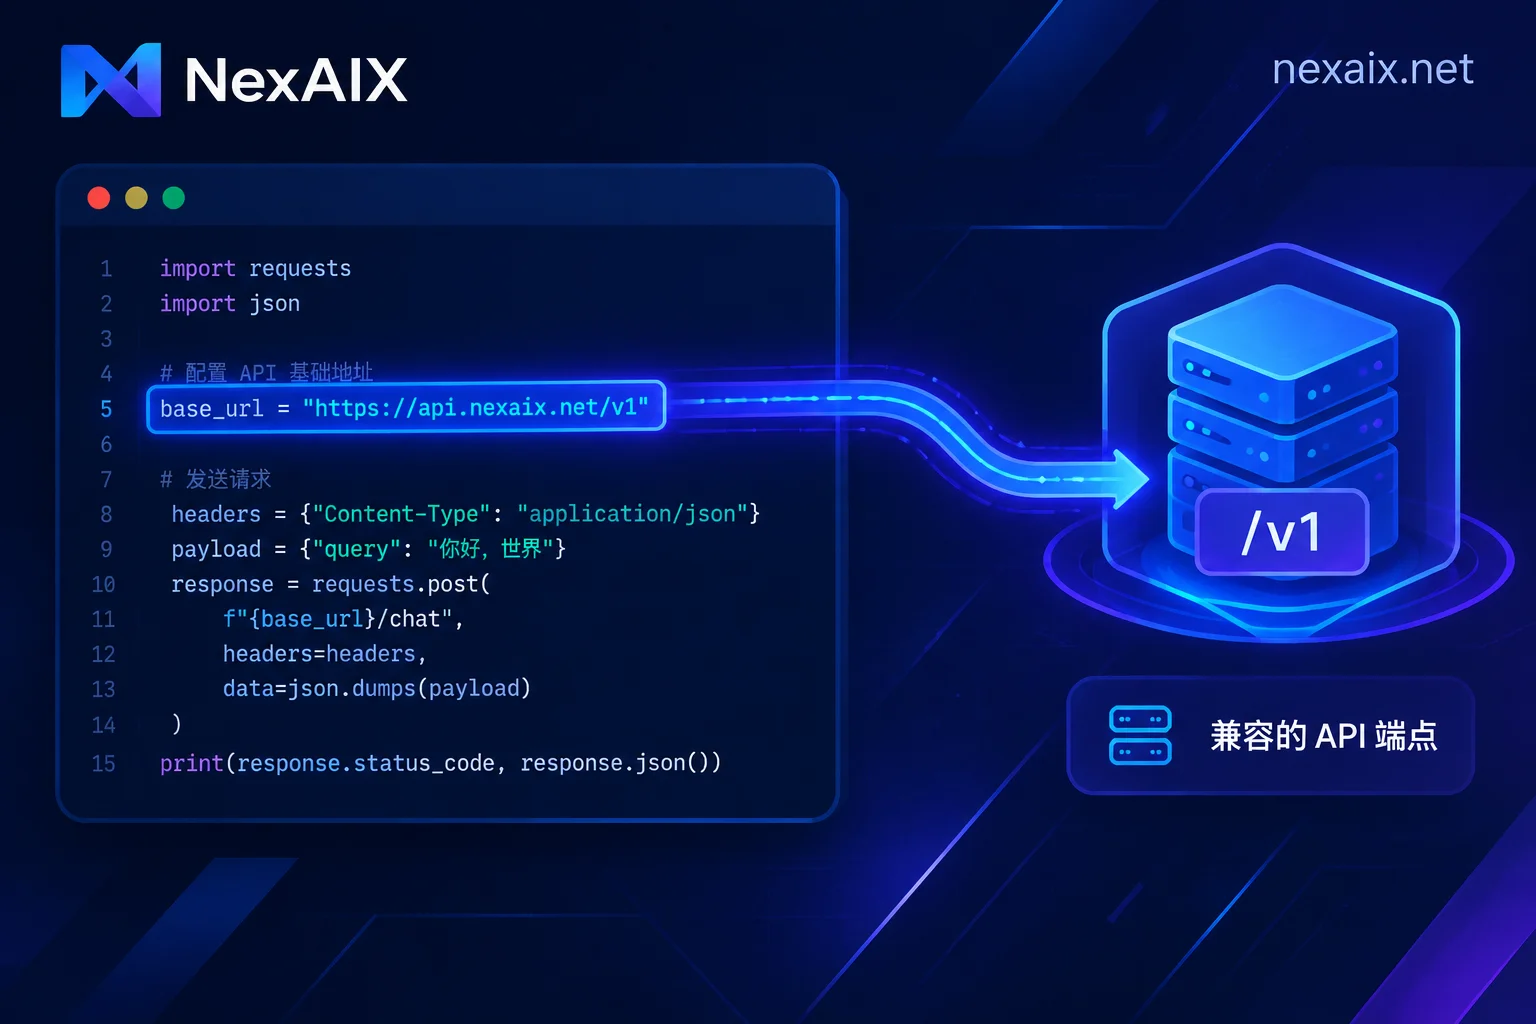
开源权重模型 API 和官方授权渠道有什么区别:精度、上下文、留存与限流怎么看

两类 API 接口格式可以一样,真正的区别在于推理由谁来跑。开源权重模型由服务方自己部署,精度、上下文和日志策略由部署方决定。闭源模型只能由原厂推理,渠道需要确认是否真的走官方,留存和限流要看原厂条款。本文按精度、上下文、数据留存、限流延迟四项拆开说明,并给出选择场景和接入前的核对步骤。

怎么验证 AI API 有没有记录对话内容:能查什么、查不到什么、怎么防

仅凭客户端,无法直接证明服务端没有把对话写入日志。本文说明哪些检查能提供有效证据:核对控制台日志字段、阅读数据留存政策、用金丝雀诱饵检测泄露、排查自己链路上的记录点,以及在出域前做脱敏。

模型推理精度 BF16 和 FP8 有什么区别:显存、速度、质量与选型

BF16 和 FP8 的区别主要在每个数值占的位数。FP8 能让权重和 KV 缓存的显存占用约减半,在支持原生 FP8 的 GPU 上还能提高吞吐;BF16 数值更稳定,适合代码、数学推导和结果对齐。本文按显存、速度、质量和硬件四项说明差异,给出自部署和 API 调用两种情况下的选择方法,以及验证模型是否降精度的步骤。

LangChain 怎么改自定义 base_url:Python、JS 写法、环境变量优先级与 404 排查

讲清 LangChain 接入 OpenAI 兼容端点时 base_url 写在哪里:Python 的 ChatOpenAI、OpenAIEmbeddings、init_chat_model,以及 JS/TS 的 configuration.baseURL;同时说明三种配置来源的优先级、/v1 路径为什么出错、流式 token 统计为何变空,以及第三方特有字段读不到的原因。
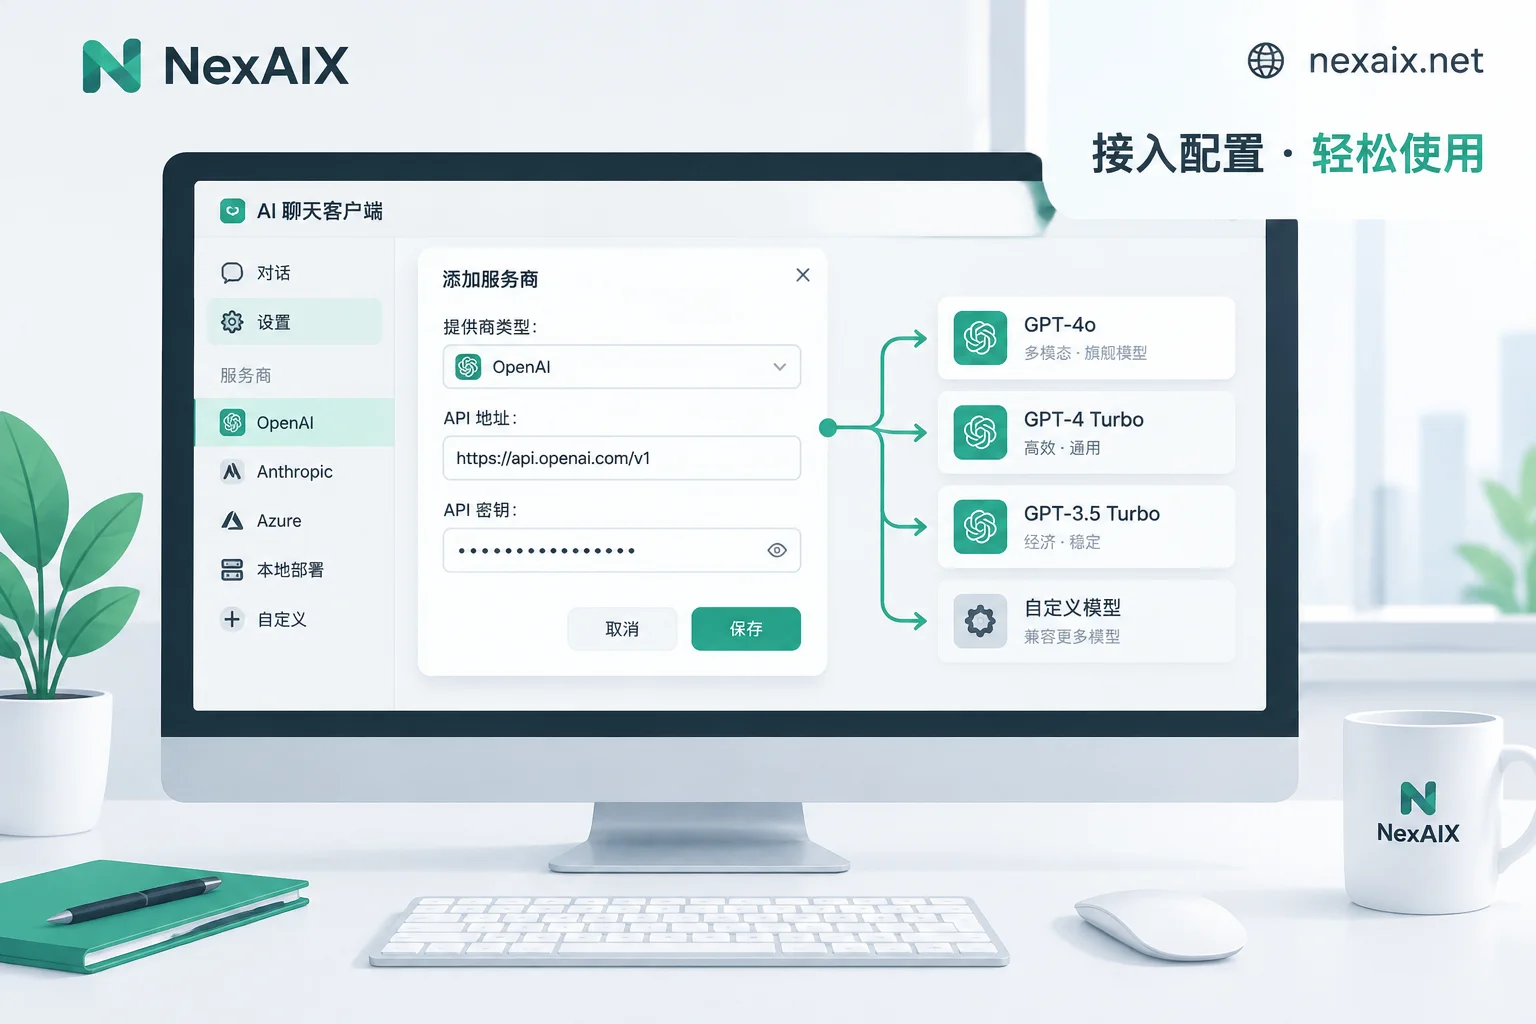
Cherry Studio 怎么添加自定义大模型:服务商、API 地址、模型 ID 与报错排查

在 Cherry Studio 中把任意 OpenAI 兼容 API 接成自定义服务商的完整步骤,包括 API 地址要不要带 /v1、模型列表拉不到时怎么手动添加、能力标签怎么勾,以及配好后发不出消息、401、404 时的排查方法。