 NexAIX-官方博客
手上如果已经有一套跑在 OpenAI 协议上的应用,换到 GPT-5.6 Terra 的代码改动量很小——改 model,改 base_url,提示词和函数定义基本不动。真正要花时间的是三件事:这个任务到底该不该用 Terra、reasoning.effort 开到哪一档、以及上线后怎么确认你拿到的确实是 Terra 而不是被悄悄换掉的小模型。
先判断:这个任务适合 Terra 吗
GPT-5.6 是 OpenAI 在 2026 年 7 月发布的一代,分 Sol、Terra、Luna 三档。Terra 在中间,官方把它定位成生产环境的主力机型:任务执行能力与上一代 GPT-5.5 相当甚至更强,但完成同一件事平均消耗的 token 明显更少,综合成本大约降到前代的一半。
按任务类型给个粗判断:
- 多步 Agent 工作流、代码生成与修改、从非结构化文本里抽结构化字段 —— 这是 Terra 的主场。这类任务对一次做对的要求高于闲聊,但又不值得每次都上旗舰模型。
- 意图分类、短问答、日志打标、批量摘要 —— 调用量大、单次难度低,Luna 那一档更合适,把 Terra 的预算留给真正需要推理的环节。
- 极难的数学证明、大规模代码库重构规划、需要最强推理链的科研型任务 —— 如果 Terra 在
high及以上档位仍然稳定出错,再考虑 Sol,而不是反过来先默认用 Sol。
三档之间的横向比较和取舍,之前写过一篇 GPT-5.6 API 怎么接:Sol、Terra、Luna 选型与推理参数配置,这里不重复。
几个会直接影响你架构设计的规格数字:
- 模型标识符
gpt-5.6-terra - 上下文窗口 1,050,000 tokens(约 1M)
- 单次请求最大输出 128,000 tokens
- 输入支持文本与图像
- 知识库截止到 2026 年 2 月 16 日
最后一条容易被忽略:涉及此后的库版本、API 变更、价格政策、人事和法规,模型不会知道,必须靠检索或工具调用注入,否则它会用截止日之前的知识自信地答错。
迁移:改动集中在两行
Terra 支持标准的 Chat Completions 协议,也支持 Responses API。从官方接口换到 NexAIX 这类 OpenAI 兼容端点,改的是客户端初始化那一段:
from openai import OpenAI

client = OpenAI(
    api_key="你的 Key",
    base_url="https://api.nexaix.net/v1",   # 改这行
)

resp = client.chat.completions.create(
    model="gpt-5.6-terra",                   # 和这行
    messages=[{"role": "user", "content": "..."}],
    stream=True,
)
Node 侧同理,new OpenAI({ baseURL, apiKey });LangChain、LlamaIndex、Cline、各类客户端一般都有对应的 base URL 配置项,填同一个地址即可。工具定义(tools / function_call)、response_format、messages 结构都不需要改写,这是兼容端点的意义所在。
选模型之前值得先确认一件事:你调用的这个模型是怎么供给的。NexAIX 只有两种方式——开源权重模型部署在自有算力集群,闭源模型走厂商官方授权渠道,每个模型页上写明属于哪一种,gpt-5.6-terra 属于后者。要看当前可用的模型清单和各自的供给方式、上下文与配额,去模型页;接入文档和获取 Key 在官网导航里。模型清单和规格会随厂商更新变动,以官网页面为准。
reasoning.effort:六档怎么选,代价是什么
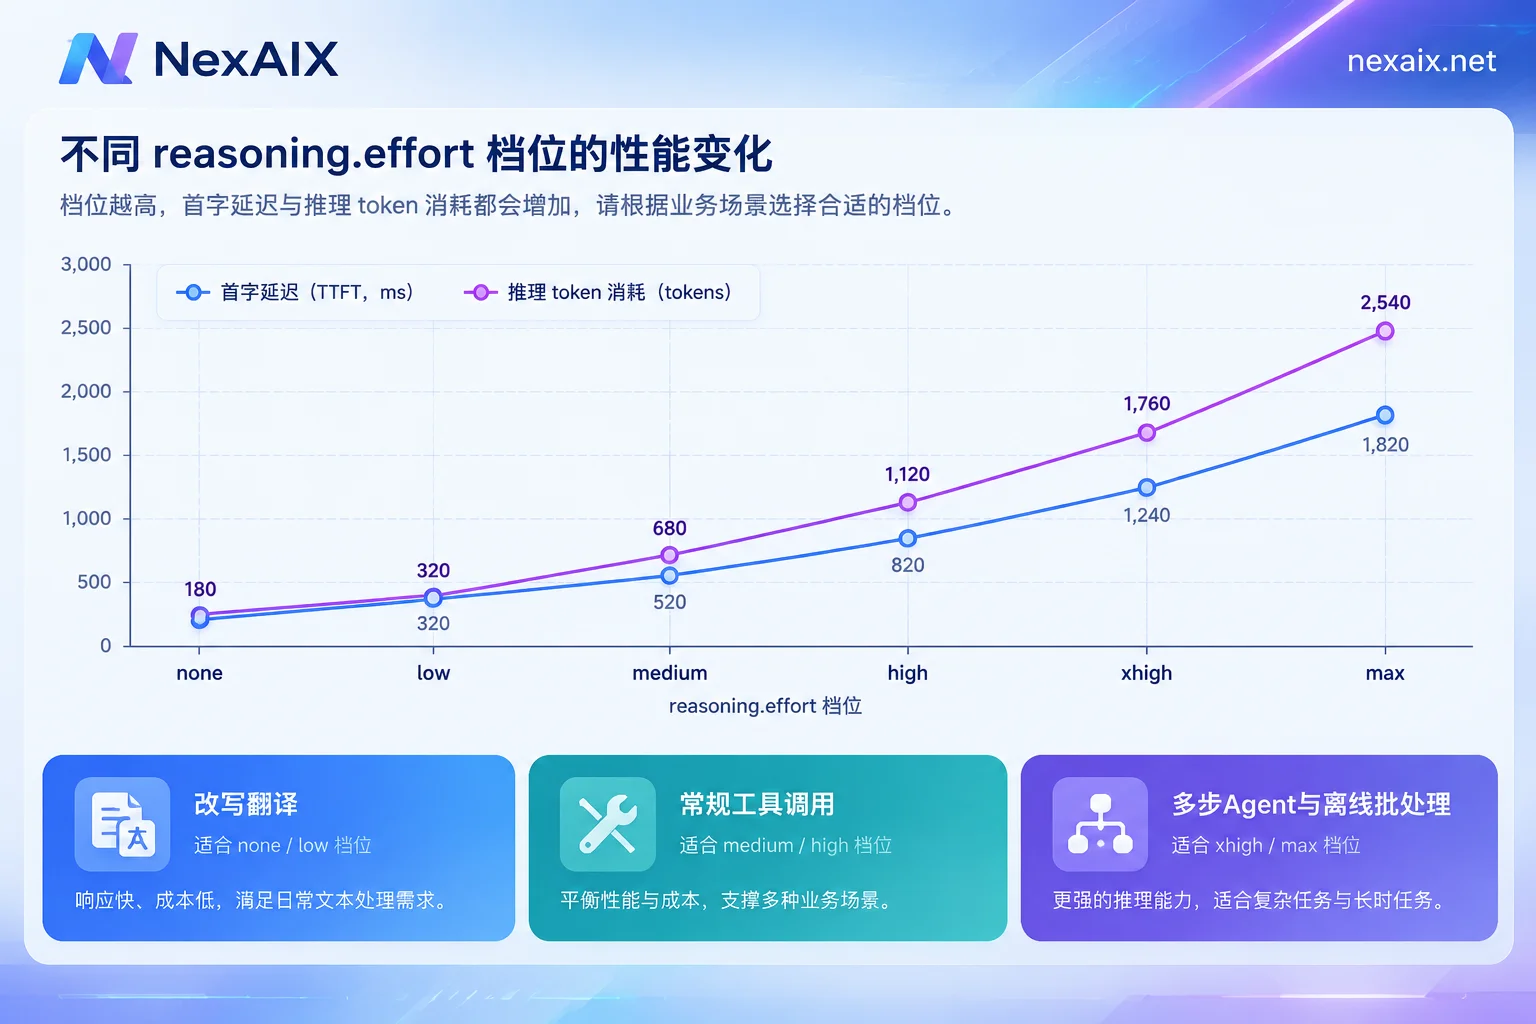
Terra 支持分档推理控制,取值为 none、low、medium(默认)、high、xhigh、max。
{
  "model": "gpt-5.6-terra",
  "reasoning": { "effort": "high" },
  "messages": [...]
}选择依据不是"任务重要不重要",而是这个任务需要几步才能做对,以及做错的代价由谁承担:
none/low:改写、翻译、格式转换、单轮问答。答案基本由输入决定,多想无益。medium(默认):常规工具调用、中等复杂度的代码补全、字段抽取。大多数线上流量停在这一档就够。high及以上:需要多步规划的 Agent、跨文件代码改动、有隐含约束的结构化提取。medium 以上的强度在这几类任务上提升明显。xhigh/max:留给离线批处理、评测回归、人工兜底成本很高的关键决策,不适合放在同步的交互路径上。
代价有两个,都会打到生产指标上。一是推理阶段产生的 reasoning token 计入输出侧消耗,档位越高账单越厚;二是首字延迟(TTFT)被拉长——模型在出第一个可见 token 之前可能思考很久。如果你的前端有"3 秒没响应就报错"的逻辑,或者网关设了较短的读超时,高档位下会出现大量看起来像超时、实际上模型还在正常工作的失败。
务实的做法是分路由:同一个应用里,把简单请求和复杂请求用不同 effort 发出去,而不是全局调一个值。
长上下文和 128k 输出的工程处理
百万级窗口不代表应该塞满。把 80 万 token 的文档整个灌进去,延迟和成本都会失控,而且模型对中段信息的召回未必优于先做检索再喂片段。合理的顺序仍然是:能检索就检索,检索不准再扩大窗口,最后才考虑全量塞入。
输出侧的 128k 是真正需要改配置的地方:
开流式。 非流式请求下,一次长输出可能几分钟才返回完整响应体,中间任何一层网关(Nginx、Cloudflare、云负载均衡)达到读超时都会切断连接,而 token 已经消耗了。stream: true 让数据持续流动,同时把 Nginx 的 proxy_read_timeout、SDK 的 timeout 一并调大。SSE 解析和代理层卡顿的具体排查,可以参考流式输出 API 怎么接。
显式设 max_output_tokens,并检查 finish_reason。 不设上限意味着一次意外的长输出可能烧掉预期几十倍的额度。设了上限就要在客户端判断 finish_reason == "length",触发续写或告知用户,而不是把截断的半截 JSON 直接丢给下游解析。
利用 prompt caching。 多轮对话和 Agent 状态维护会反复发送相同的系统提示与工具定义,把这些稳定内容固定放在消息序列最前面、不要在中间插入变动字段,缓存命中率才上得去,长提示的重复计费和首字延迟都会下降。
注意推理档位和流式的叠加效应。 高 effort 下,流开启后可能有较长一段时间只有心跳没有内容 token,客户端的"无数据超时"要按最慢情况设,不要按平均值。
四项验证:确认模型没被降配
走第三方端点最该防的三件事是换小模型、降精度、砍上下文。这几项从单次返回里看不出来,得主动测。
第一,回显核对。 每次响应的 model 字段是否与请求一致。如果请求 gpt-5.6-terra 而回显是别的标识,或者干脆是个内部别名,就要问清楚背后路由到了哪里。这一层只能排除最粗糙的替换,通过了不代表没问题。
第二,长上下文边界测试(NIAH)。 构造 20 万、50 万 token 级别的输入,在开头、中段、接近尾部三个位置各埋一句无法被推理出来的事实(比如一串随机码),然后提问。若尾部或中段的标记完全召回不到,而输入长度本应在窗口内,说明上下文可能被提前截断或做了压缩。这个测试要在接入初期跑一次,之后按月抽测。
第三,推理 token 核对。 同一组提示,分别用 low 和 high/max 发出,观察返回用量里的 reasoning token 数量是否随档位明显上升,以及复杂逻辑题的答案质量是否同步改善。如果高档位既不多花推理 token、答案也没变化,说明 effort 参数可能没有真正透传到上游。
第四,固定回归集。 挑 20~50 条覆盖你实际业务的样本,记录初次接入时的输出与用量基线,之后定期重跑对比。单次输出的随机性掩盖不了系统性降配,多条样本的整体偏移会暴露出来。
NexAIX 这边公开的承诺就是对着这几项写的:不换小模型、不降精度、不砍上下文,不记录对话内容(请求结束即释放),配额与限速公开,按 API Key 独立隔离配额、权限与用量账单。承诺本身不能替代验证,对应的自查方法都列在平台优势页,建议照着跑一遍再把流量切过去。更通用的中转端点风险清单,见API 中转站选型三大工程风险。
上线前还要处理的两件事
一是限流。Terra 的长请求占用时间久,同样的 RPM 下并发压力和短请求完全不同,接入前先按公开的配额和限速算清楚你的峰值能不能过。429 的标头解读和退避策略见 AI API 限流怎么处理。
二是重试边界。长输出流式请求中途断开时,盲目整条重试会把已经产生的 token 再花一遍;哪些错误该重试、流式中断怎么接续,AI API 重试怎么设计里有具体判断条件。
真正要上线之前,先用测试额度把上面的验证跑完——注册即可获得,不需要企业资质。把 NIAH、推理档位对照和回归集这三项结果留档,后续任何一次"模型好像变笨了"的怀疑,都有基线可比。


评论(0)