只是一个默认分类
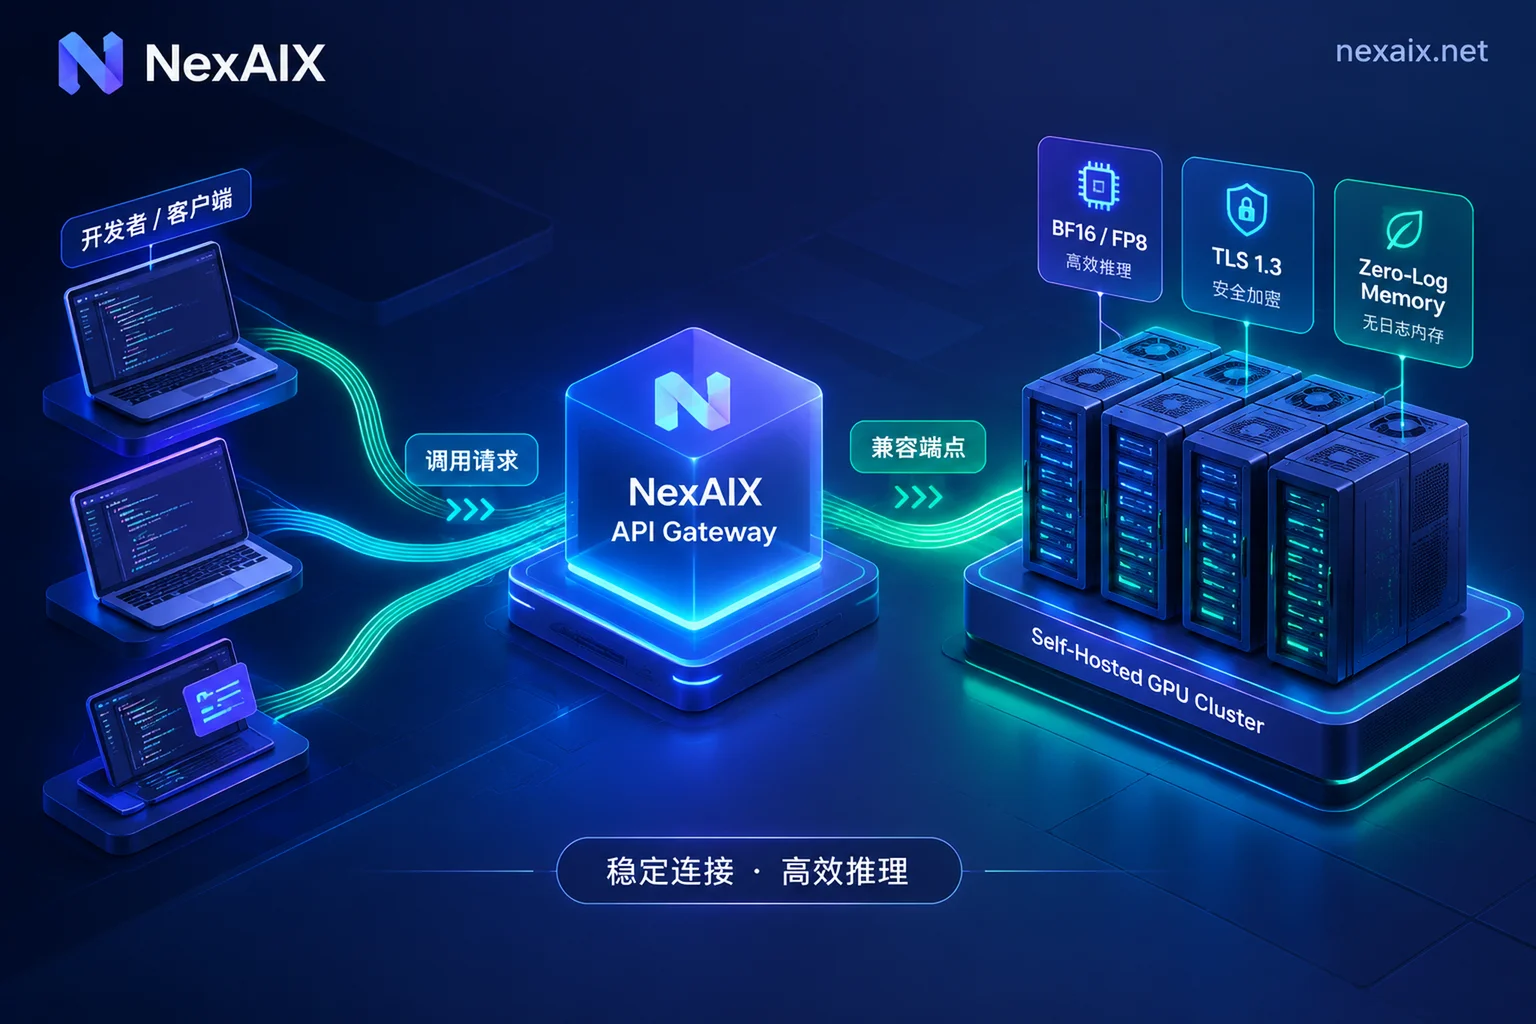
随着千亿参数 MoE 开源权重模型在编码和 Agent 场景追平前沿闭源模型,越来越多团队将日常流量切向开源大模型 API。本文拆解自建 GPU 推理的隐性门槛,剖析二手额度转售与隐蔽降配的风险,并给出基于自有算力部署、零日志与单端点混合调用的生产级选型清单。
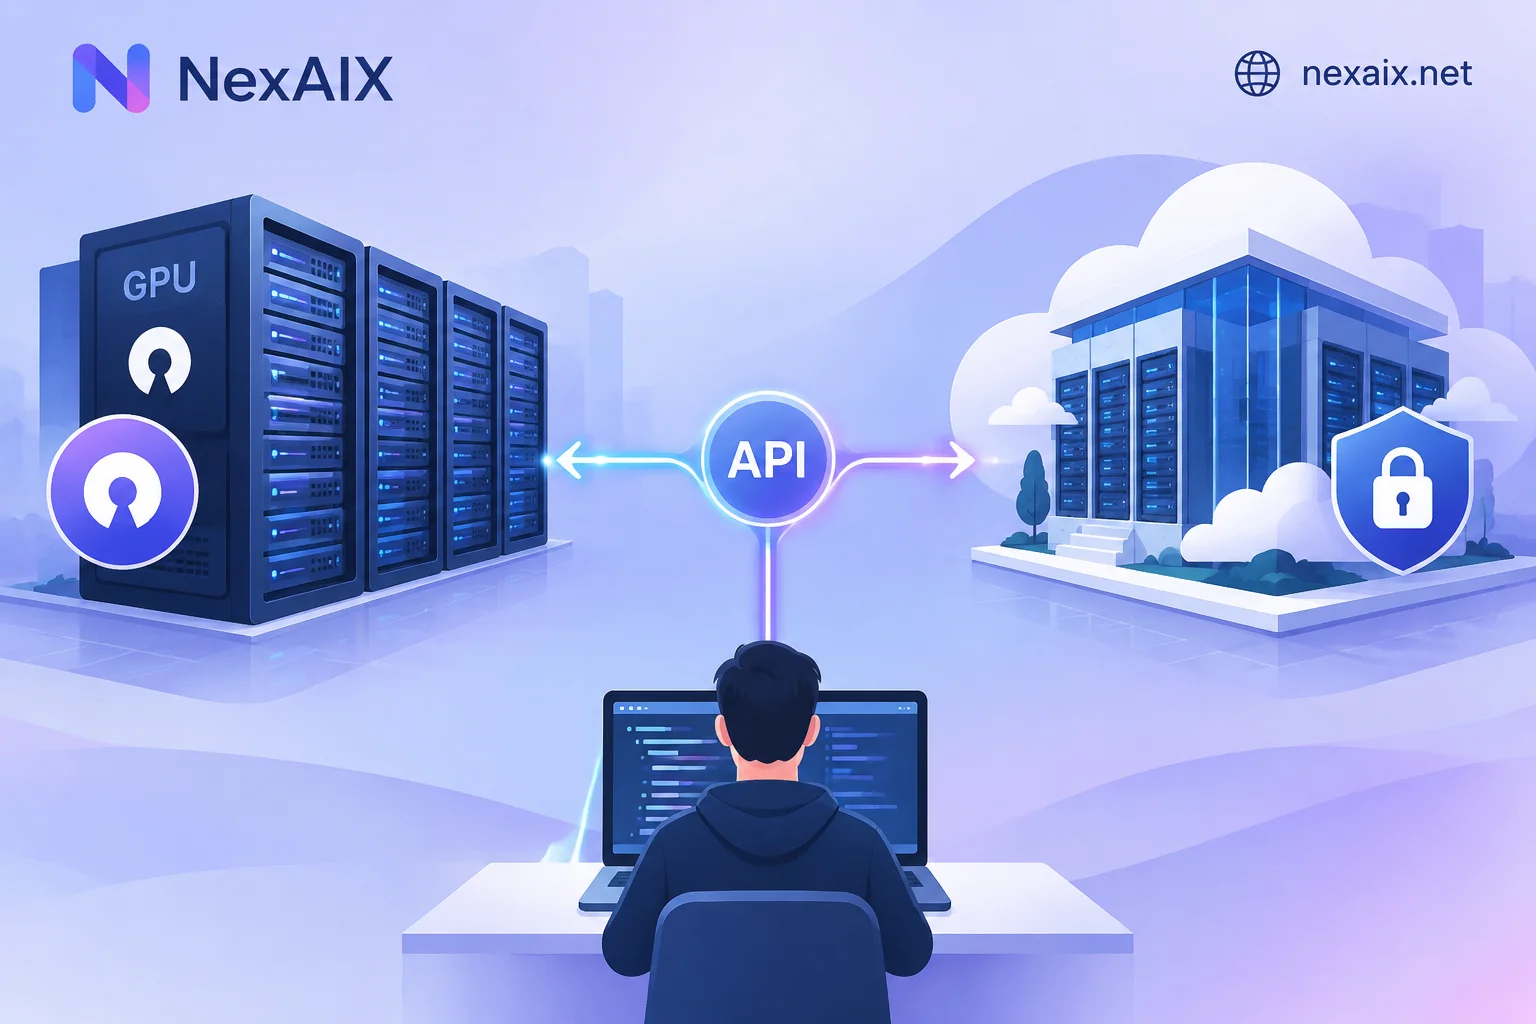
两类 API 接口格式可以一样,真正的区别在于推理由谁来跑。开源权重模型由服务方自己部署,精度、上下文和日志策略由部署方决定。闭源模型只能由原厂推理,渠道需要确认是否真的走官方,留存和限流要看原厂条款。本文按精度、上下文、数据留存、限流延迟四项拆开说明,并给出选择场景和接入前的核对步骤。
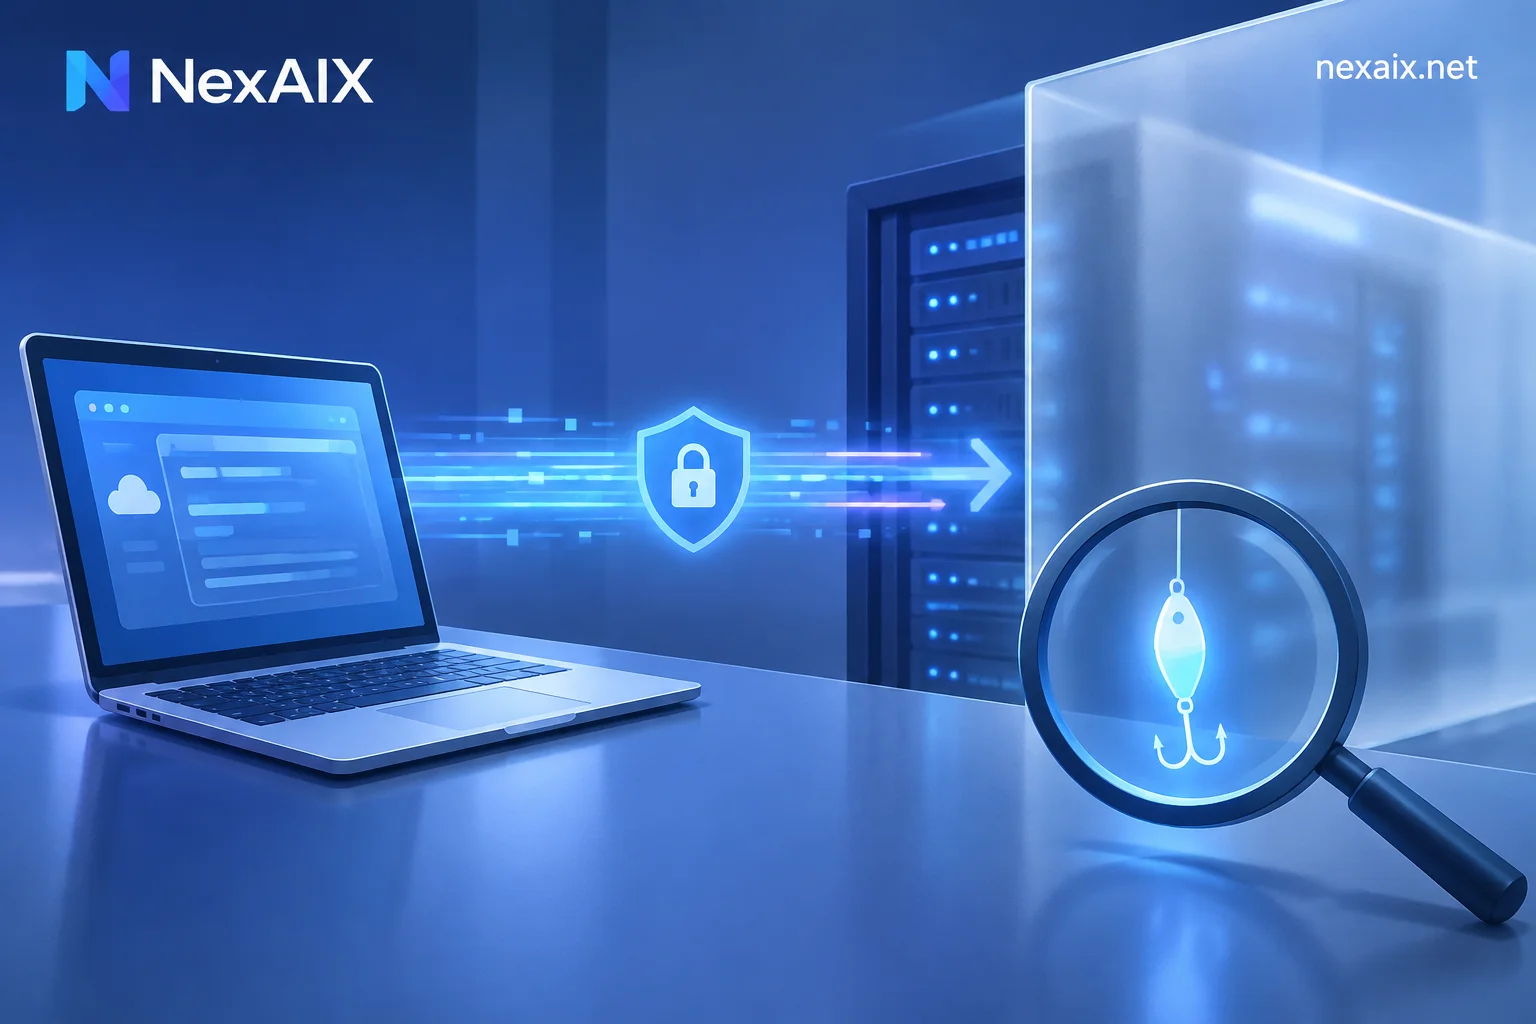
仅凭客户端,无法直接证明服务端没有把对话写入日志。本文说明哪些检查能提供有效证据:核对控制台日志字段、阅读数据留存政策、用金丝雀诱饵检测泄露、排查自己链路上的记录点,以及在出域前做脱敏。
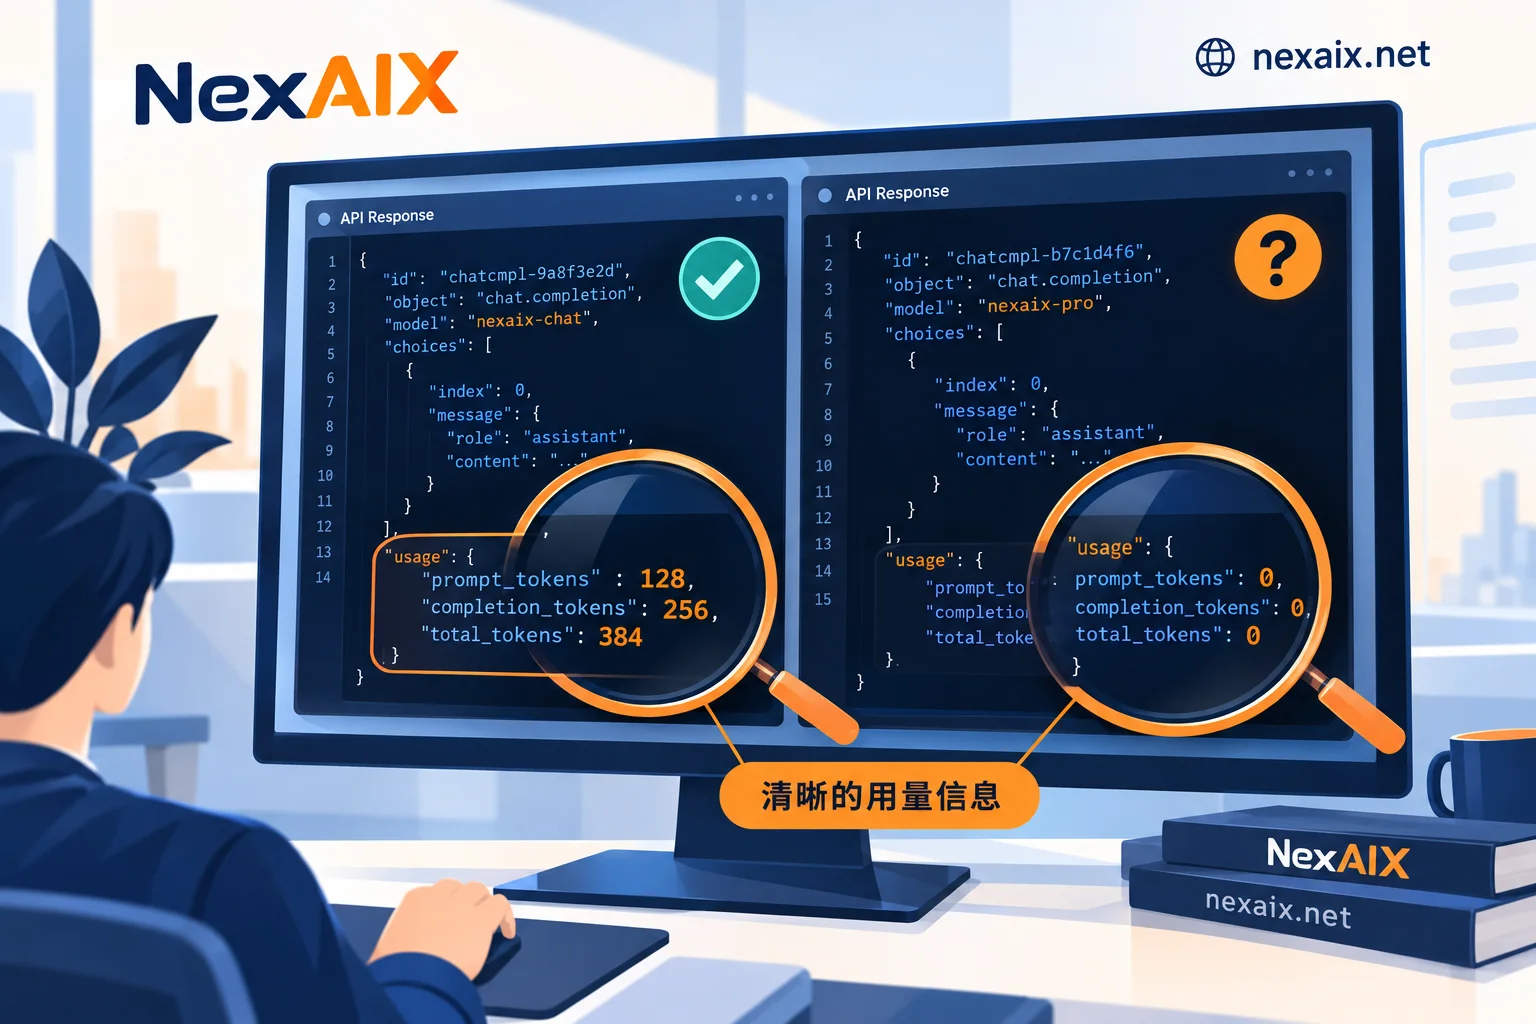
直接问模型“你是谁”不能验真。本文给出一套可执行的交叉检查:核对响应字段与 usage,用固定探针对比能力,做长上下文压测,再参考首字延迟和解码速度,并说明每种方法的边界和适用场景。
BF16 和 FP8 的区别主要在每个数值占的位数。FP8 能让权重和 KV 缓存的显存占用约减半,在支持原生 FP8 的 GPU 上还能提高吞吐;BF16 数值更稳定,适合代码、数学推导和结果对齐。本文按显存、速度、质量和硬件四项说明差异,给出自部署和 API 调用两种情况下的选择方法,以及验证模型是否降精度的步骤。
0 条留言
 NexAIX-官方博客